第七章 · 多媒体数据压缩编码技术基础(中) — 考点分组解析(样稿)
42 题按考点归类,同考点题目聚在一起:每题为 题干 + 答案 + 解析 + 易错提示 + 关联题 + 讲义原页对照
42题目数
15个考点
易错提示 42 条
逐题讲义对照
香农费诺编码题 1–2 · 2 题
11分香农费诺编码讲义第69页
有信源字符序列S为:aaabbceeehddabafffbdddgghhabccedabdgghha其长度为40个字符,由a、b、c、d、e、f、g、h共8种字符构成。假设在编码之前,每种字符出现的概率已由某种模型统计出来,用<字符>-<出现次数>来表示,具体值分别为:a-8,b-6,c-3,d-7,e-4,f-3,g-4,h-5,如果利用香农费诺编码,则需要( )位二进制表示?A. 320B. 118C. 288D. 120
参考答案:B
◆ 考点:香农-费诺(Shannon-Fano)编码:先把信源符号按概率递减排序,再上下二分使两部分概率和接近,上编0、下编1,重复到每个符号单独成叶;概率越大码长越短(讲义P65)。
◆ 判定:按例题树逐步编码后,各符号码长×出现次数求和,总位数=118位 → B。A(320)是不压缩的定长8位×40、C(288)、D(120)均为干扰。
⚠ 易错提示:香农-费诺是无损统计编码;别把“总位数”算成定长码长×字符数(320),要按各符号实际码长加权求和。
🔗 关联题:第2题(同考点,建议对比记忆)
讲义原页对照 第69页 · 香农费诺编码
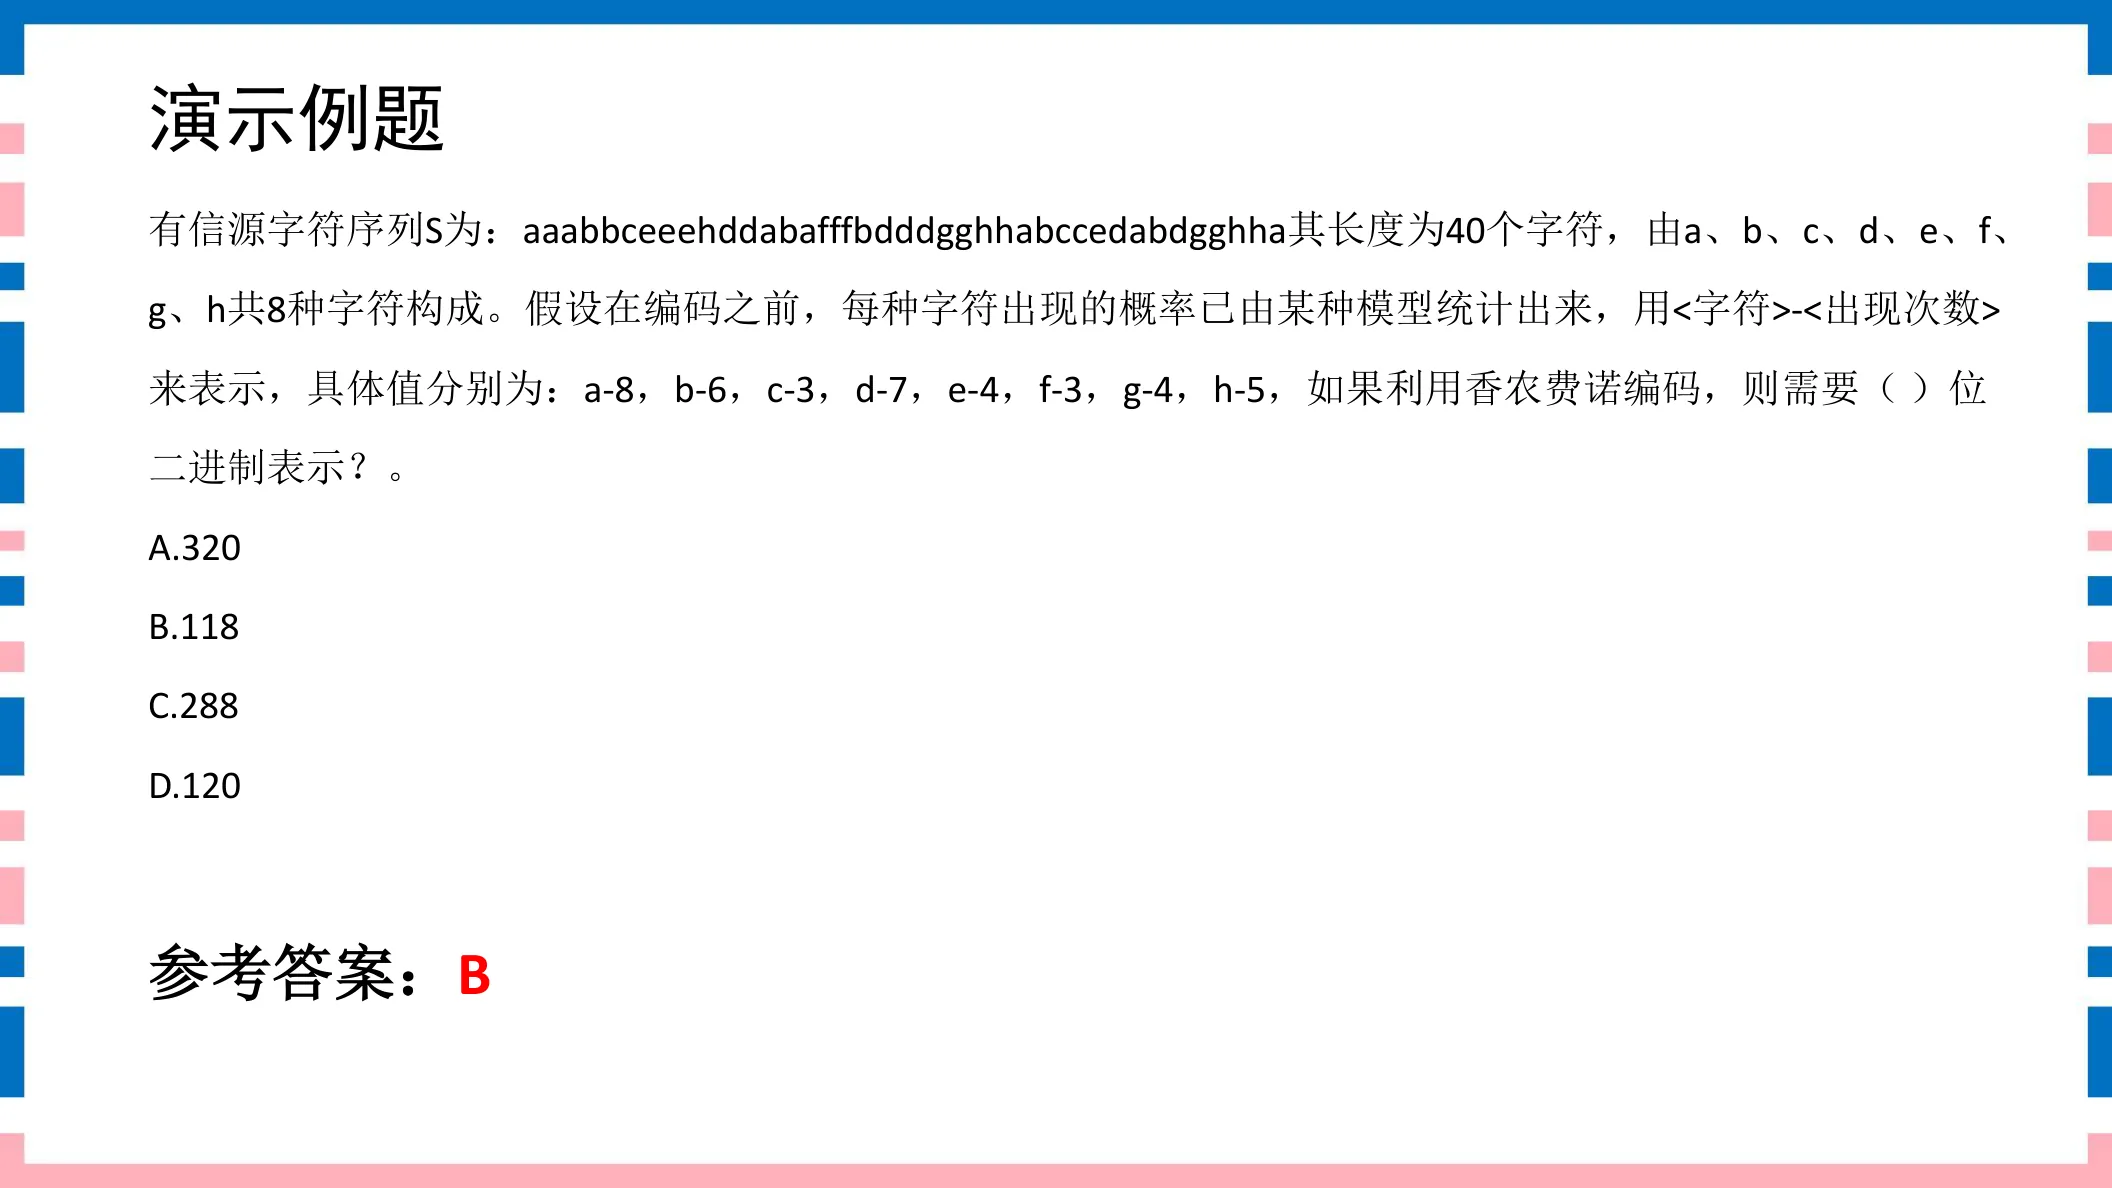
点击图片可弹层放大查看讲义原页
21分香农费诺编码讲义第86页
香浓-费诺编码的目的是产生具有最小冗余的码词,结果是( )。A. 符号出现的概率越大,其码词的长度越短B. 符号出现的概率越小,其码词的长度越短C. 符号出现的概率越大,其码词的长度越长D. 符号出现的概率与其码词的长度无关
参考答案:A
◆ 考点:香农-费诺目的是产生冗余最小的码词,结果是符号出现概率越大,码词长度越短(讲义P65)。
◆ 判定:与讲义原文一致 → A。B/C把长短说反,D说无关均错。
⚠ 易错提示:香农-费诺与霍夫曼同规律:概率大→码长短。“概率小码词短”是经典颠倒项。
🔗 关联题:第1题(同考点,建议对比记忆)
讲义原页对照 第86页 · 香农费诺编码
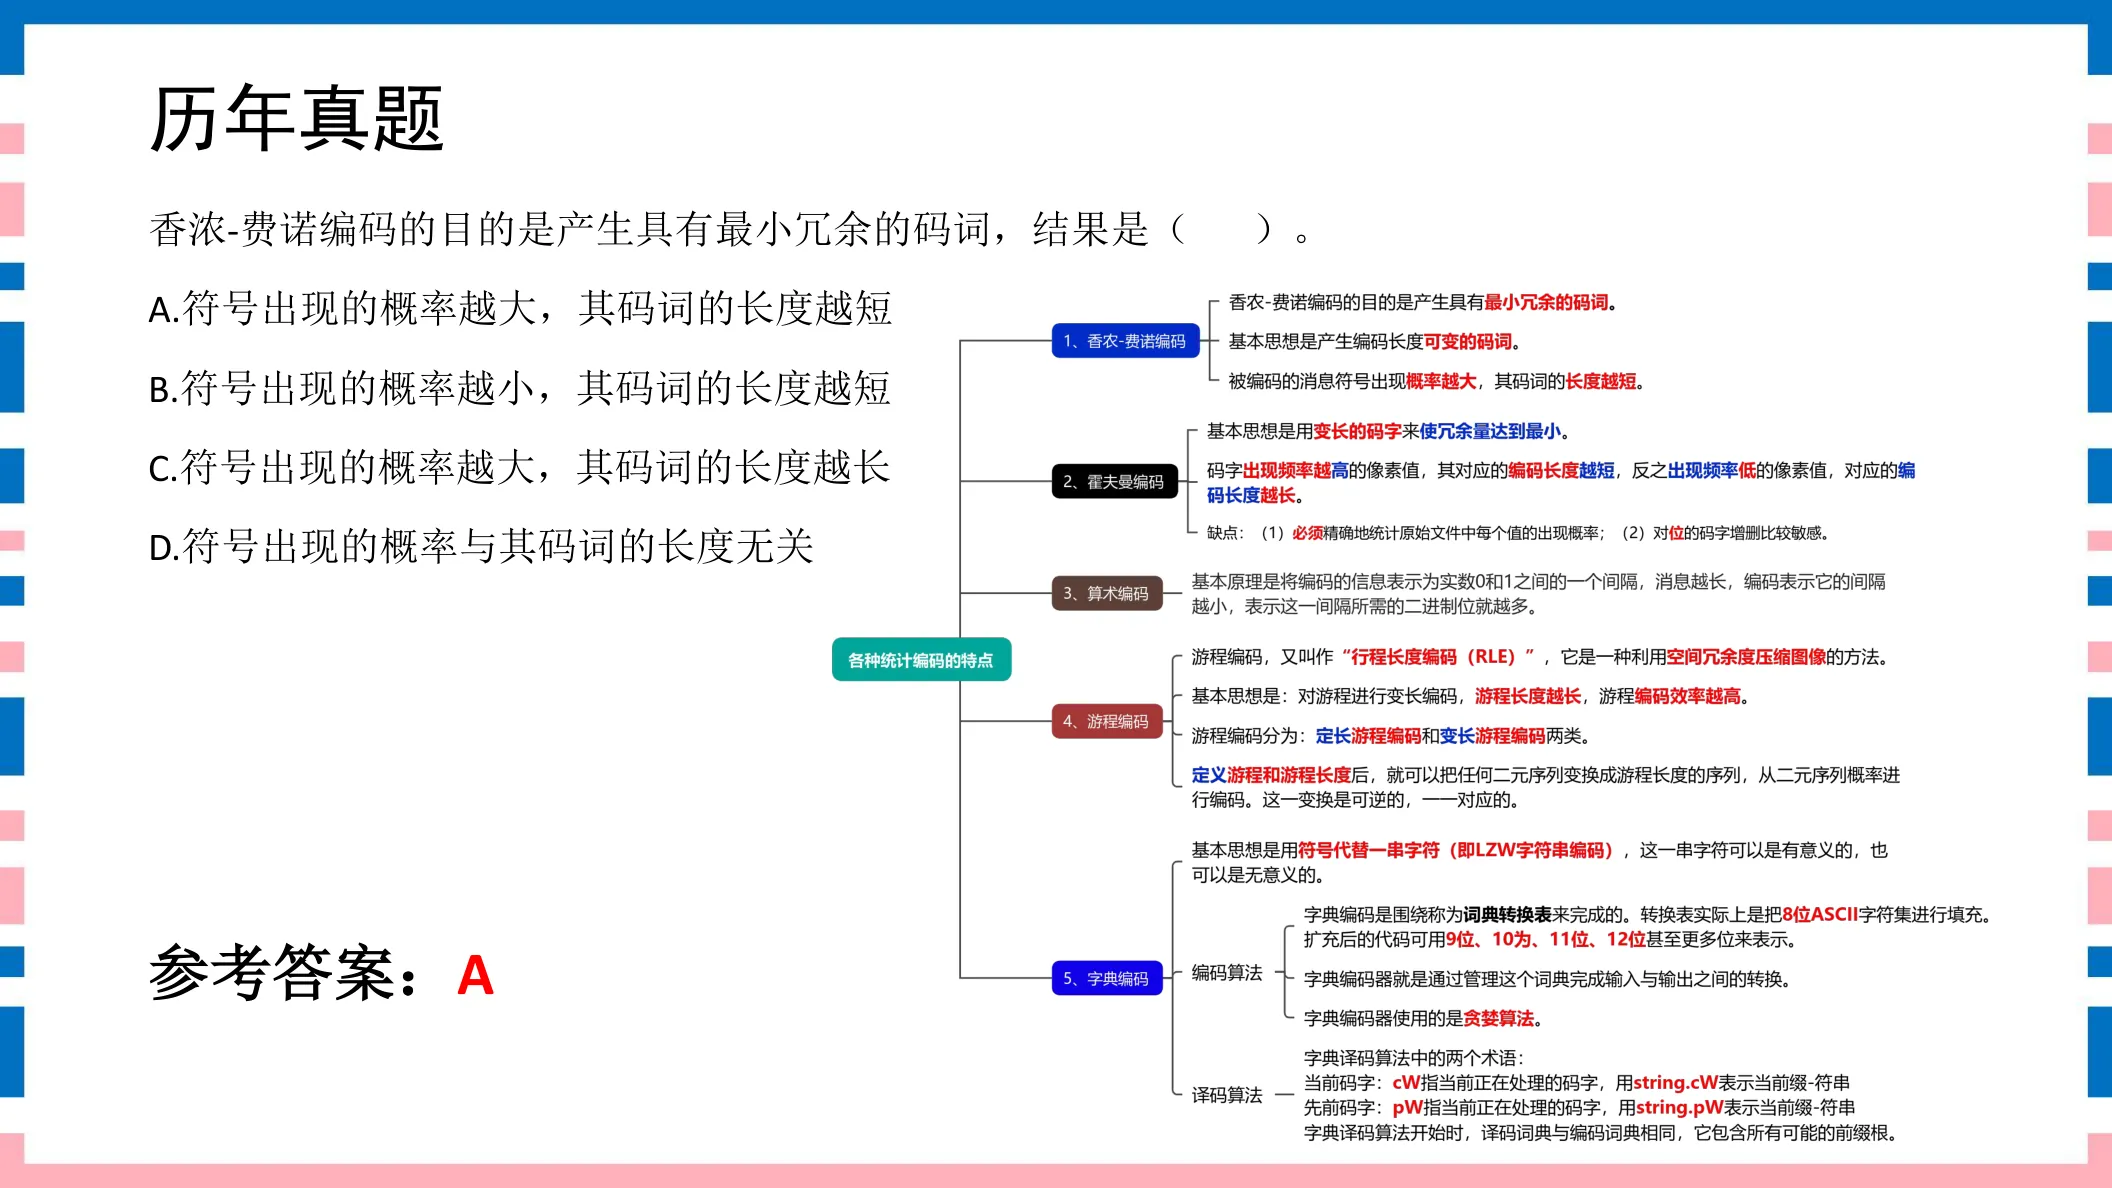
点击图片可弹层放大查看讲义原页
霍夫曼编码题 3–6 · 4 题
31分霍夫曼编码讲义第73页
设有编码输入X={x1,x2,x3,x4,x5}。其频率分布为P(x1)=0.4,P(x2)=0.3,P(x3)=0.1,P(x4)=0.1,P(x5)=0.06,P(x6)=0.04,现求其最佳霍夫曼编码w{w1,w2,w3,w4,w6,w6},平均码长为( )bit。A. 2.1B. 2.2C. 2.3D. 2.4
参考答案:B
◆ 考点:霍夫曼(Huffman)编码:每次合并两个最小概率符号,概率大的符号码长越短,按教材例题得各符号码字后,平均码长=ΣP(xi)·Wi(讲义P71、P72)。
◆ 判定:代入 0.4×1+0.3×2+0.1×3+0.1×4+0.06×5+0.04×5=2.2 bit → B。
⚠ 易错提示:平均码长是概率×码长加权和,不是简单取码字位数的平均;注意例题里 x5、x6 概率为0.06/0.04 对应最长码字。
讲义原页对照 第73页 · 霍夫曼编码
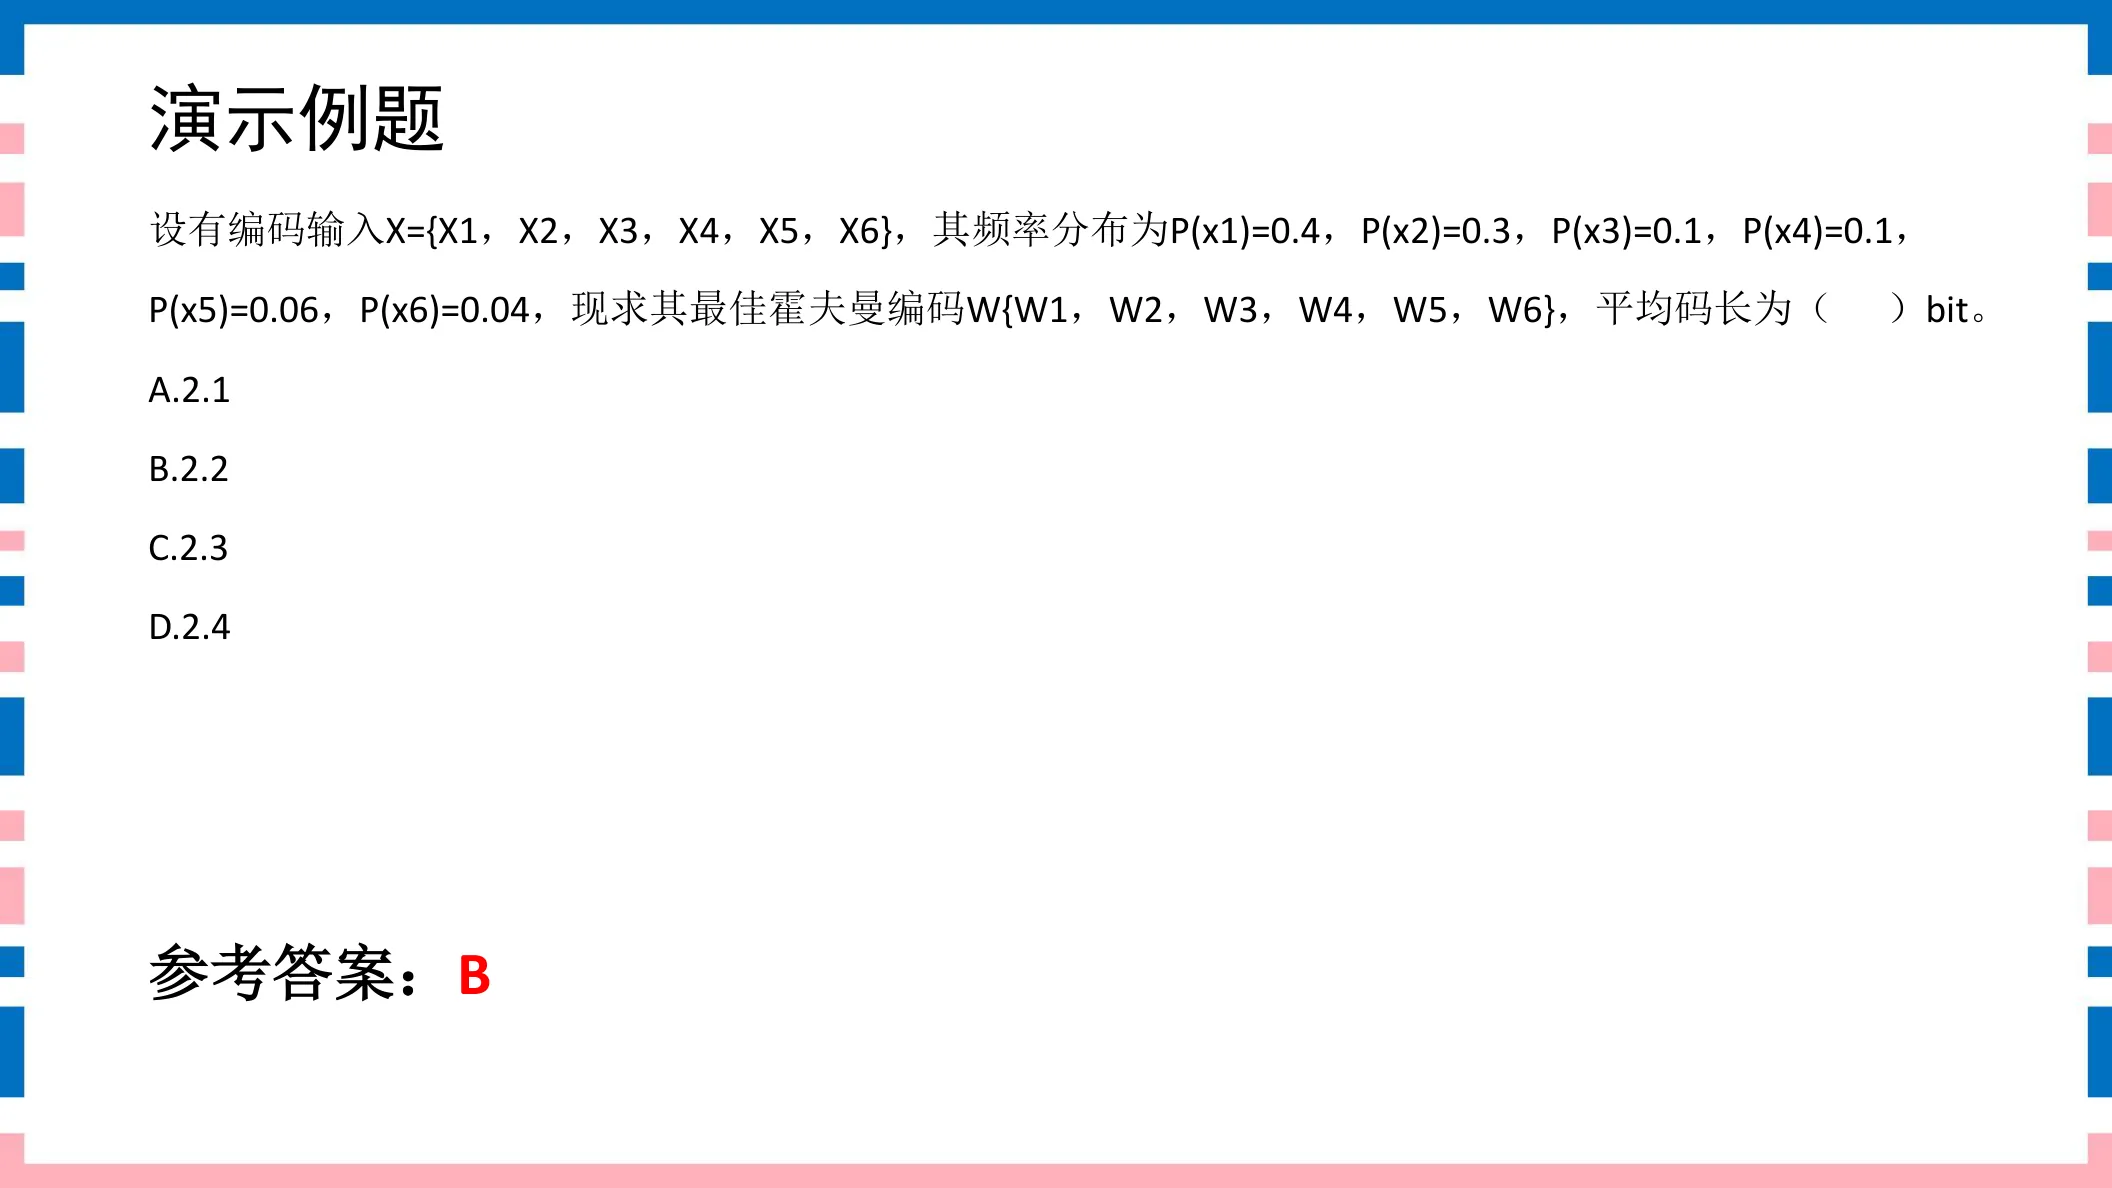
点击图片可弹层放大查看讲义原页
41分霍夫曼编码讲义第85页
以下关于哈夫曼编码错误的是( )。A. 用变长的码字来使冗余量达到最小B. 是一种无损压缩方法C. 码字出现频率越高的像素值,其对应的编码长度越长D. 编码过程中需要根据符号出现的概率来进行编码
参考答案:C
◆ 考点:霍夫曼用变长码字使冗余最小,是无损压缩,需按符号出现概率编码;出现频率越高的符号编码长度越短(讲义P71)。
◆ 判定:C说“频率越高码长越长”,正好说反 → 为错误项。A/B/D均与讲义一致。
⚠ 易错提示:记牢方向:概率(频率)越大→码长越短;说反的选项必错。霍夫曼是无损,不是有损。
讲义原页对照 第85页 · 霍夫曼编码
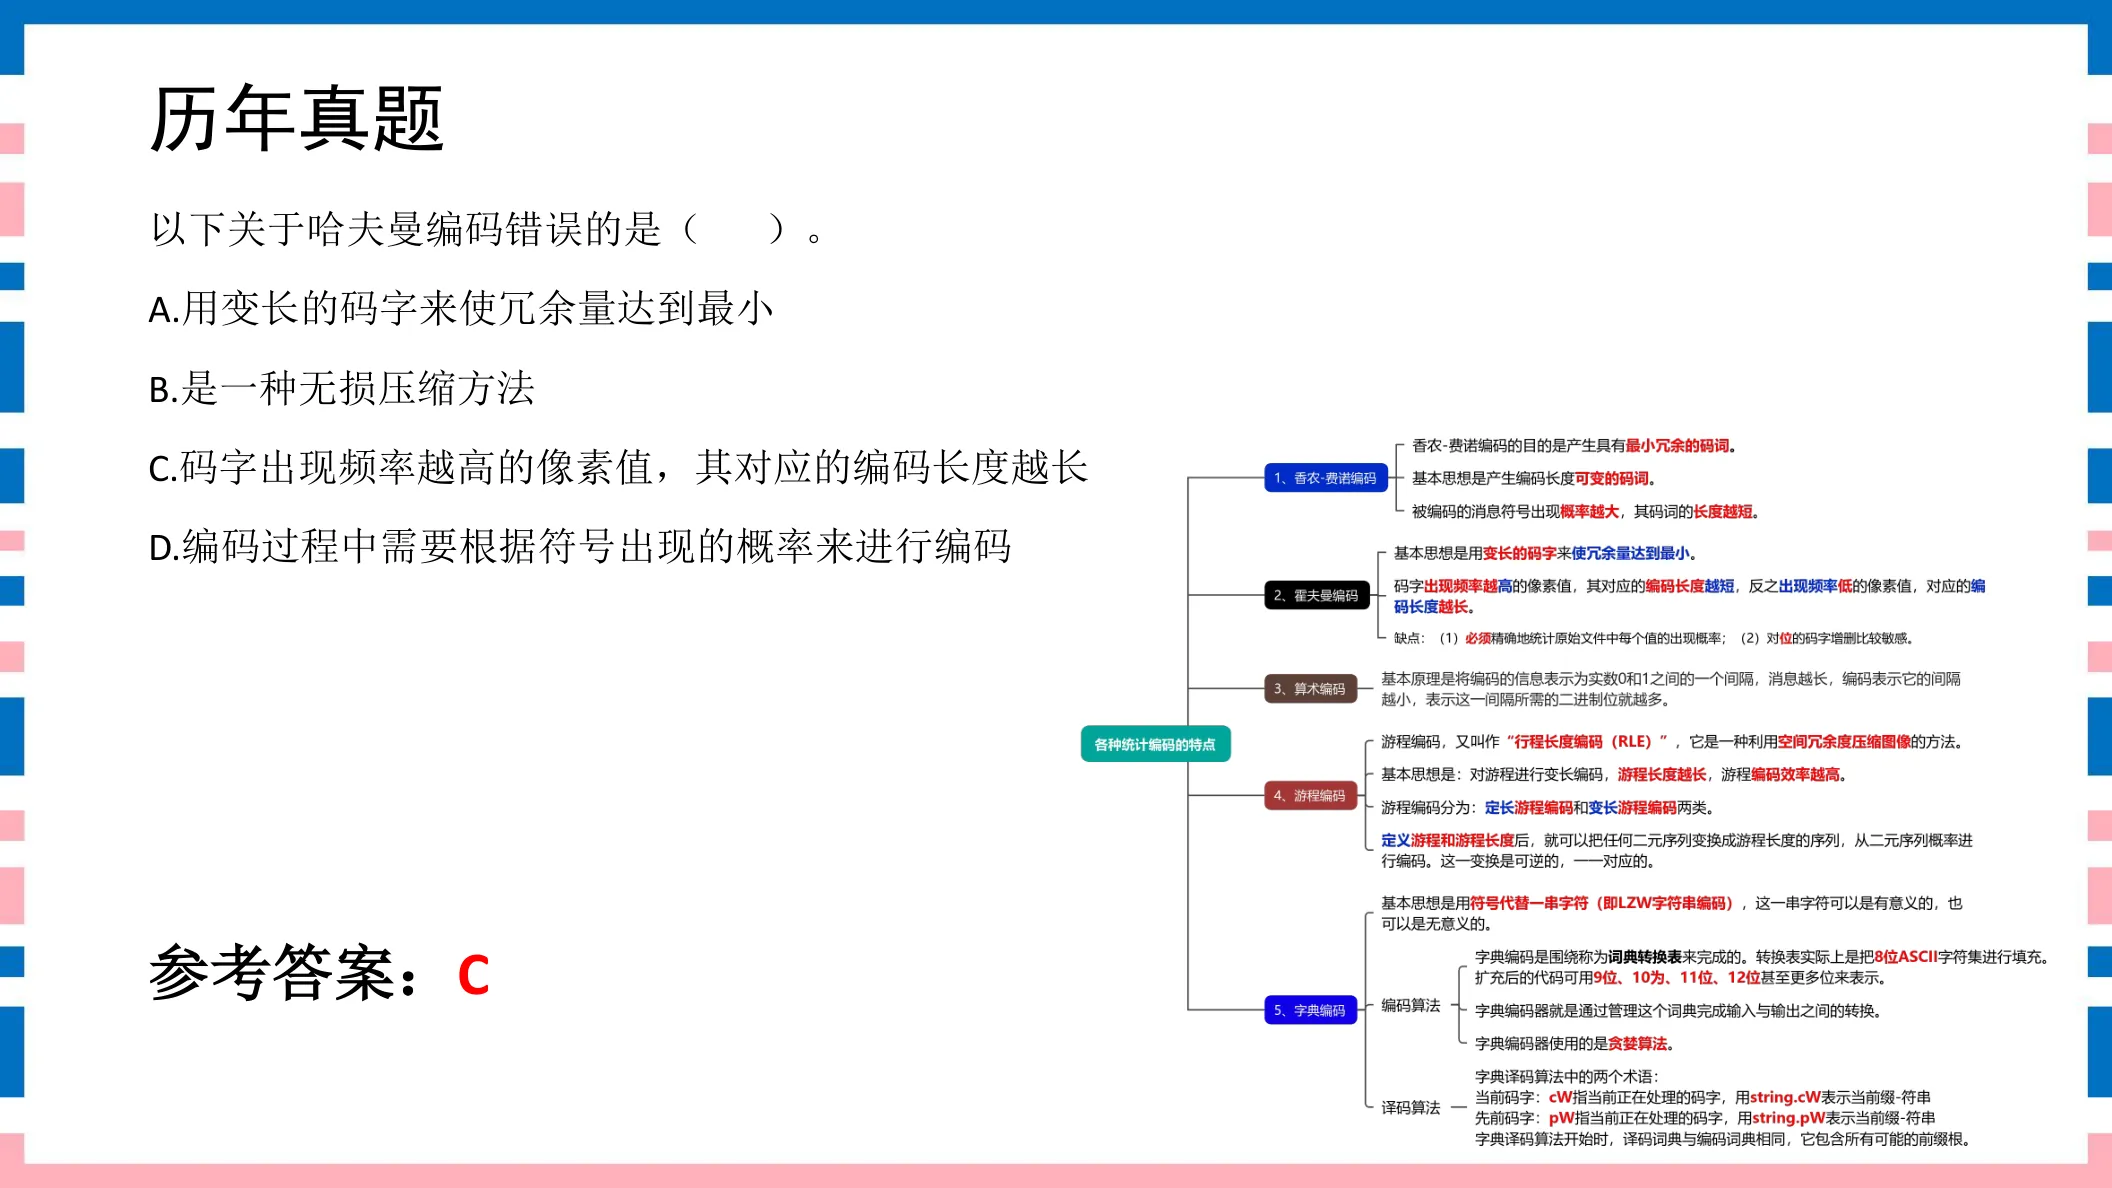
点击图片可弹层放大查看讲义原页
51分霍夫曼编码讲义第91页
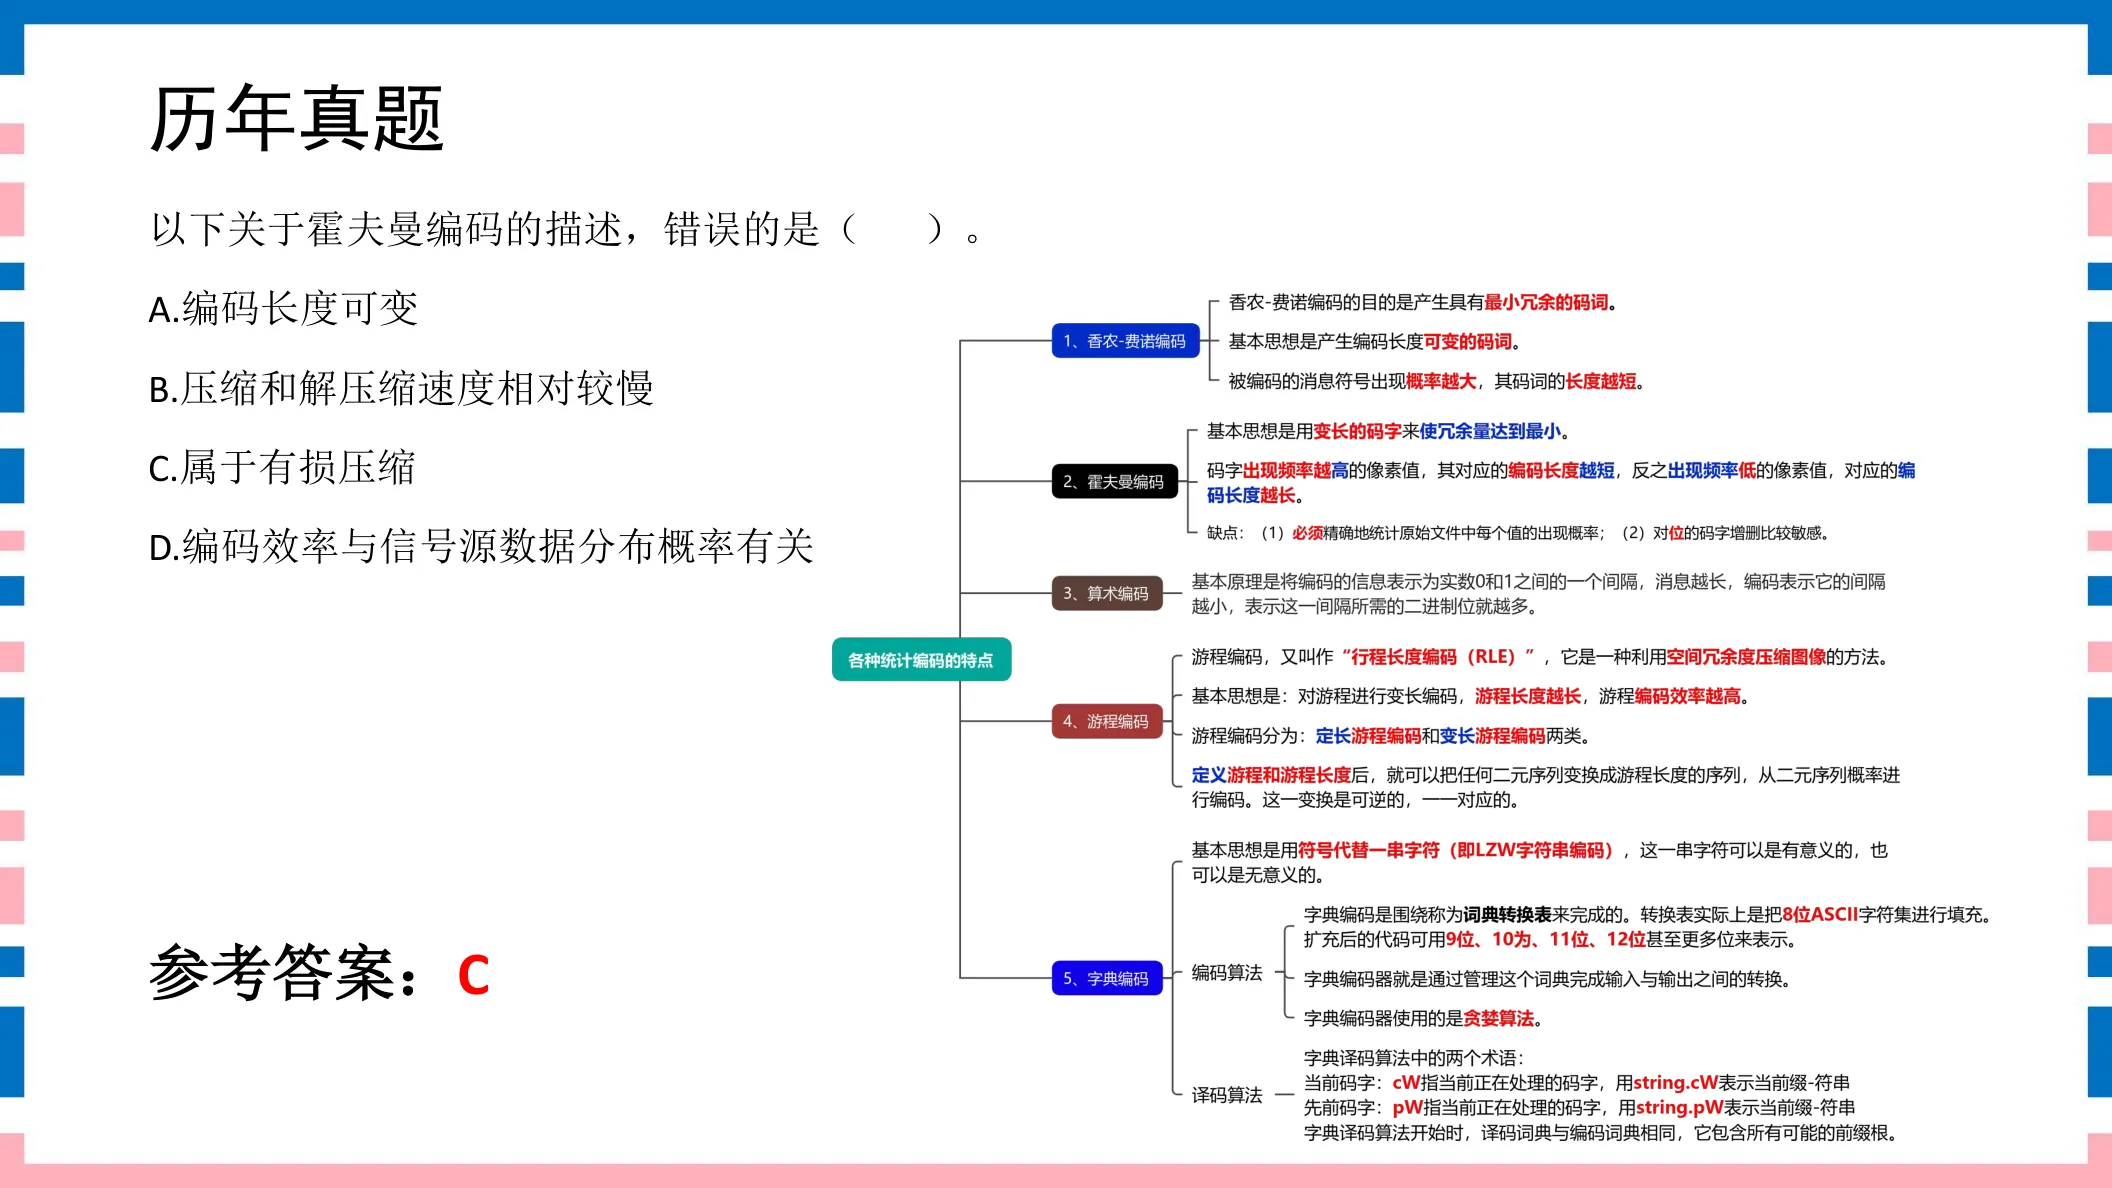
以下关于霍夫曼编码的描述,错误的是( )。A. 编码长度可变B. 压缩和解压缩速度相对较慢C. 属于有损压缩D. 编码效率与信号源数据分布概率有关
参考答案:C
◆ 考点:霍夫曼编码长度可变、编码效率取决于信源概率分布、是无损压缩,因需遍历建树故压缩/解压速度相对较慢(讲义P71)。
◆ 判定:C说“属于有损压缩”错误,霍夫曼是无损 → C。A/B/D描述均正确。
⚠ 易错提示:霍夫曼=无损、变长、按概率;见到“有损压缩”描述它就是错项。
讲义原页对照 第91页 · 霍夫曼编码
点击图片可弹层放大查看讲义原页
61分霍夫曼编码讲义第96页
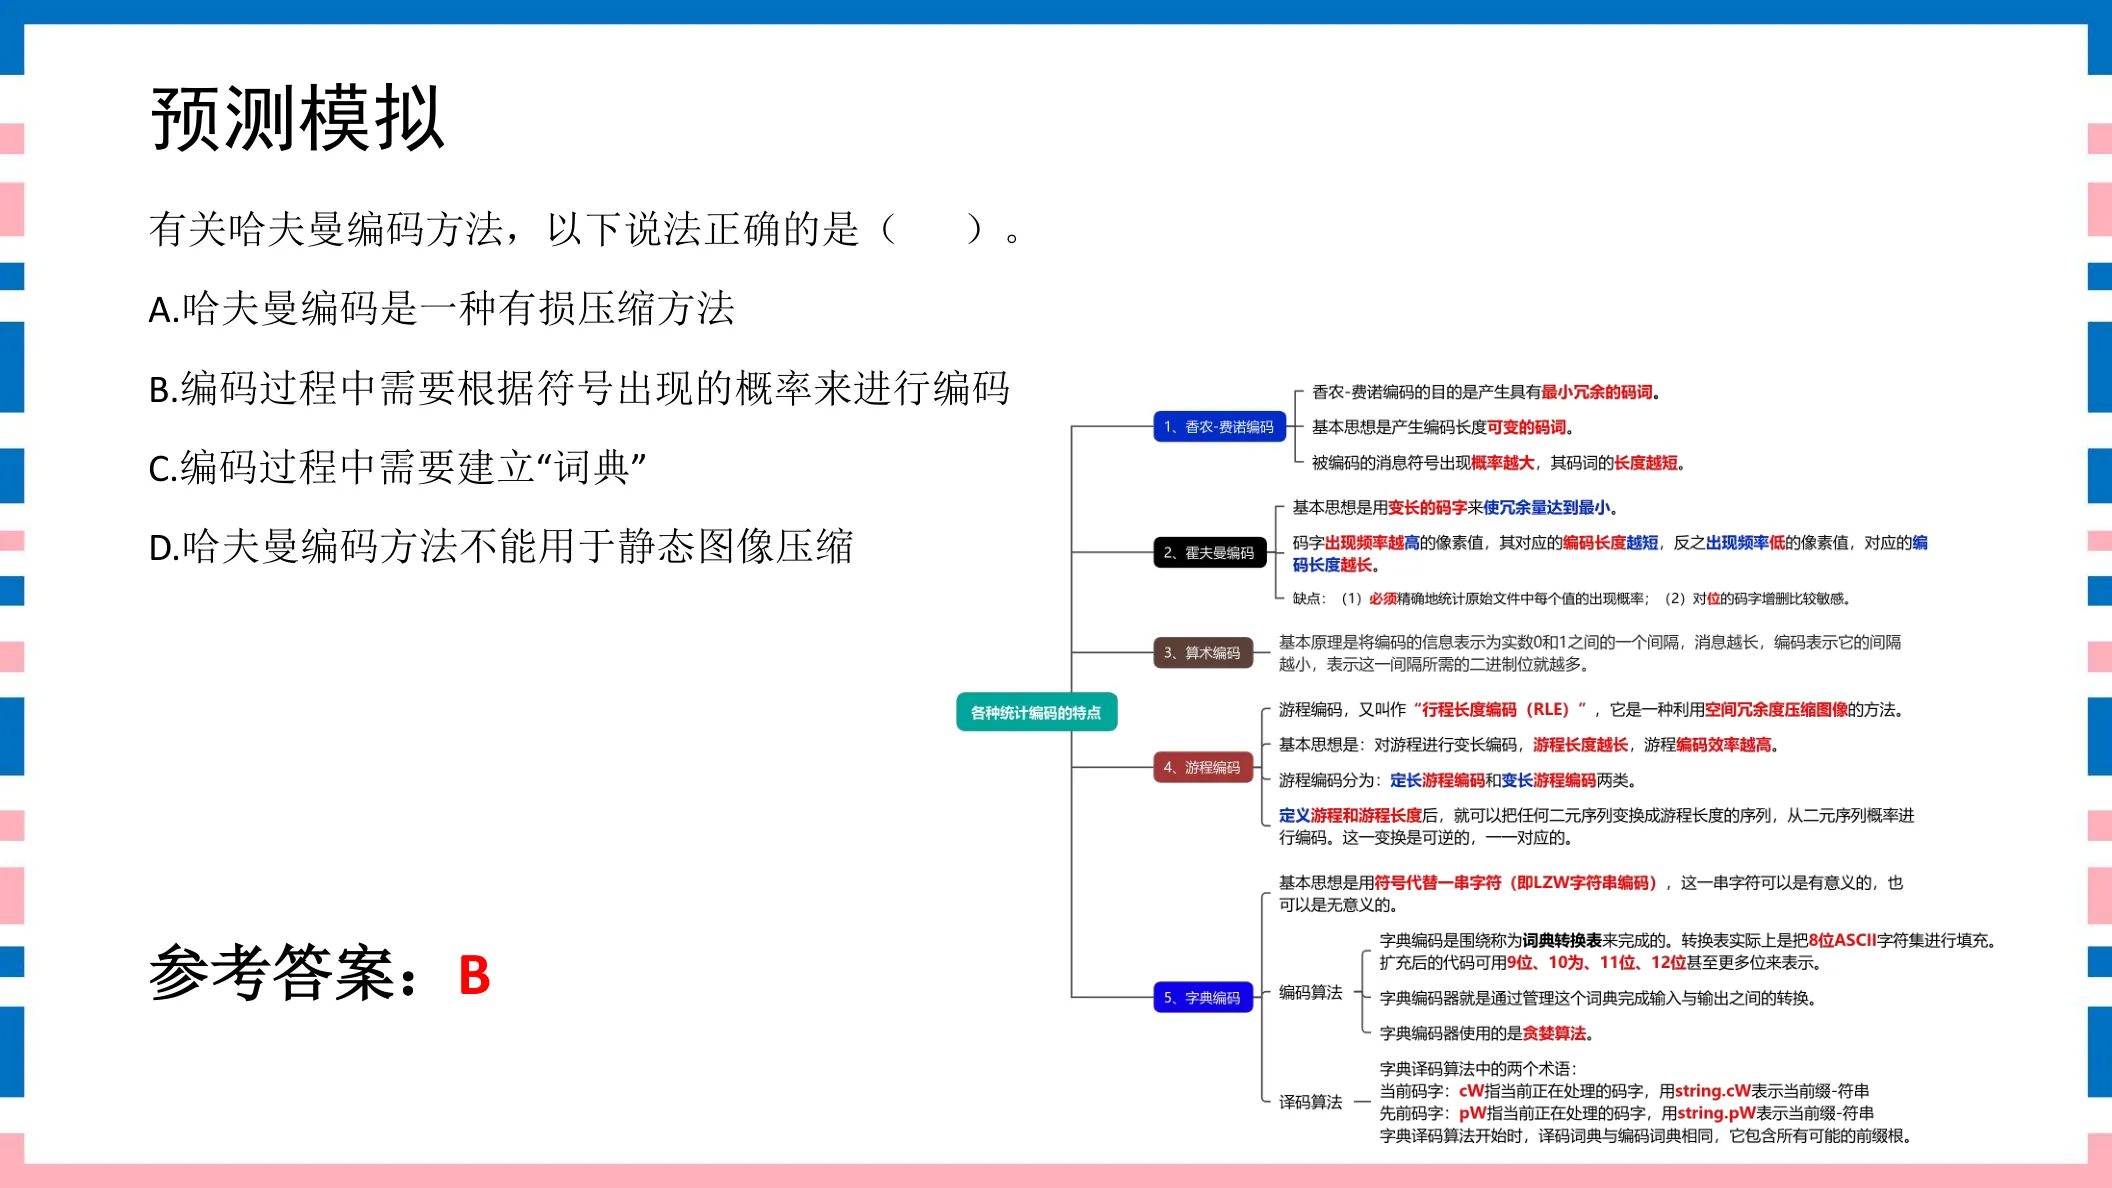
有关哈夫曼编码方法,以下说法正确的是( )。A. 哈夫曼编码是一种有损压缩方法B. 编码过程中需要根据符号出现的概率来进行编码C. 编码过程中需要建立“词典”D. 哈夫曼编码方法不能用于静态图像压缩
参考答案:B
◆ 考点:霍夫曼编码需要根据符号出现的概率来构造码字,是无损压缩,可用于静态图像(讲义P71)。
◆ 判定:B“根据符号概率编码”正确 → B。霍夫曼无损故A错;建词典是字典编码故C错;D“不能用于静态图像”错。
⚠ 易错提示:按概率=霍夫曼/算术;建词典=LZW;按游程=RLE。三种无损统计编码的“抓手”各不相同。
讲义原页对照 第96页 · 霍夫曼编码
点击图片可弹层放大查看讲义原页
算术编码题 7–10 · 4 题
71分算术编码讲义第84页
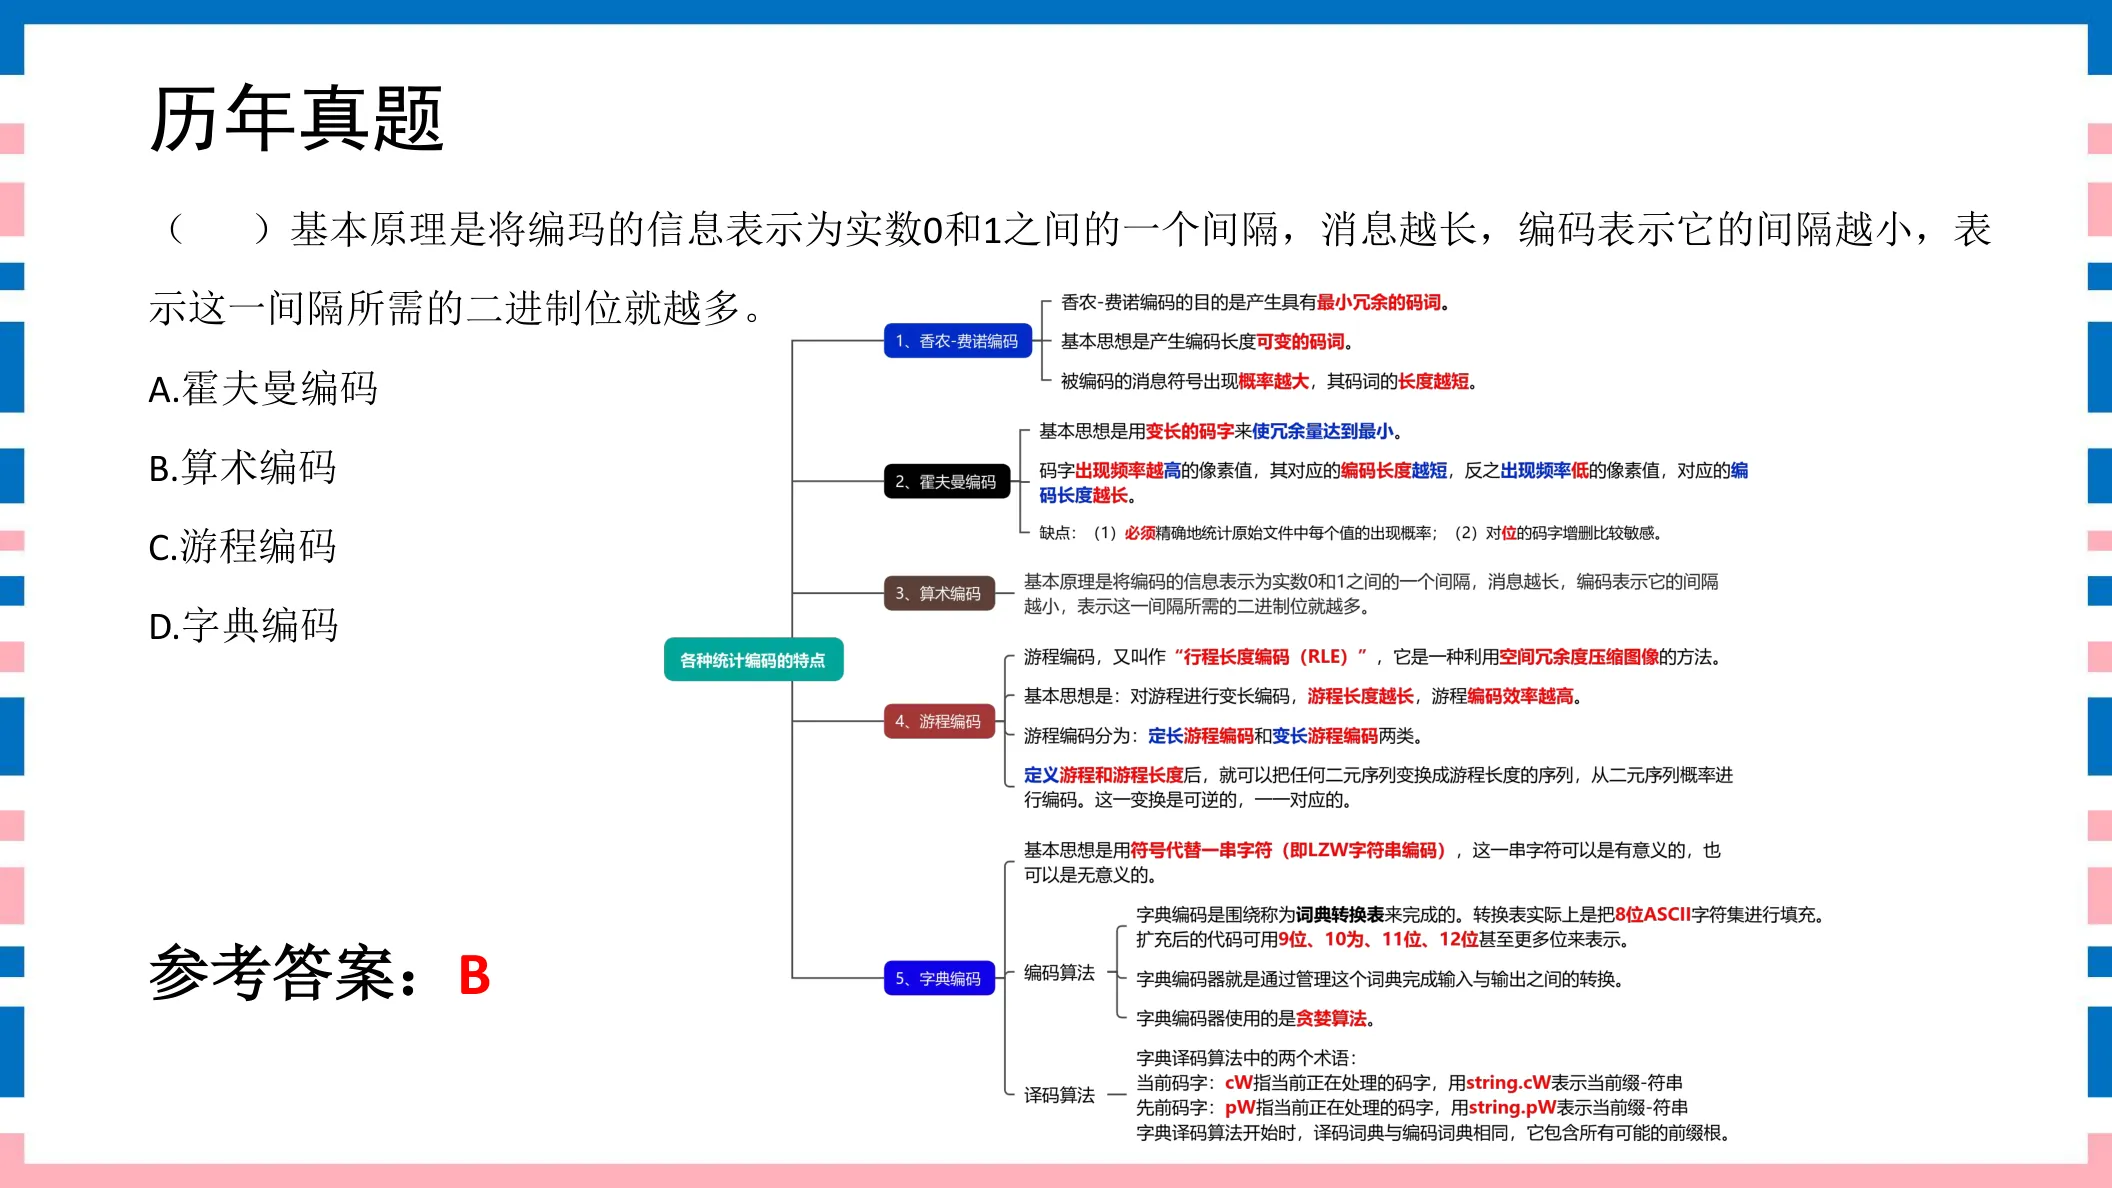
( )基本原理是将编玛的信息表示为实数0和1之间的一个间隔,消息越长,编码表示它的间隔越小,表示这一间隔所需的二进制位就越多。A. 霍夫曼编码B. 算术编码C. 游程编码D. 字典编码
参考答案:B
◆ 考点:算术编码:把整段消息映射到实数[0,1)区间内的一个子区间,消息越长区间越小、所需二进制位越多,一个数值代表整段输入(讲义P76)。
◆ 判定:“信息表示为0和1之间的一个间隔”正是算术编码的标志性描述 → B。霍夫曼/游程是一个符号对应一个码字,字典编码是用符号代替一串字符。
⚠ 易错提示:见到“0和1之间的间隔/区间”直接锁定算术编码;别与“变长码字”(霍夫曼)或“符号代替一串字符”(字典)混淆。
讲义原页对照 第84页 · 算术编码
点击图片可弹层放大查看讲义原页
81分算术编码讲义第95页
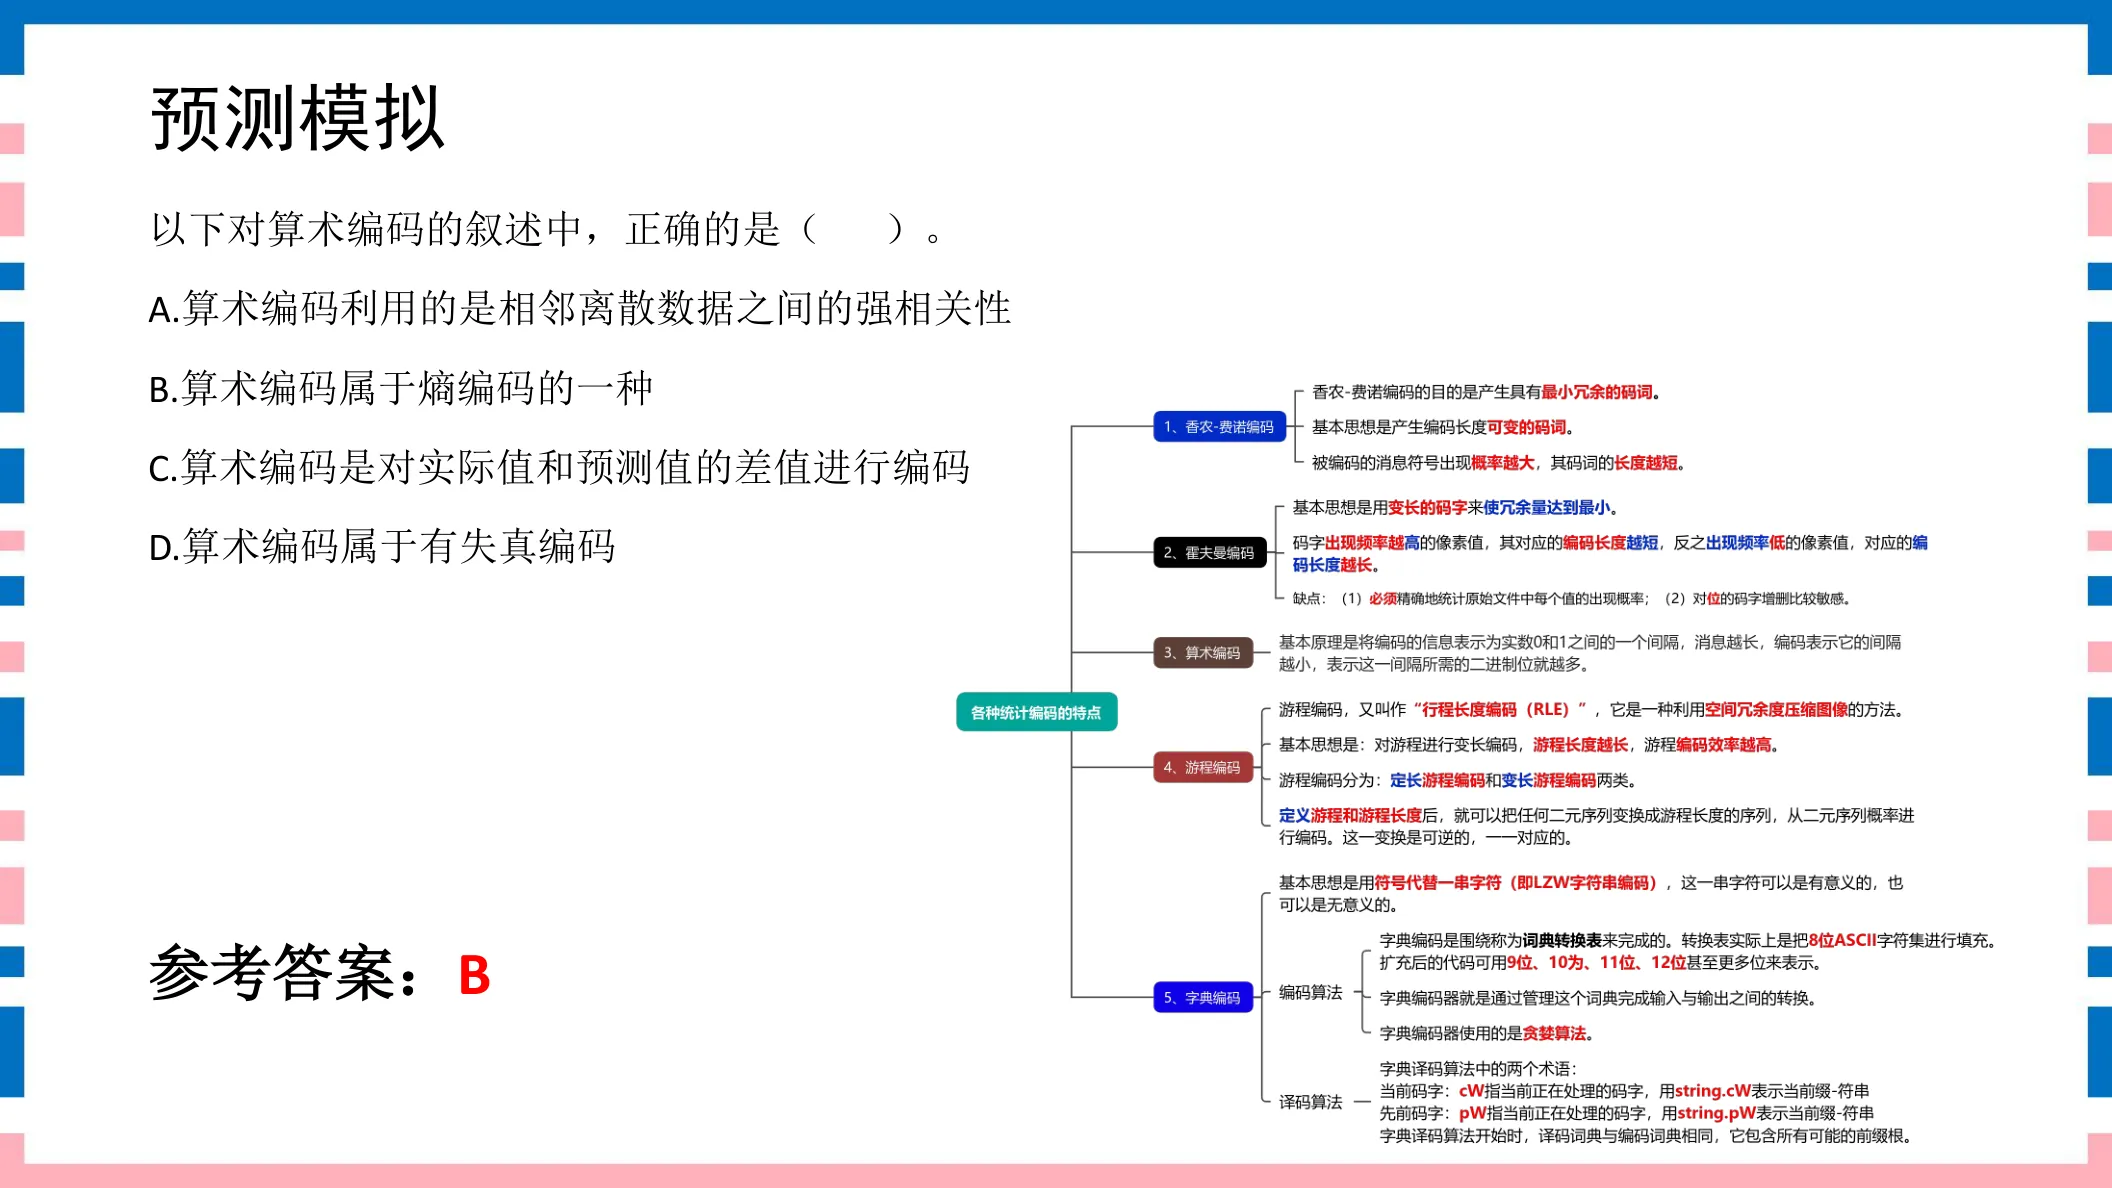
以下对算术编码的叙述中,正确的是( )。A. 算术编码利用的是相邻离散数据之间的强相关性B. 算术编码属于熵编码的一种C. 算术编码是对实际值和预测值的差值进行编码D. 算术编码属于有失真编码
参考答案:B
◆ 考点:算术编码把整段数据映射到[0,1)区间,属于熵编码的一种,是无损压缩(讲义P76、P64)。
◆ 判定:B“算术编码属于熵编码的一种”正确 → B。利用相邻相关性、对预测差值编码是预测编码,故A/C错;算术编码无损故D错。
⚠ 易错提示:算术编码=熵编码、无损、区间映射;“相邻相关性/预测差值”是预测编码的话,别安到它头上。
讲义原页对照 第95页 · 算术编码
点击图片可弹层放大查看讲义原页
91分算术编码讲义第97页
有关算术编码方法,以下说法不正确的是( )。A. 算术编码是一种无损压缩方法B. 编码过程中需要根据符号出现的概率来进行编码C. 编码过程中需要建立“词典”D. 算术编码方法可以用于静态图像压缩
参考答案:C
◆ 考点:算术编码是无损的熵编码、需按概率、可用于静态图像;但它不建词典——建词典是字典(LZW)编码的事(讲义P76)。
◆ 判定:C“需要建立词典”不属于算术编码 → 为不正确项。A/B/D均正确。
⚠ 易错提示:建词典=字典LZW,不是算术编码。把LZW的特征安到算术/霍夫曼头上是高频干扰。
讲义原页对照 第97页 · 算术编码
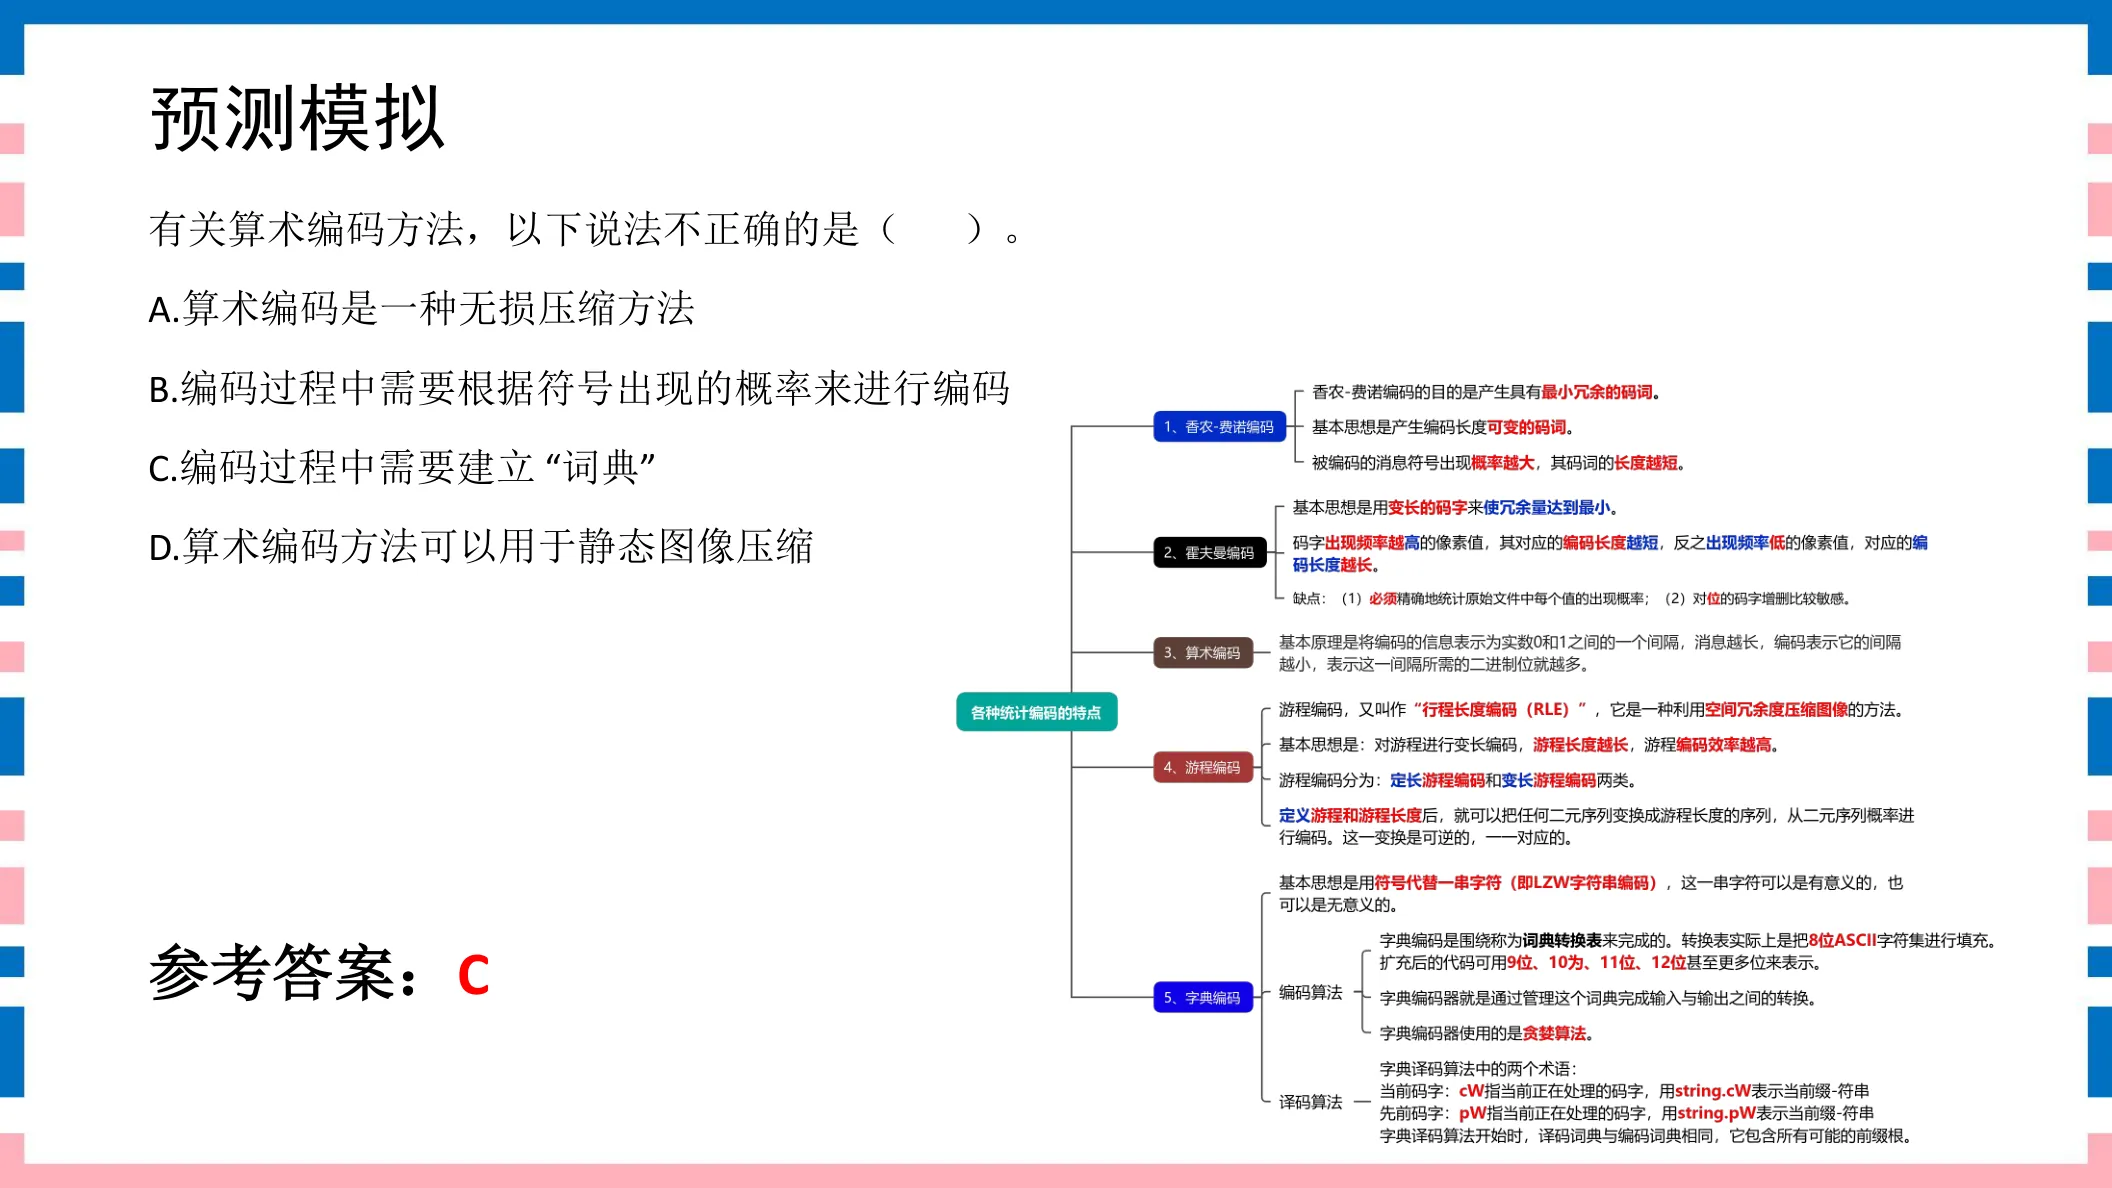
点击图片可弹层放大查看讲义原页
101分算术编码讲义第99页
以下关于算术编码基本原理正确的是( )。A. 产生编码长度可变的码词B. 用变长的码字来使冗余量达到最小C. 将编码的信息表示为实数0和1的一个间隔D. 用符号代替一串字符
参考答案:C
◆ 考点:算术编码基本原理:将编码信息表示为实数0和1之间的一个(子)间隔,消息越长区间越小(讲义P76)。
◆ 判定:C“将编码的信息表示为实数0和1的一个间隔”正确 → C。变长码字、最小冗余是霍夫曼;符号代替一串字符是字典。
⚠ 易错提示:“0和1之间的间隔”=算术编码;与第3题同一考点,看到区间描述直接选算术编码。
讲义原页对照 第99页 · 算术编码
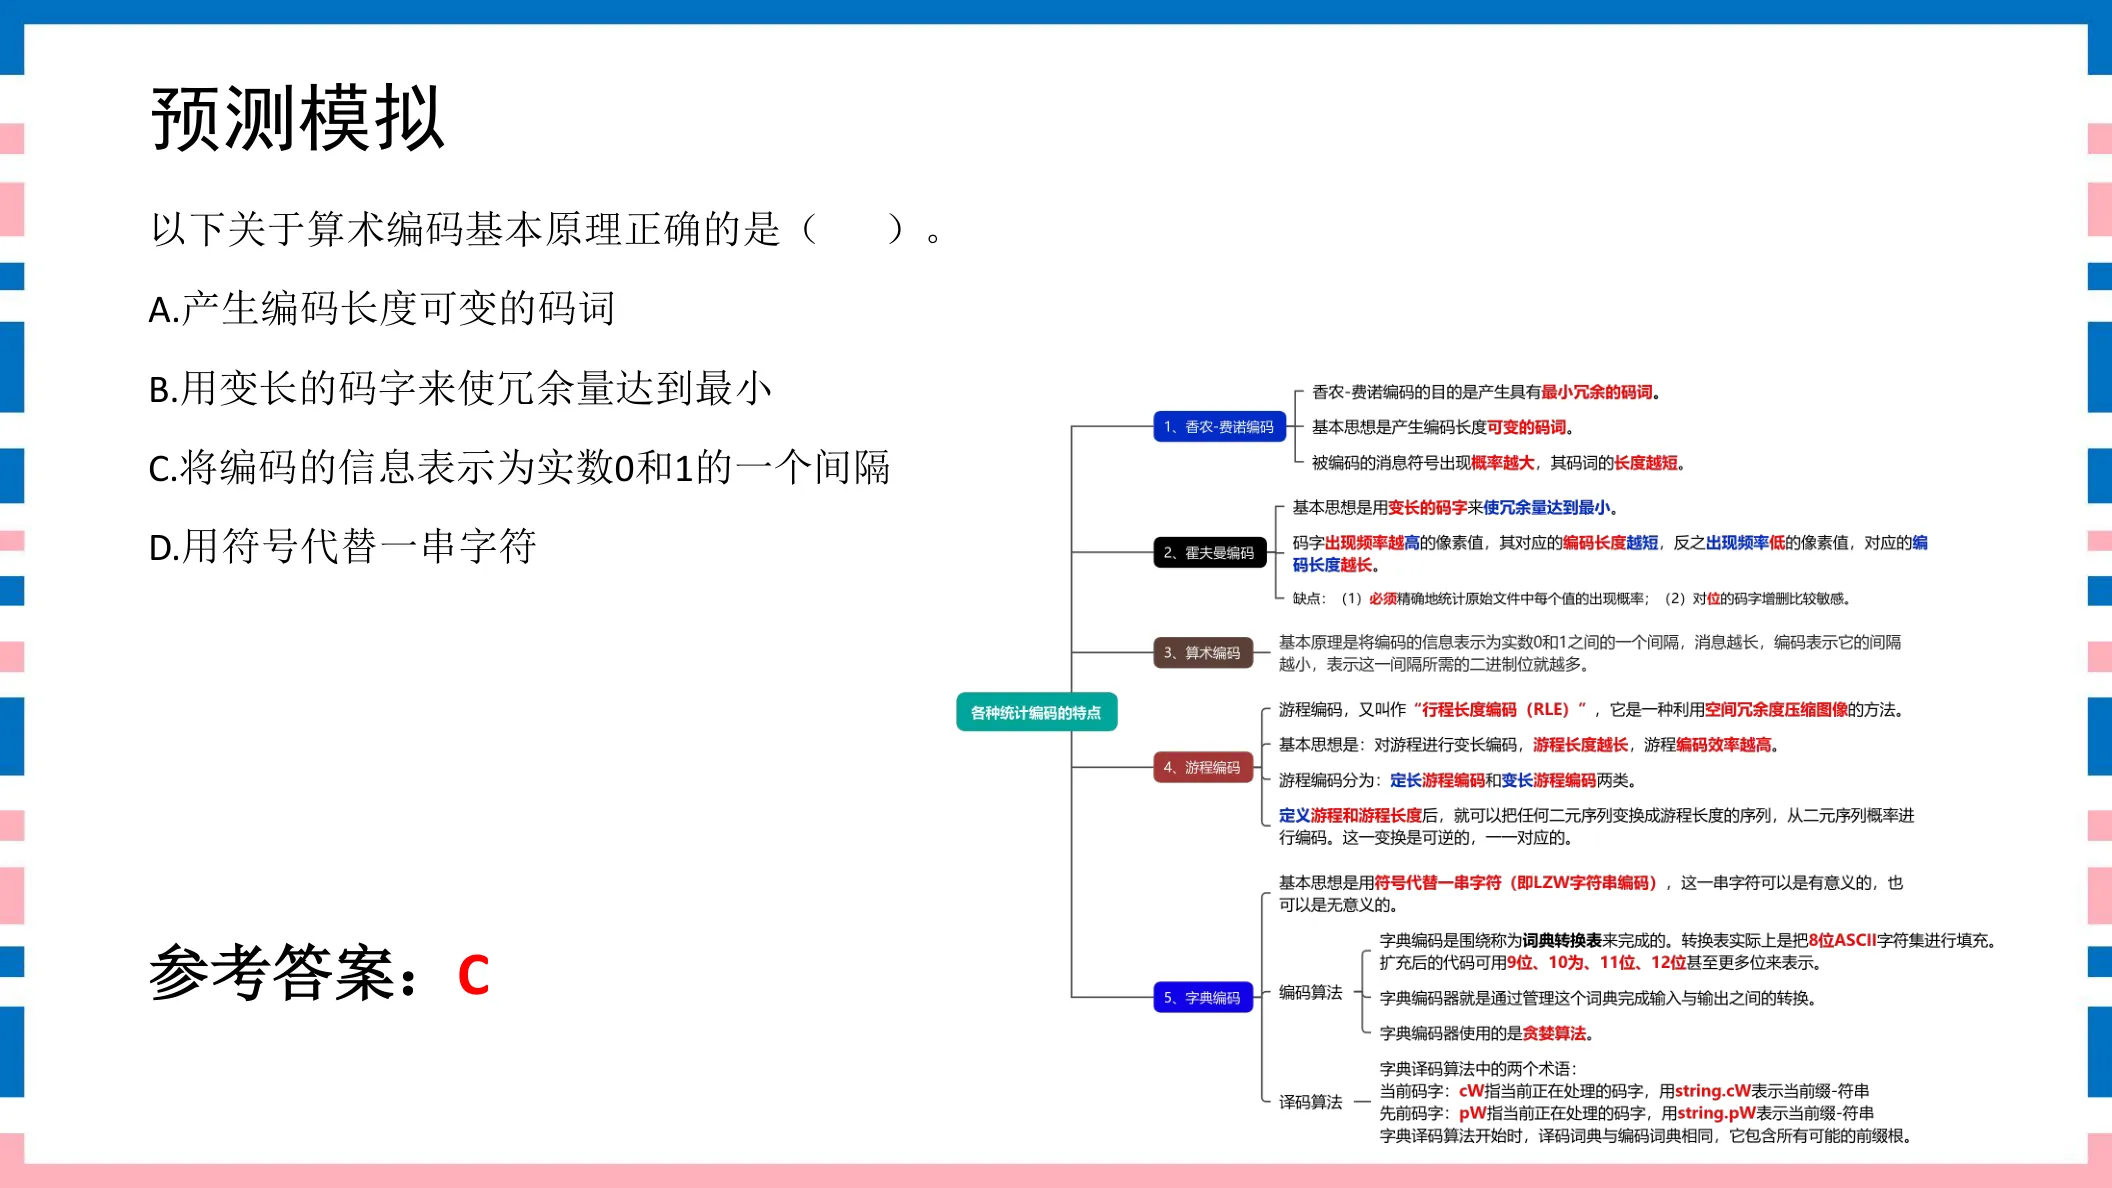
点击图片可弹层放大查看讲义原页
字典编码LZW题 11–14 · 4 题
111分字典编码LZW讲义第87页
字典编码技术中的字典编码器使用的是( )算法。A. 贪婪B. 检索C. 动态规划D. .辗转
参考答案:A
◆ 考点:字典(词典)编码围绕一张“词典转换表”把输入串换成短码,字典编码器使用的是贪婪算法(讲义P81)。
◆ 判定:字典编码器=贪婪(greedy)算法 → A。检索、动态规划、辗转均为干扰。
⚠ 易错提示:字典编码器=贪婪算法;别与“按概率编码”(霍夫曼/算术)或“对差值编码”(预测)混。
讲义原页对照 第87页 · 字典编码LZW
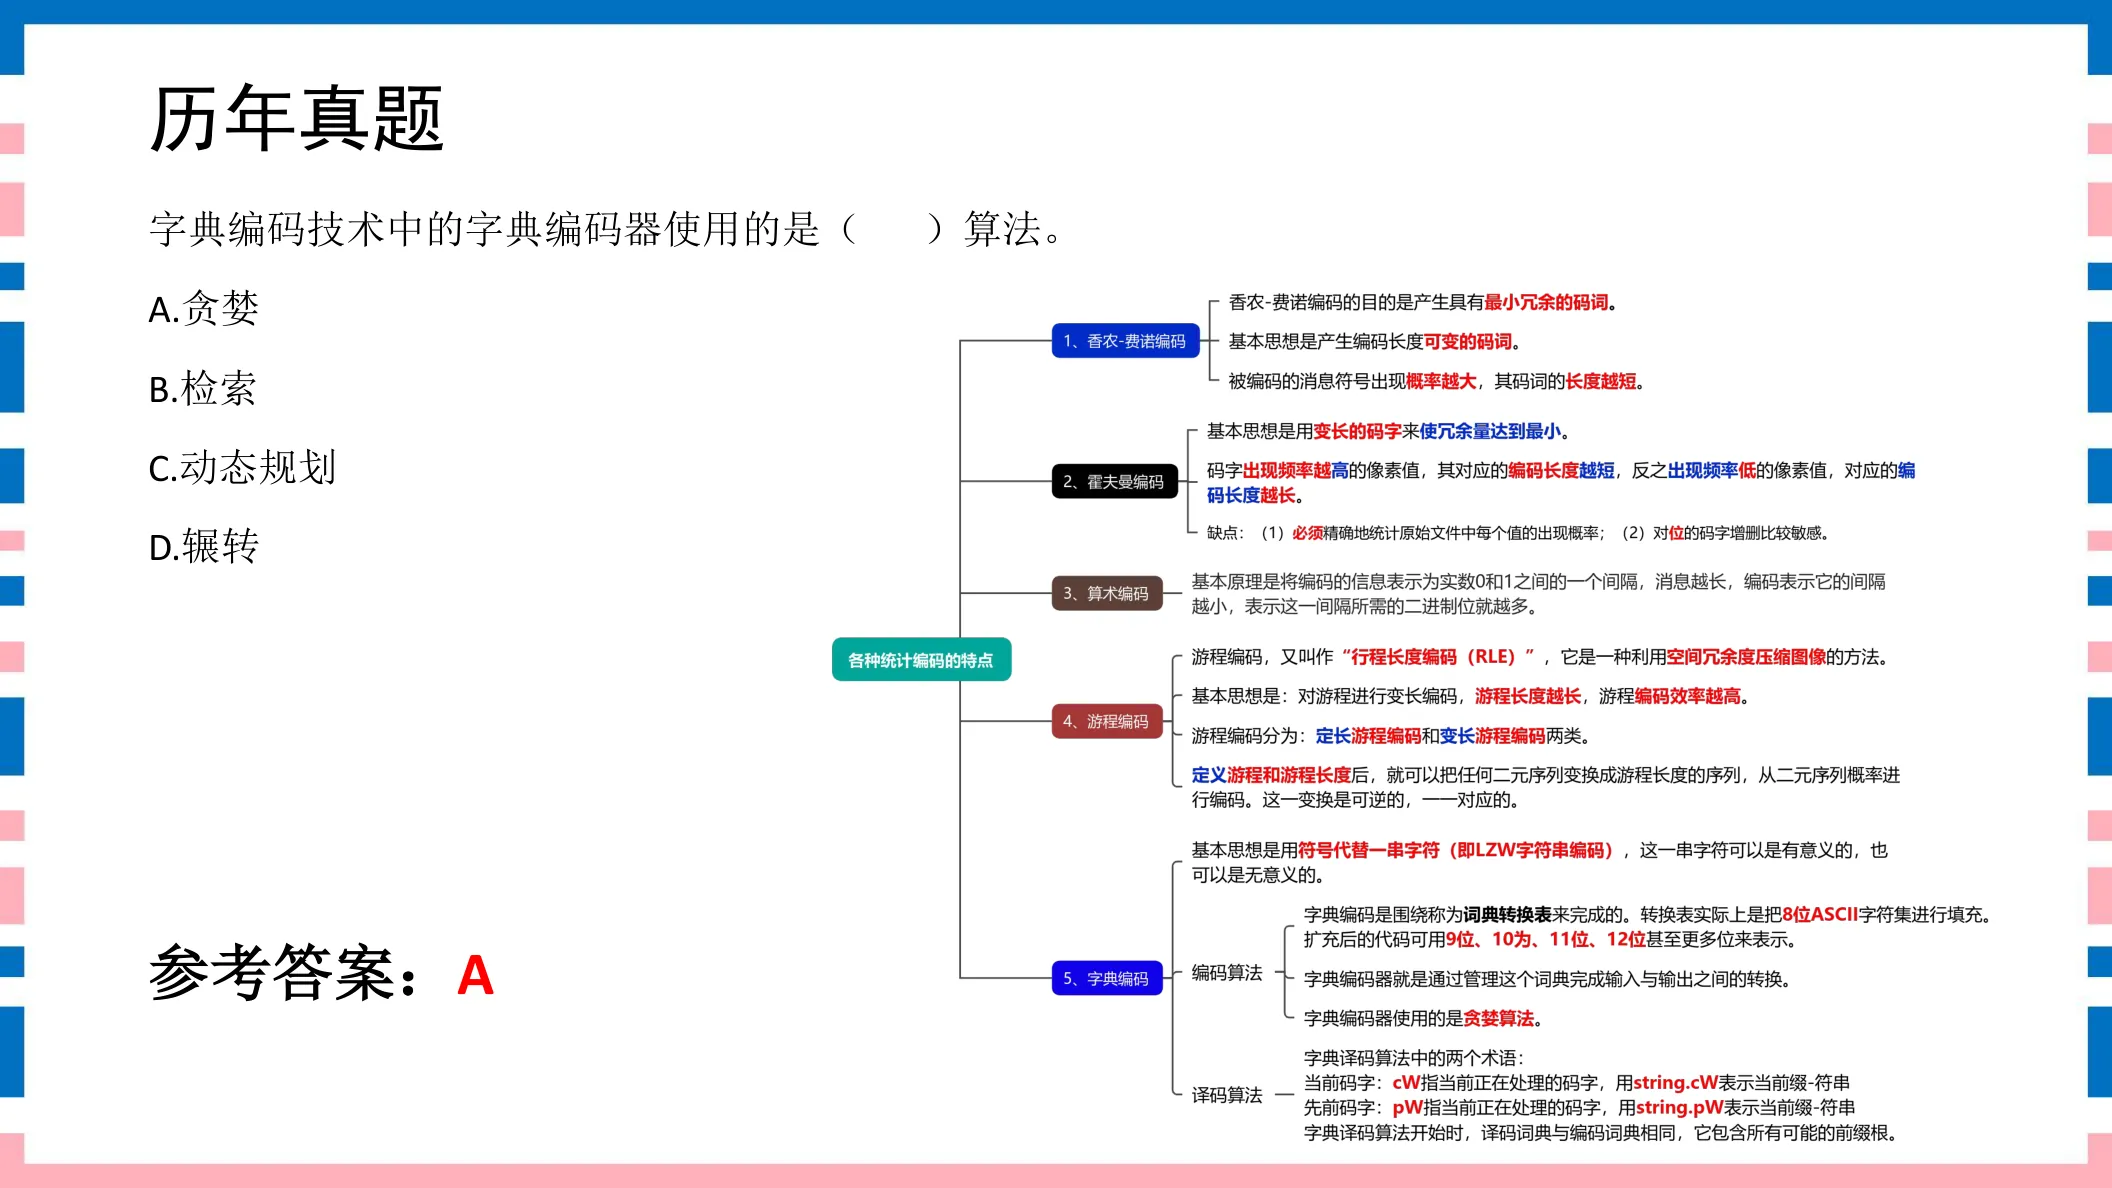
点击图片可弹层放大查看讲义原页
121分字典编码LZW讲义第89页
下列编码方式中,采用“用符号代替一串字符”思想的是( )。A. 变换编码B. 字典编码C. 子带编码D. 视频编码
参考答案:B
◆ 考点:字典编码的基本思想是用一个(短)符号代替一串字符(即LZW字符串编码),串可以有意义或无意义(讲义P81)。
◆ 判定:“用符号代替一串字符”=字典(LZW)编码 → B。变换/子带是另两大类,视频编码是泛称。
⚠ 易错提示:“符号代替一串字符/建词典”是字典LZW的招牌;“一个符号一个码字”是霍夫曼,别混。
讲义原页对照 第89页 · 字典编码LZW
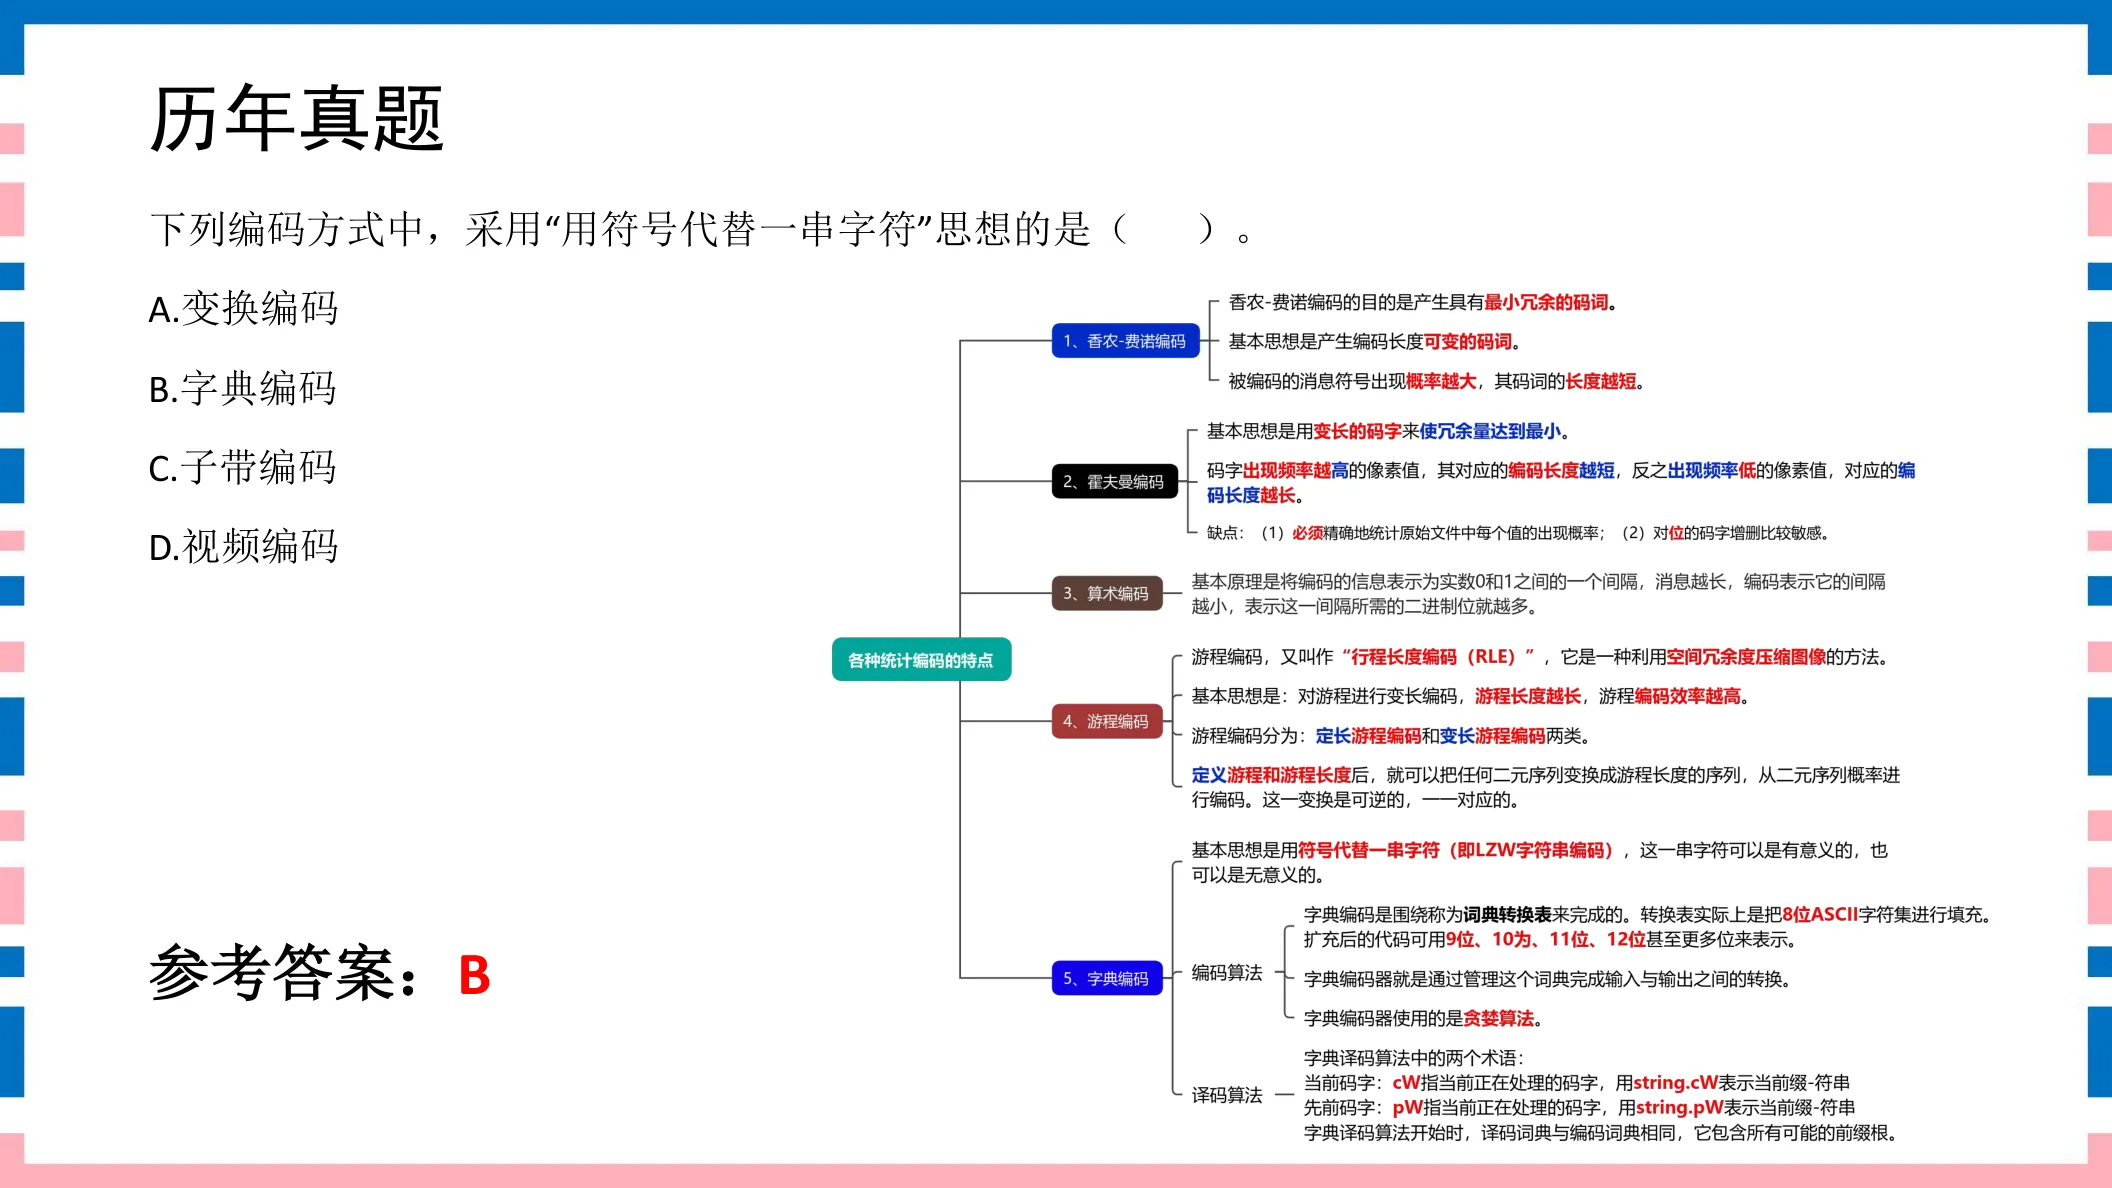
点击图片可弹层放大查看讲义原页
131分字典编码LZW讲义第93页
以下有关LZW编码方法的叙述中,正确的是( )。A. B. C. D.A. LZW编码是一种有损压缩方法B. 编码过程中需要根据符号出现的概率来进行编码C. 编码过程中需要建立“词典”D. LZW编码方法不能用于静态图像压缩
参考答案:C
◆ 考点:字典(LZW)编码围绕“词典转换表”工作,编码过程中需要不断建立/扩充“词典”,是无损编码,可用于静态图像与GIF等(讲义P81)。
◆ 判定:C“需要建立词典”正确 → C。LZW无损故A错;按概率是霍夫曼故B错;D“不能用于静态图像”错。
⚠ 易错提示:建词典=字典LZW;“按概率”是霍夫曼/算术,别张冠李戴。LZW是无损。
讲义原页对照 第93页 · 字典编码LZW
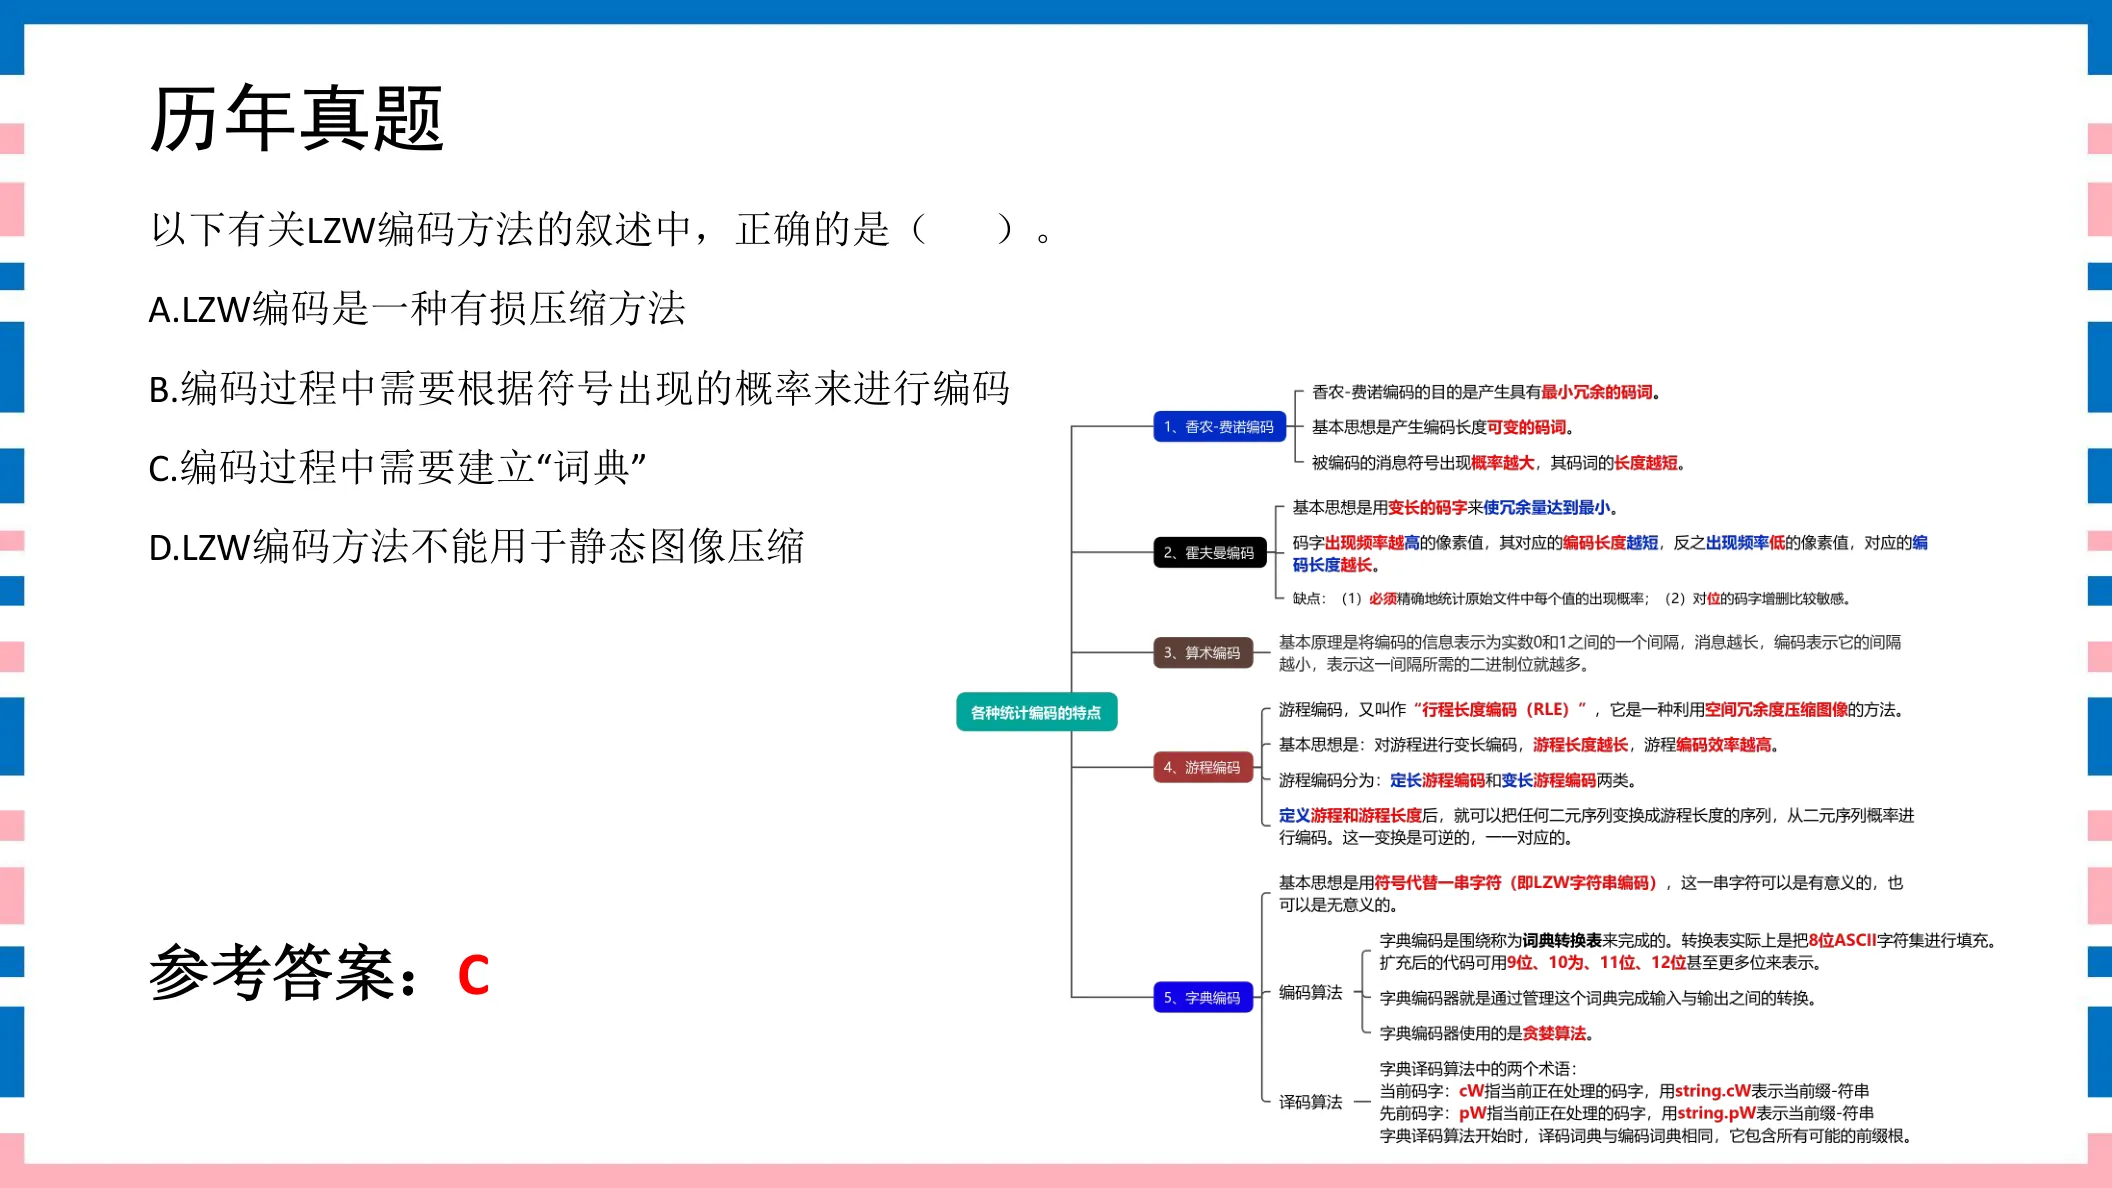
点击图片可弹层放大查看讲义原页
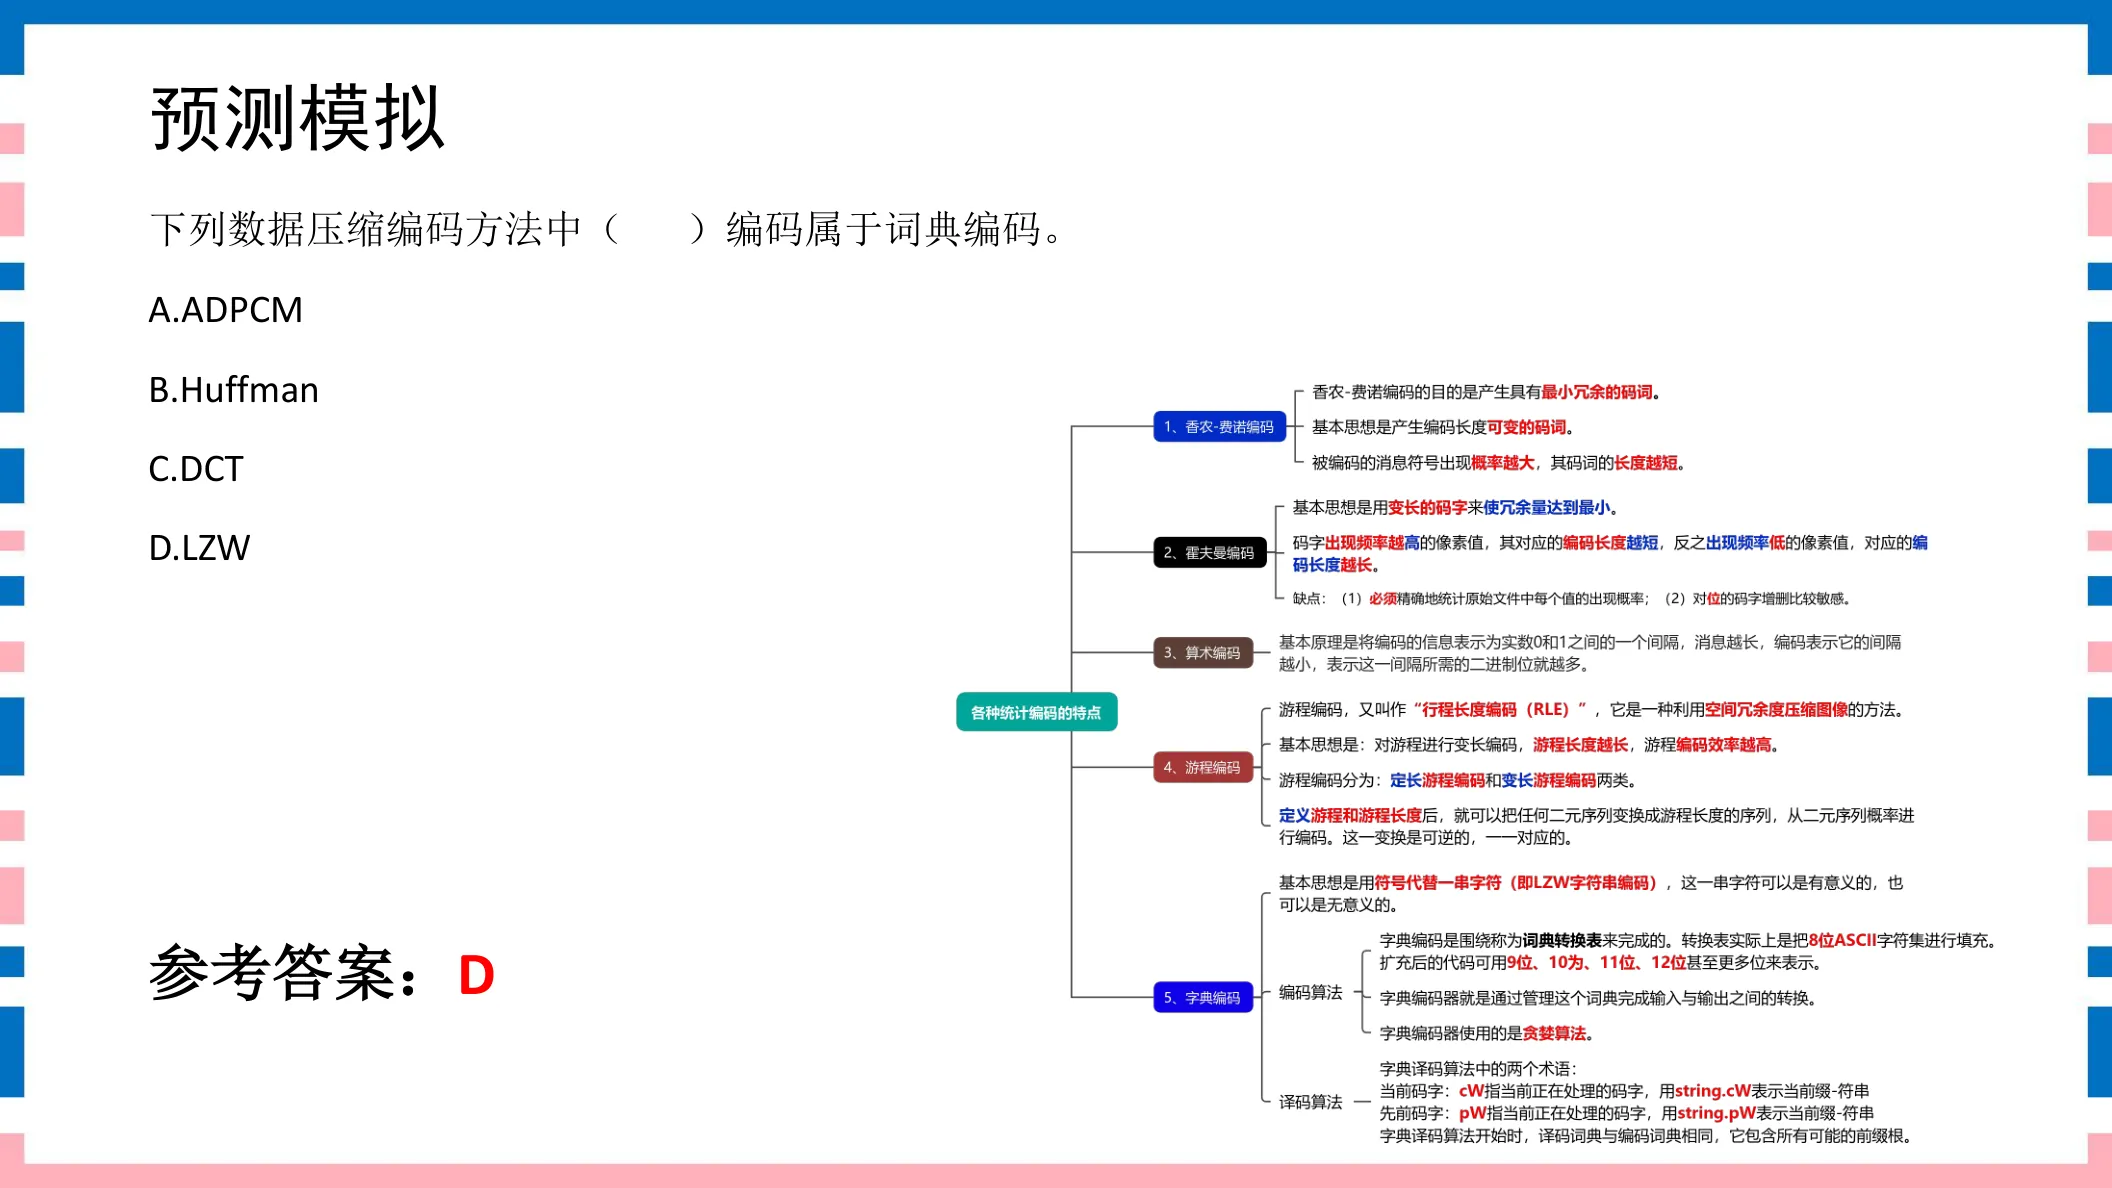
统计编码分类题 15–16 · 2 题
151分统计编码分类讲义第88页
下列编码方式中,不属于统计编码的是( )。A. 霍夫曼编码B. 游程编码C. 算术编码D. 变换编码
参考答案:D
◆ 考点:统计编码属无损编码,包含:熵编码下的霍夫曼编码、算术编码、行程(游程)编码、字典编码四类(讲义P64)。
◆ 判定:变换编码不属于统计编码(它属另一大类:预测/变换类)→ D。霍夫曼、游程、算术都是统计编码。
⚠ 易错提示:统计编码四兄弟=霍夫曼/算术/游程/字典(LZW),全是无损;变换编码、预测编码不在其内。
🔗 关联题:第16题(同考点,建议对比记忆)
讲义原页对照 第88页 · 统计编码分类
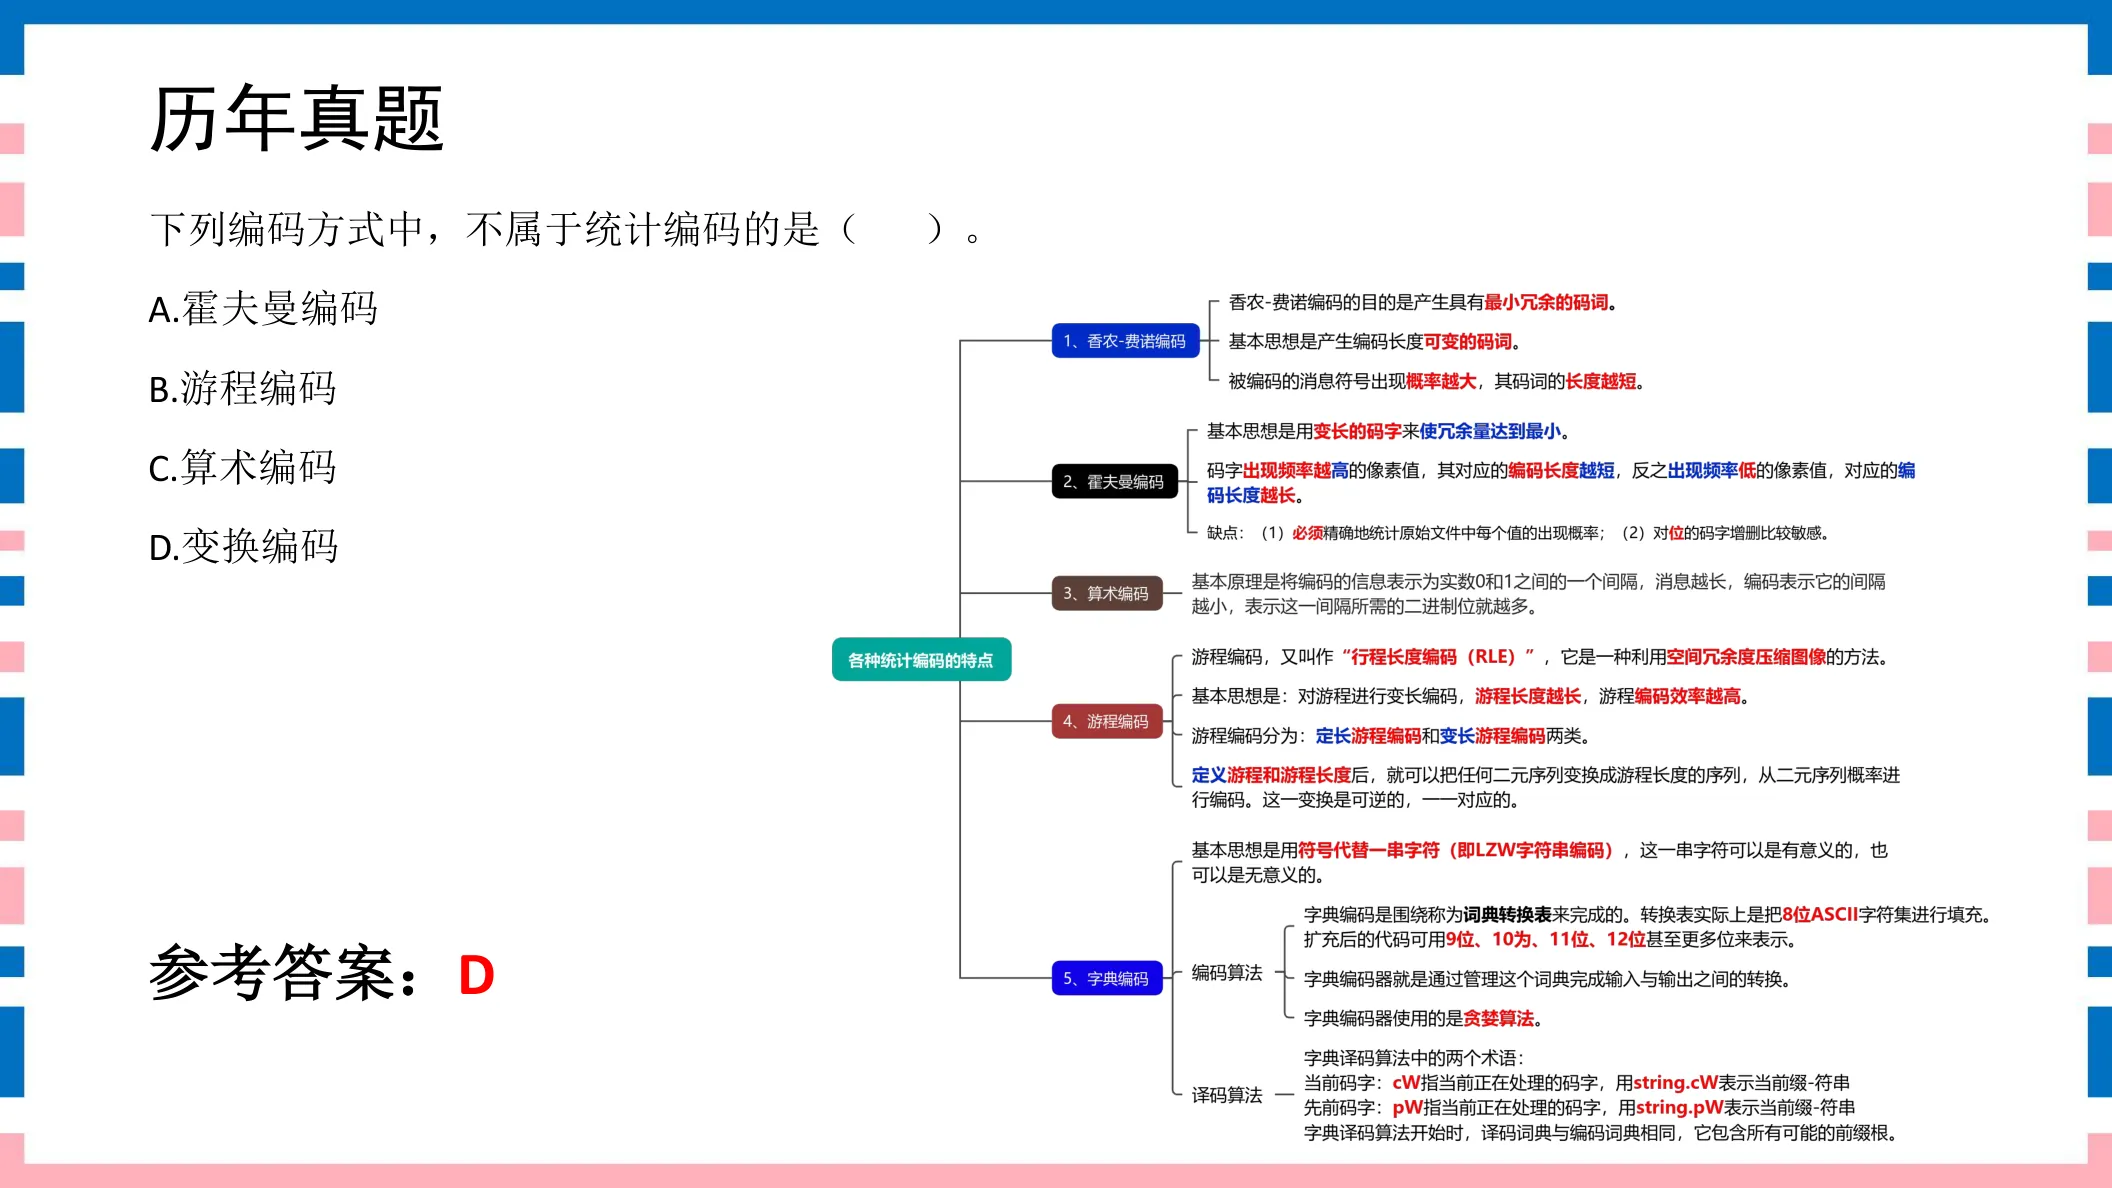
点击图片可弹层放大查看讲义原页
161分统计编码分类讲义第90页
( )不属于图像编码算法中的统计编码。A. 哈夫曼编码B. 香农编码C. 算术编码D. 小波编码
参考答案:D
◆ 考点:统计编码=霍夫曼、算术、行程、字典(香农编码同属熵编码);小波编码属于变换编码大类,不是统计编码(讲义P64)。
◆ 判定:小波编码不属于统计编码 → D。哈夫曼、香农、算术都是统计/熵编码。
⚠ 易错提示:再背一遍:统计(熵)编码=霍夫曼/算术/游程/字典;小波、DCT、K-L都是变换编码。
🔗 关联题:第15题(同考点,建议对比记忆)
讲义原页对照 第90页 · 统计编码分类
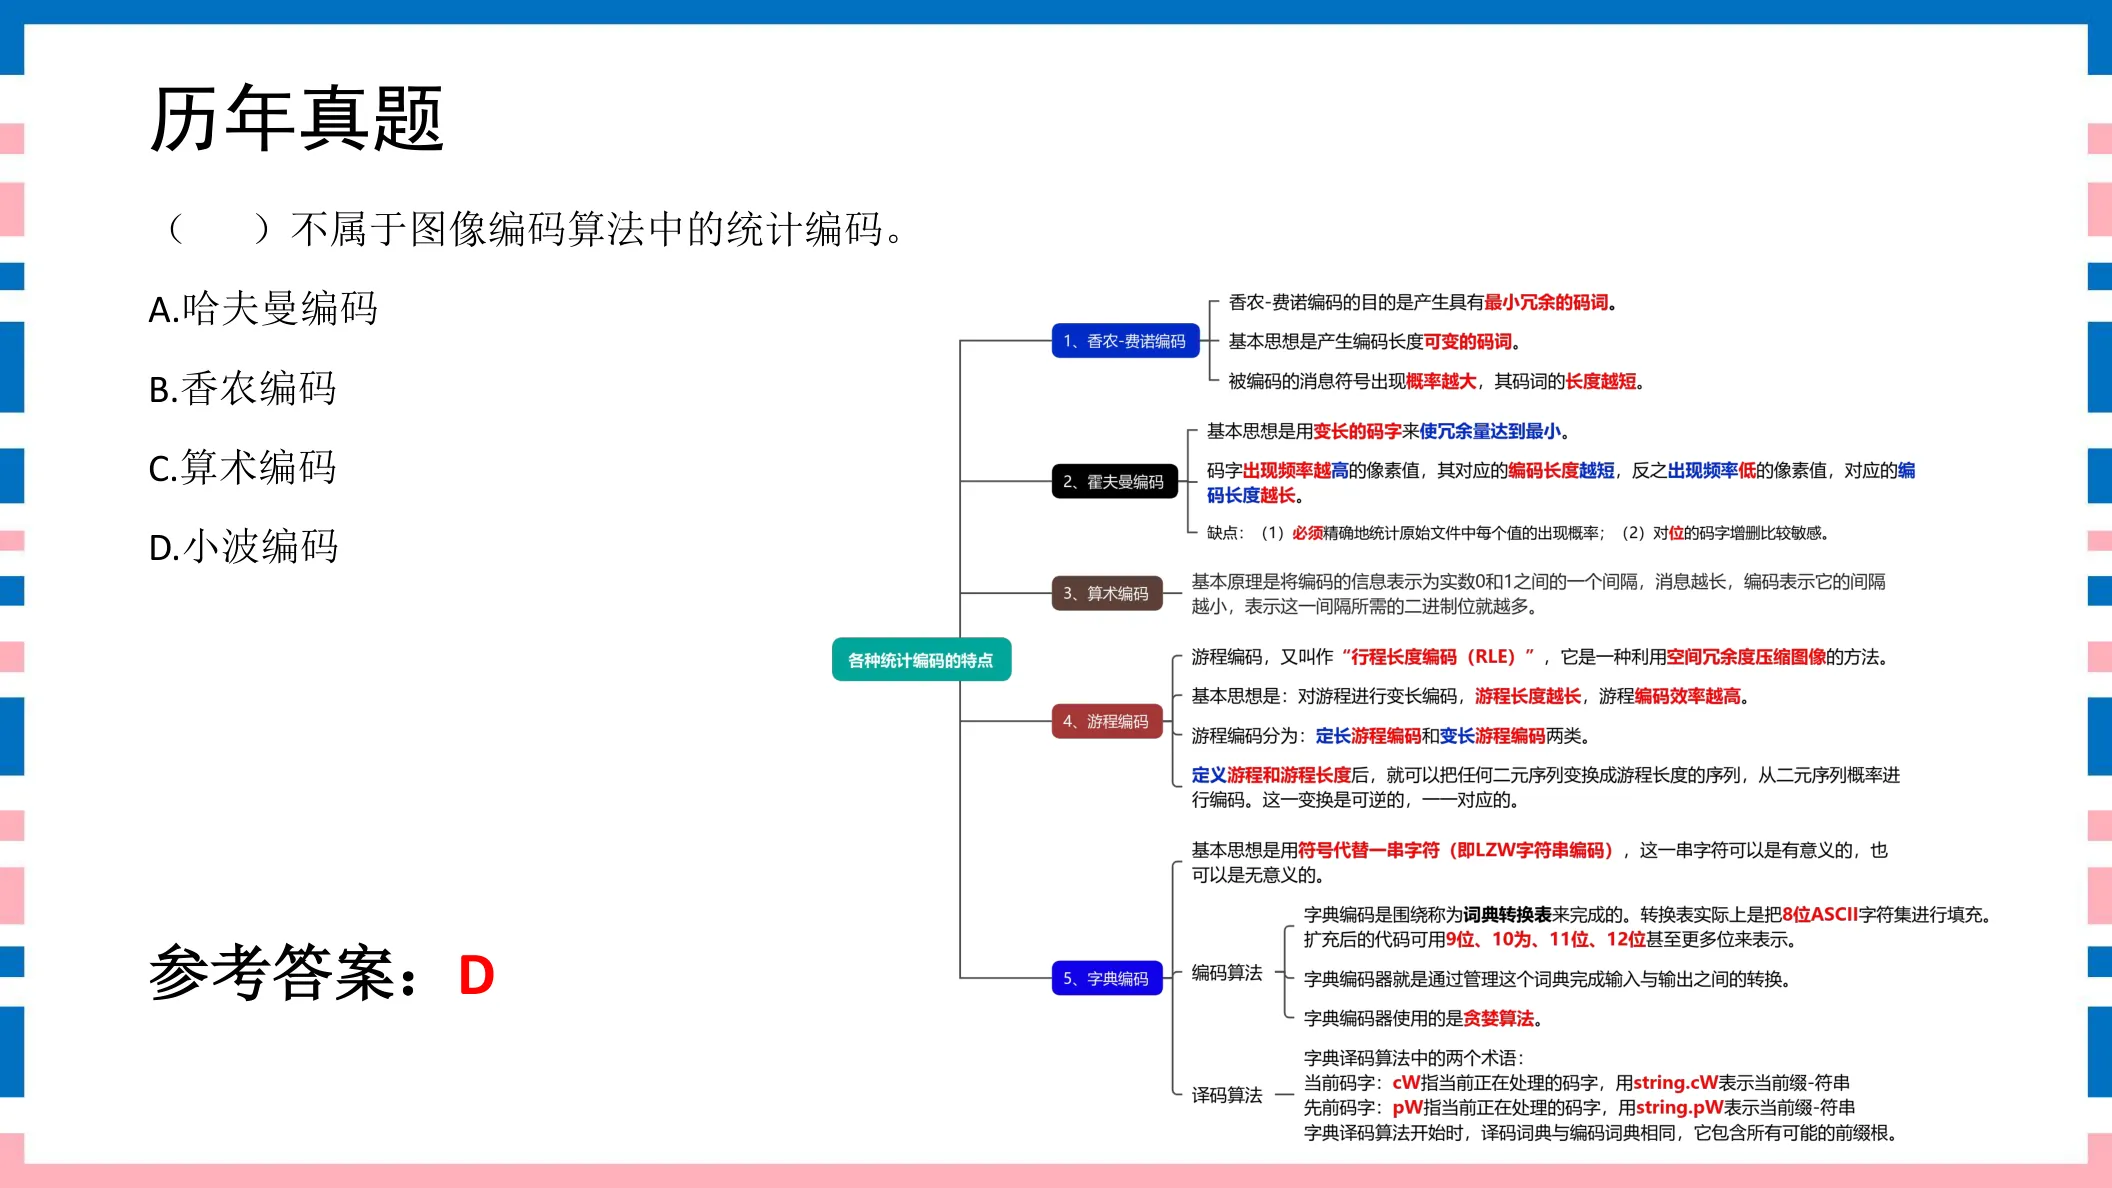
点击图片可弹层放大查看讲义原页
行程编码RLE题 17–18 · 2 题
171分行程编码RLE讲义第92页
以下关于行程编码叙述中,正确的是( )。A. 编码复杂,解码慢B. 不适合于静态图像文件的压缩C. 不具有可逆性D. 分为定长和非定长两种类型
参考答案:D
◆ 考点:游程(行程长度RLE)编码:对连续相同像素(游程)变长编码,游程越长效率越高,分定长和变长(非定长)两类,变换可逆、一一对应(讲义P80)。
◆ 判定:D“分为定长和非定长两种类型”与讲义一致 → D。RLE可逆、适合二值/静态图像,故A/B/C错。
⚠ 易错提示:RLE=无损、可逆,按游程长度编码,分定长/变长两类;它不按概率、不建词典。
🔗 关联题:第18题(同考点,建议对比记忆)
讲义原页对照 第92页 · 行程编码RLE
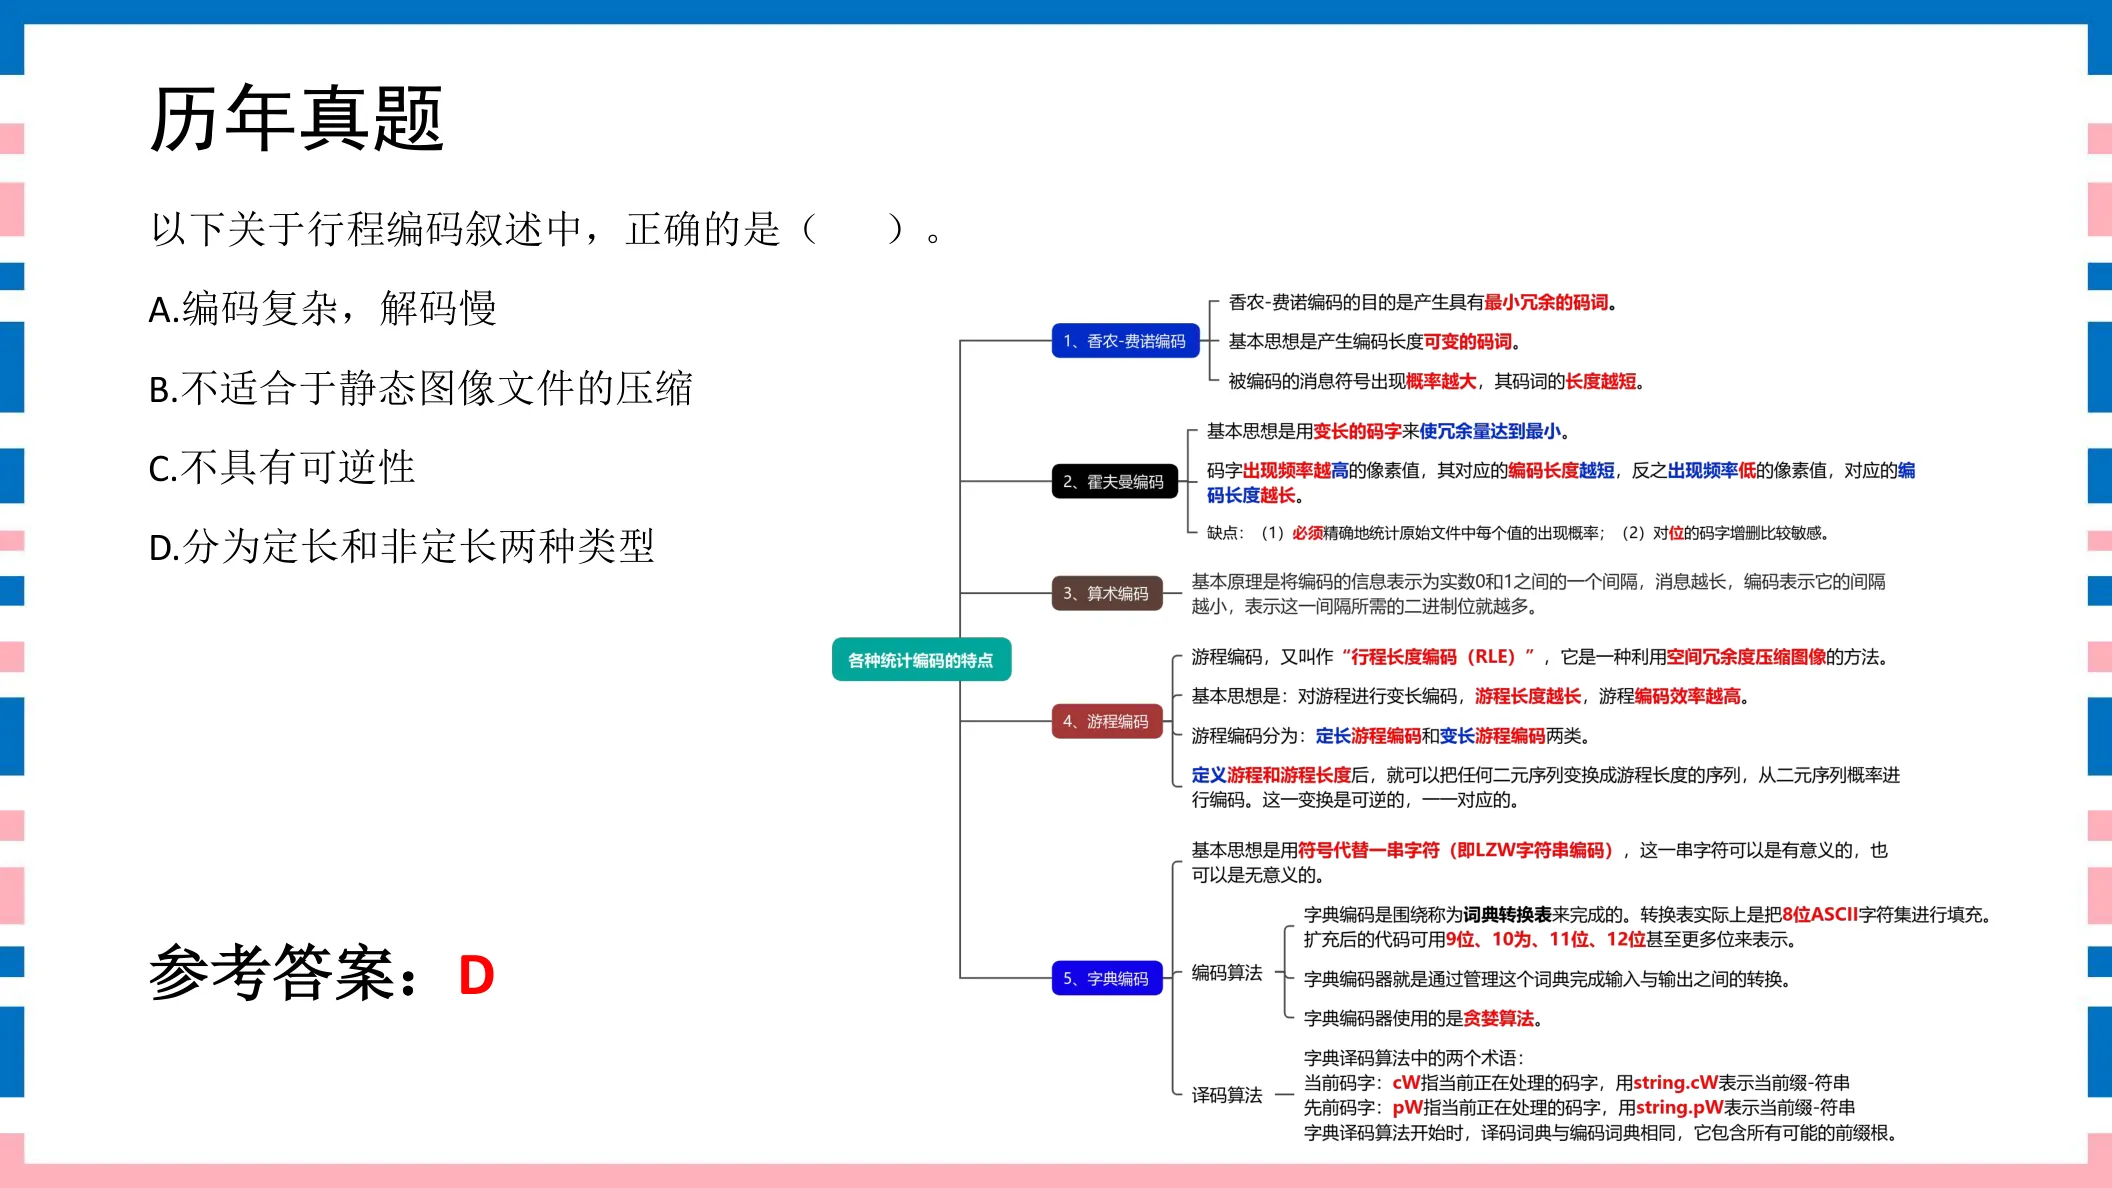
点击图片可弹层放大查看讲义原页
181分行程编码RLE讲义第98页
有关行程长度编码(RLE)方法,以下说法不正确的是( )。A. 行程长度编码是一种有损压缩方法B. 编码过程中需要根据符号出现的概率来进行编码C. 编码过程中需要建立“词典”D. 行程长度编码方法可以用于静态图像压缩
参考答案:D
◆ 考点:行程长度(RLE)编码是无损、可逆的统计编码,对游程变长编码,可用于静态图像/传真G3;它按游程长度编码,不按概率、也不建词典(讲义P80)。
◆ 判定:按试卷给定参考答案为 D(RLE 可用于静态图像压缩)。A“有损”、B“按概率”、C“建词典”均为张冠李戴。
⚠ 易错提示:RLE=无损可逆、按游程;按概率=霍夫曼/算术,建词典=LZW。本题问法与讲义页(“正确的是”)表述略有出入,答案以试卷给定 D 为准。
🔗 关联题:第17题(同考点,建议对比记忆)
讲义原页对照 第98页 · 行程编码RLE
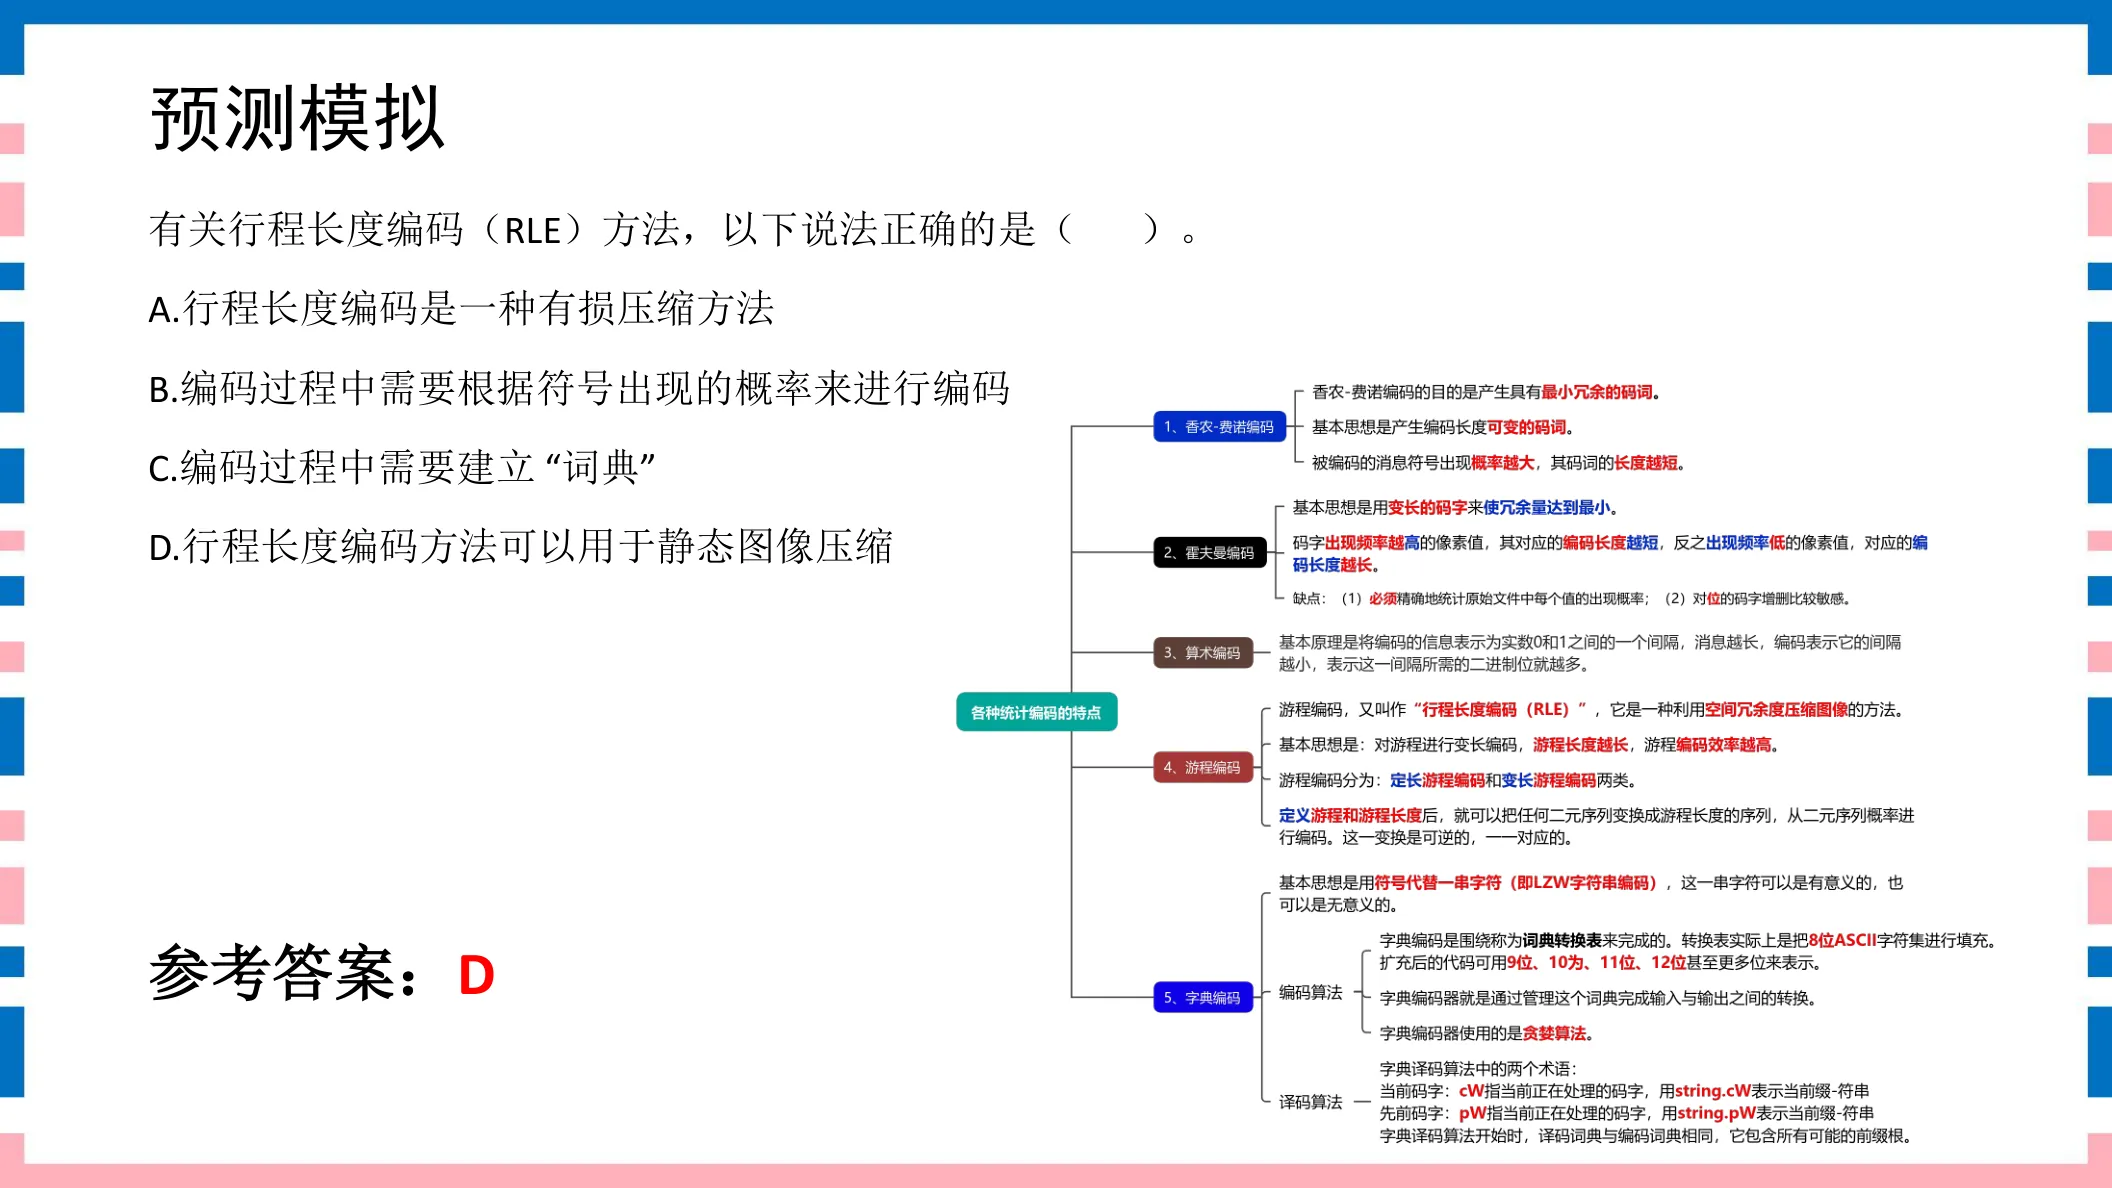
点击图片可弹层放大查看讲义原页
DPCM系统组成题 19–21 · 3 题
191分DPCM系统组成讲义第106页
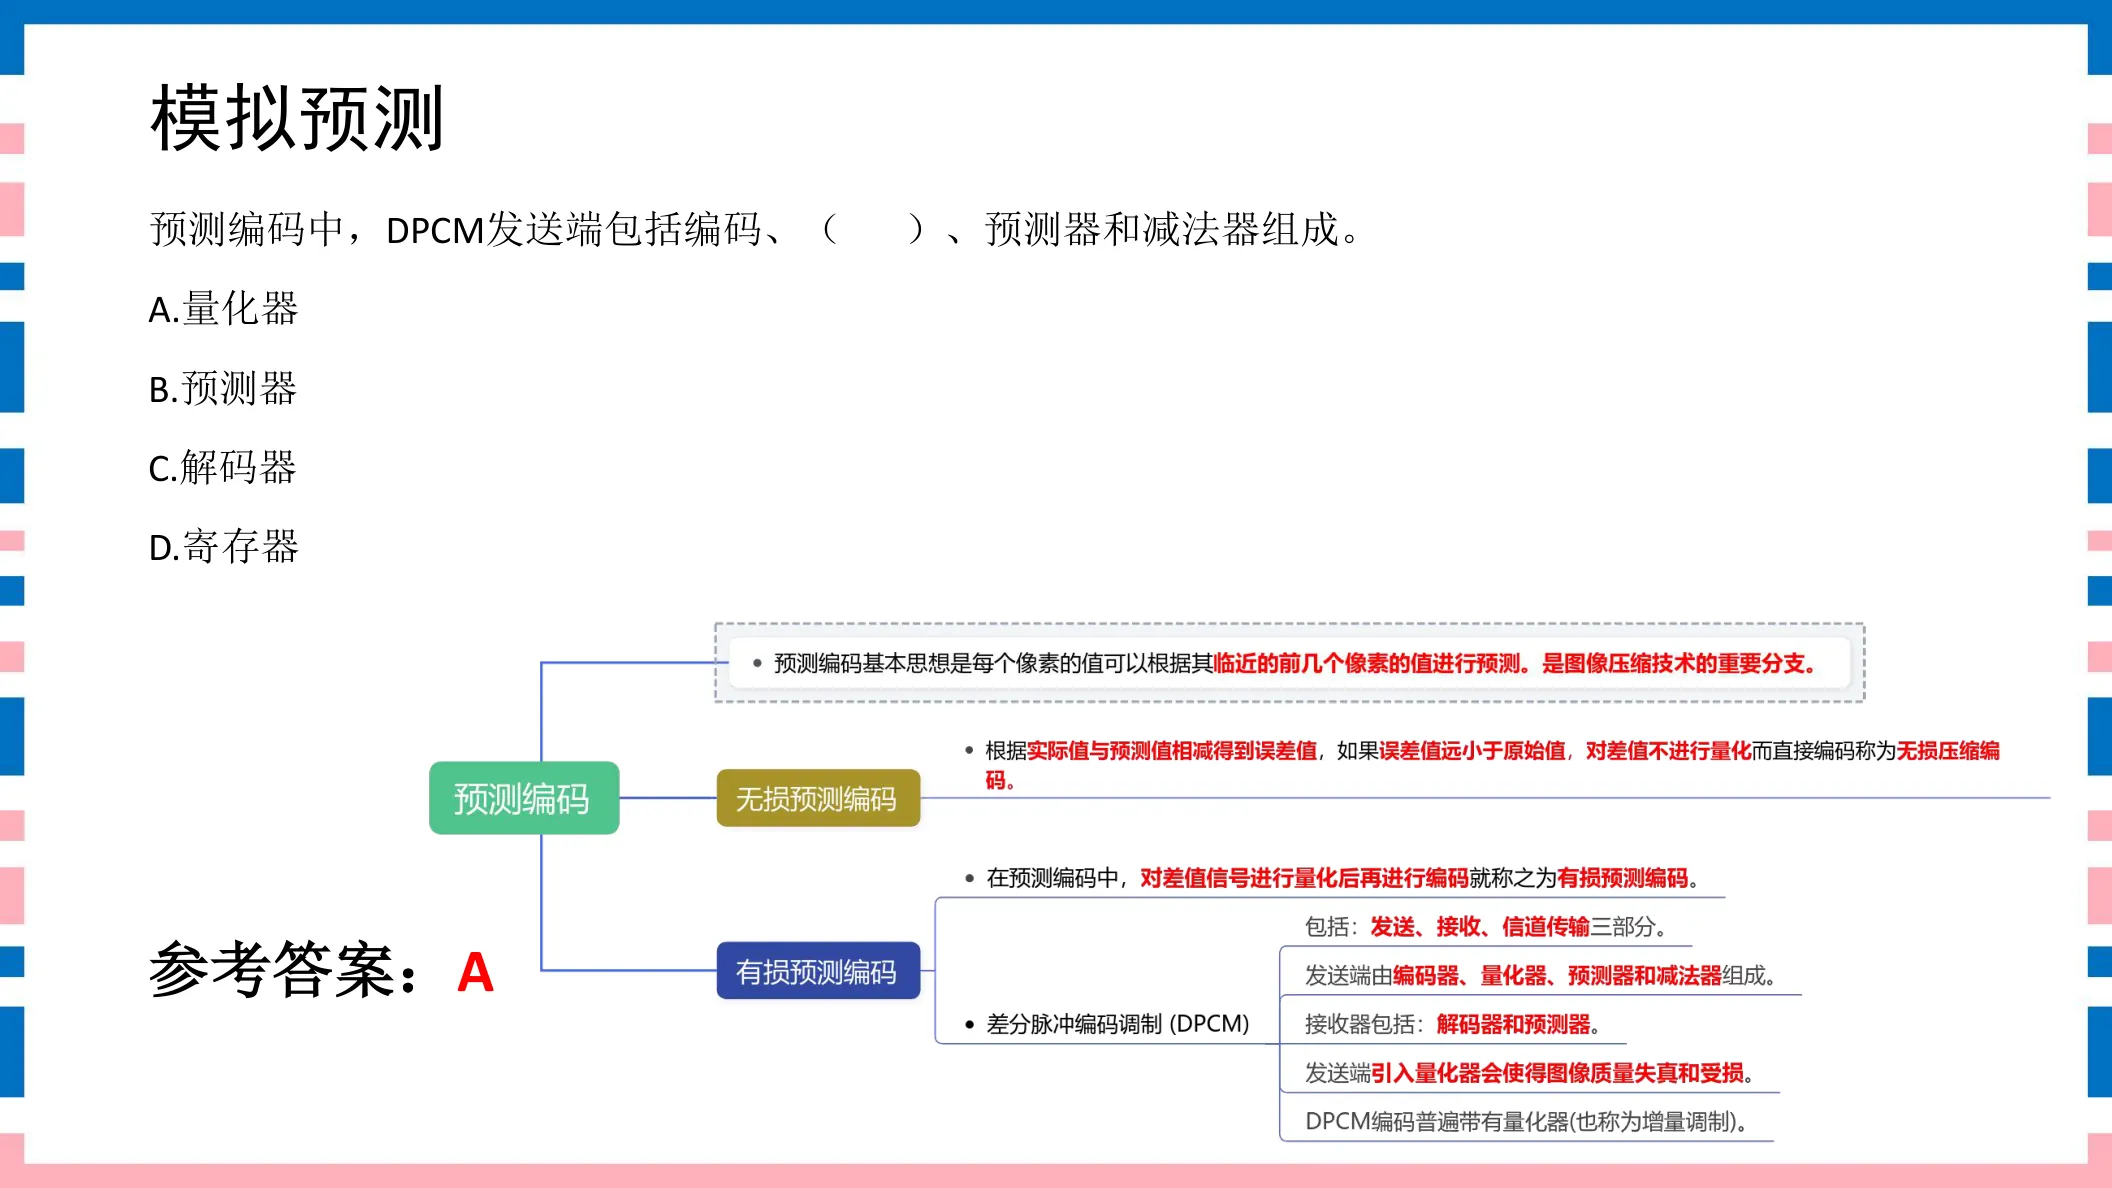
DPCM系统包括发送、接收、信道传输三部分,接收器包括( )。
①编码器;②解码器;③量化器;④预测器。A. ①②B. ①③C. ②③D. ②④
参考答案:D
◆ 考点:DPCM系统分发送端、接收端、信道传输三部分:发送端含编码器(量化器)、预测器、减法器;接收端含解码器和预测器(讲义P105)。
◆ 判定:接收器=②解码器+④预测器 → D(②④)。编码器、量化器在发送端。
⚠ 易错提示:收端=解码器+预测器;量化器只在发端(含量化才有损)。别把发端的编码器/量化器算到接收端。
讲义原页对照 第106页 · DPCM系统组成
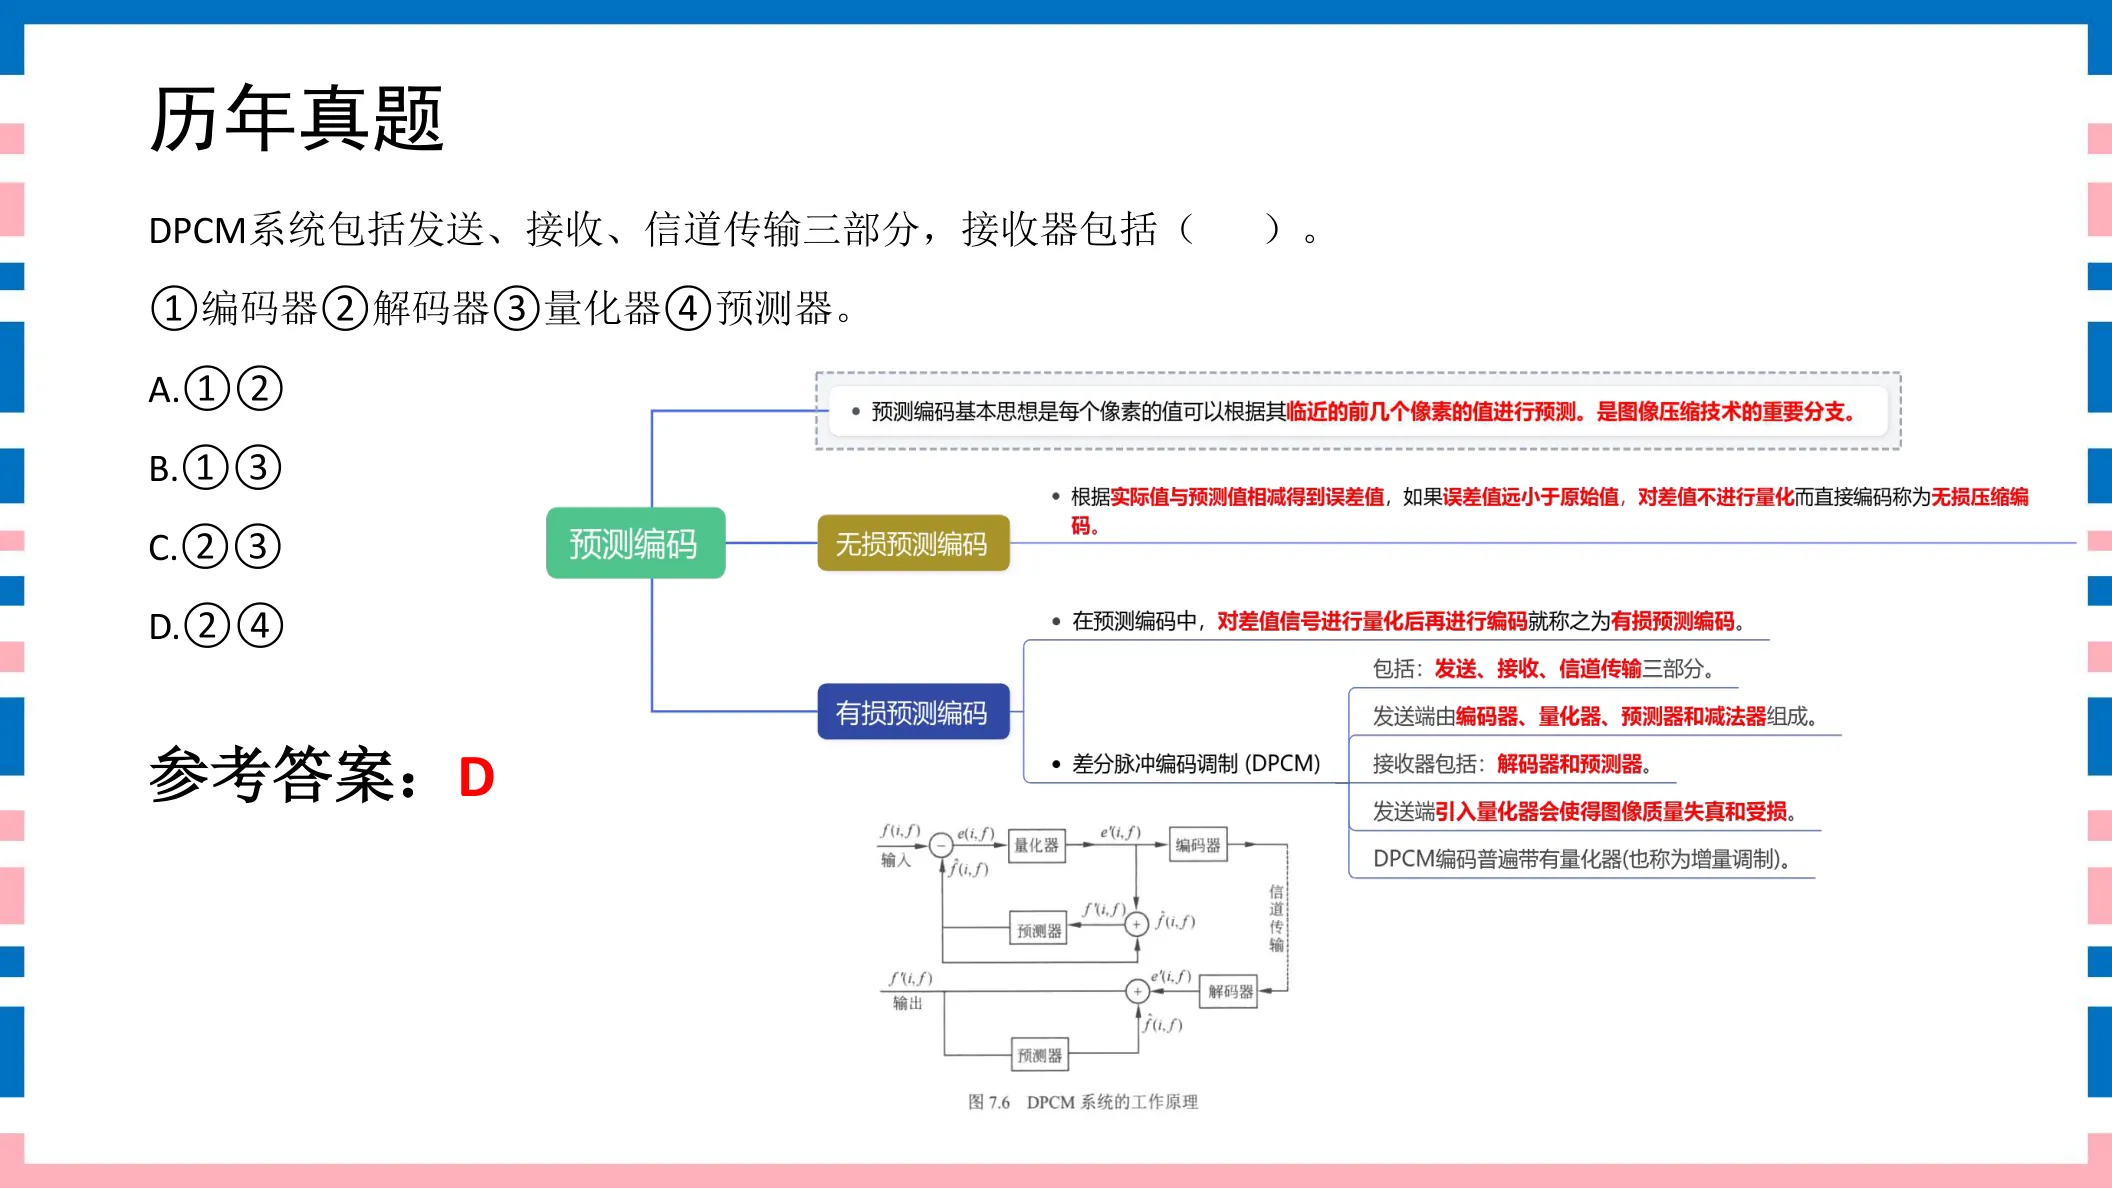
点击图片可弹层放大查看讲义原页
201分DPCM系统组成讲义第109页
预测编码中,DPCM系统包括发送、接收和( )三个部分。A. B. C. D.A. 量化器B. 信道传输C. 解码器D. 压缩位数
参考答案:B
◆ 考点:DPCM系统包括发送、接收和信道传输三个部分(讲义P105)。
◆ 判定:第三部分=信道传输 → B。量化器、解码器是端内部件,“压缩位数”不是系统组成部分。
⚠ 易错提示:DPCM三大块=发送端+接收端+信道传输;量化器/预测器/减法器是发端内部零件。
讲义原页对照 第109页 · DPCM系统组成
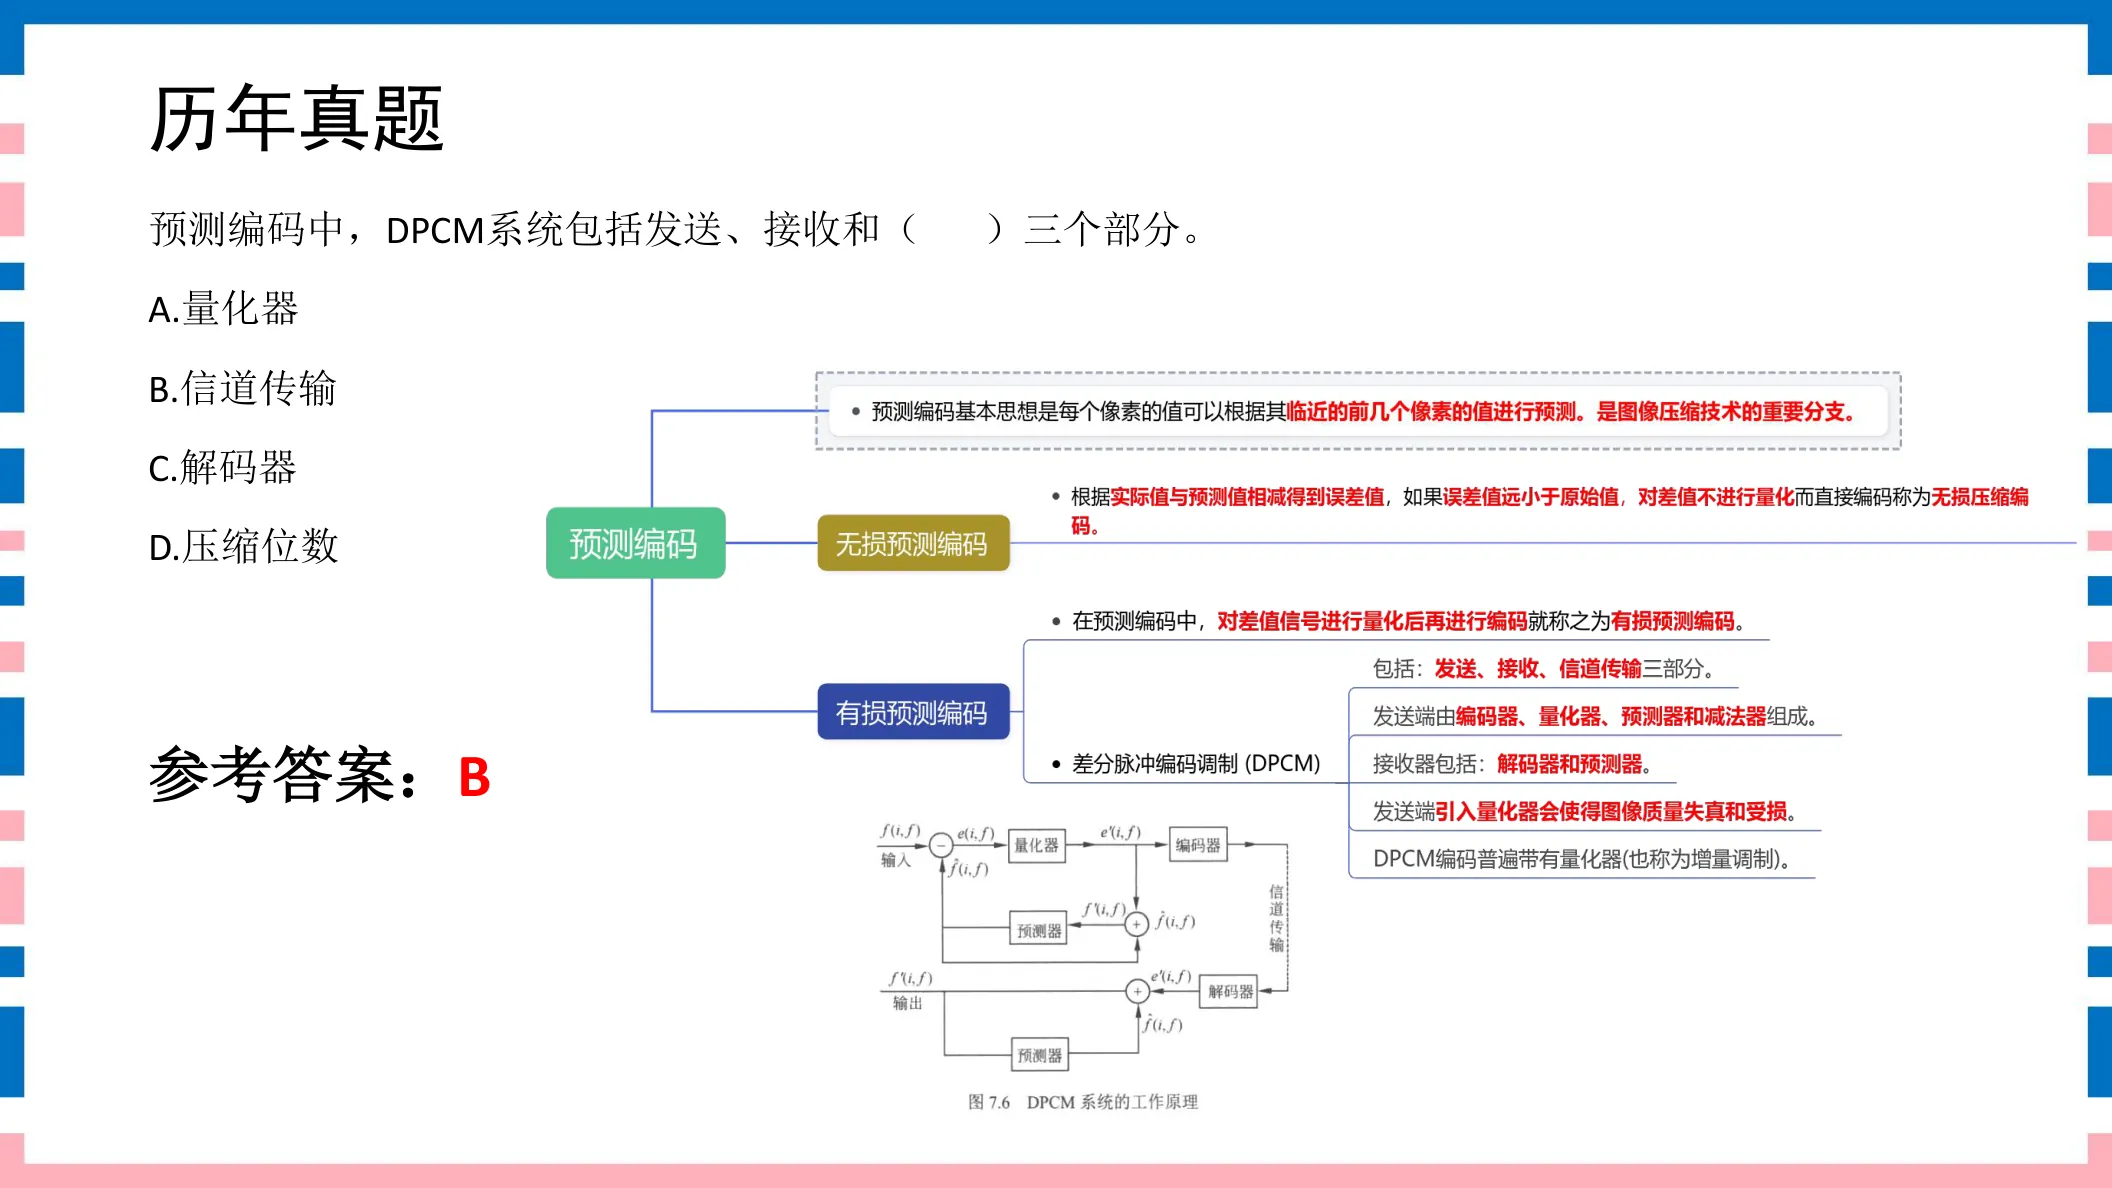
点击图片可弹层放大查看讲义原页
预测编码原理题 22–27 · 6 题
221分预测编码原理讲义第107页
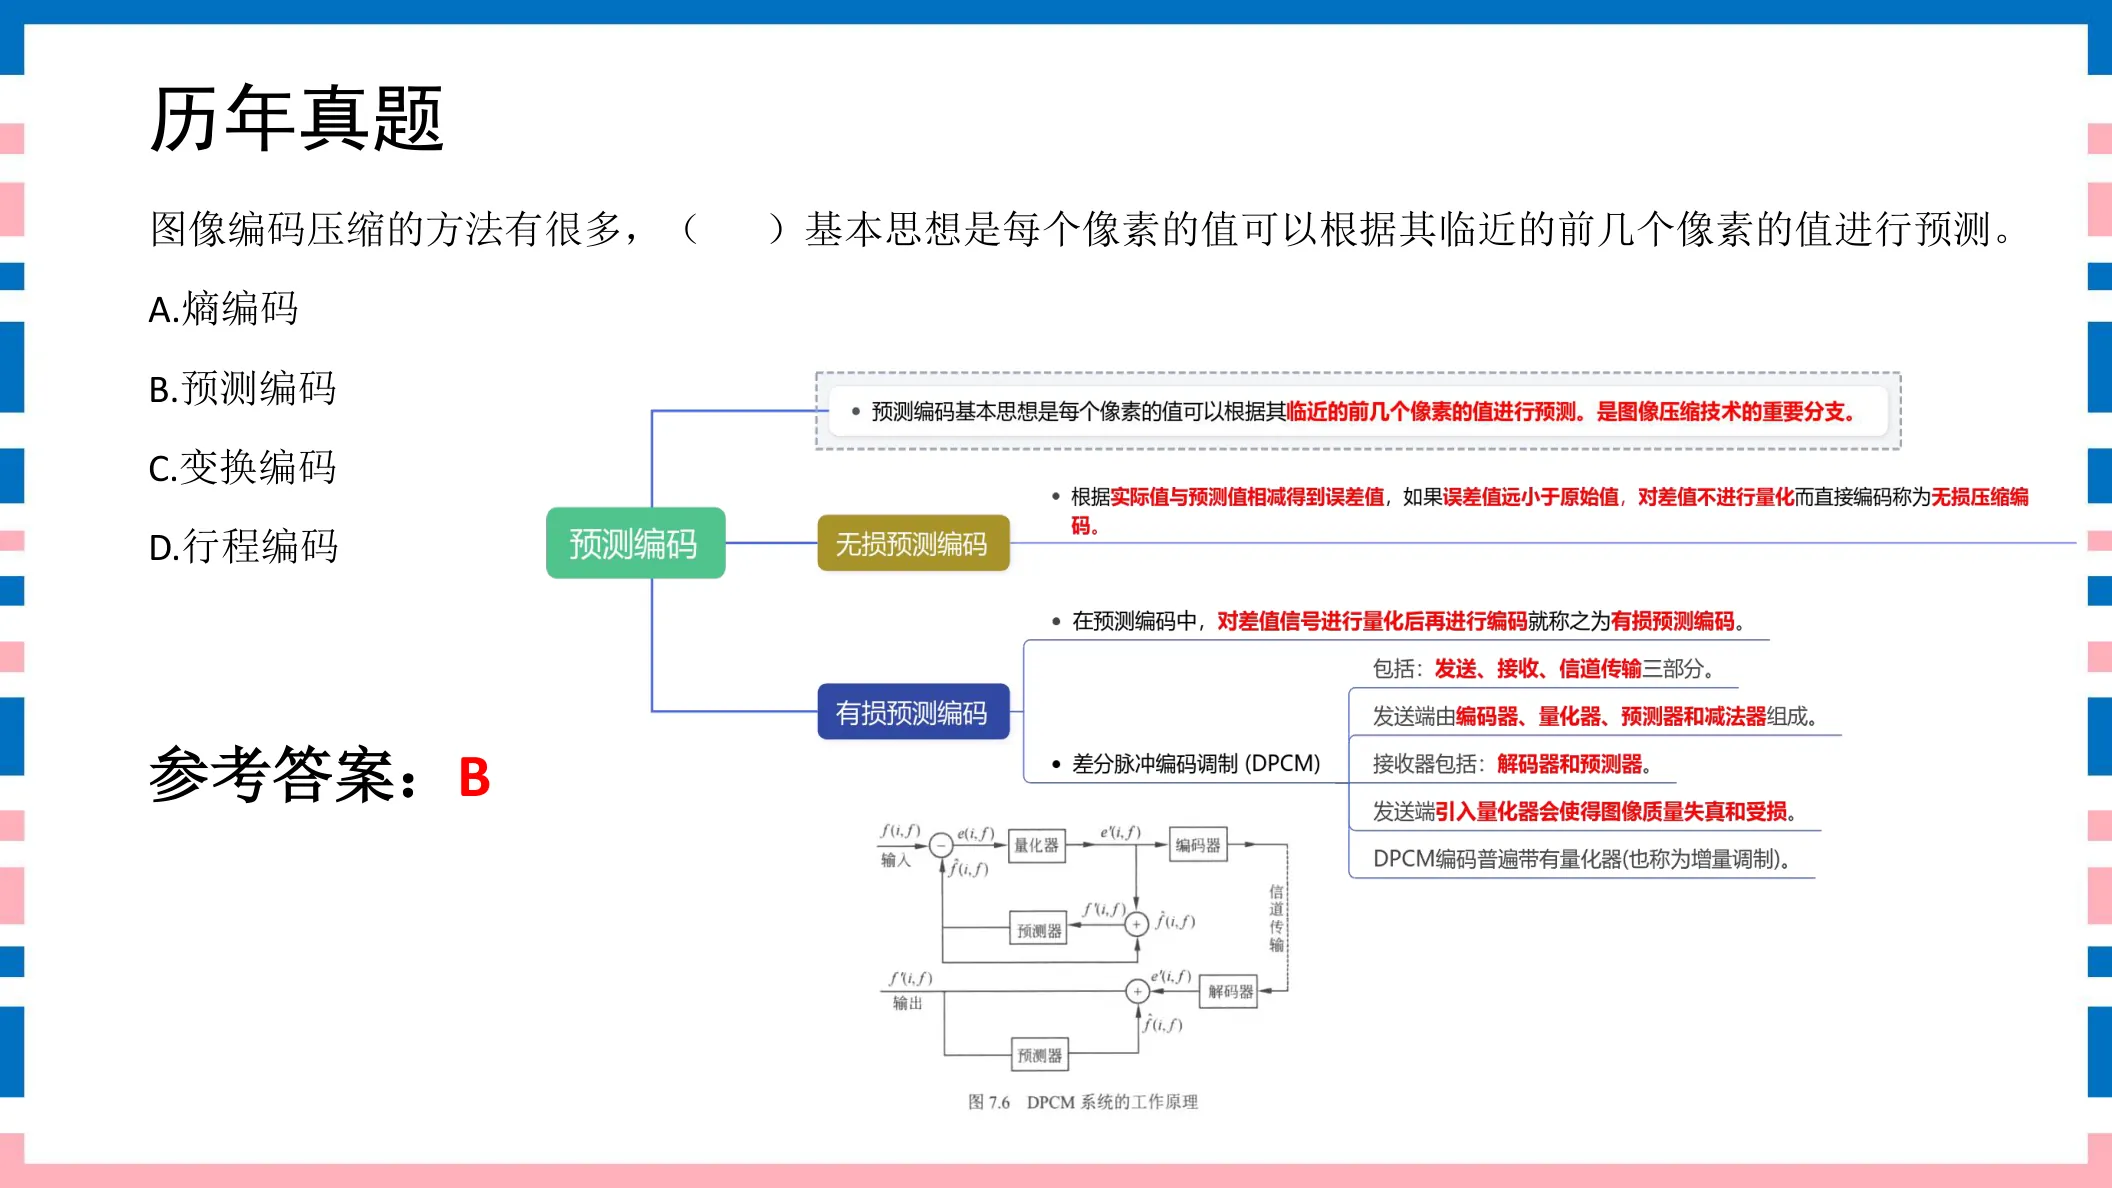
图像编码压缩的方法有很多,( )基本思想是每个像素的值可以根据其临近的前几个像素的值进行预测。A. 熵编码B. 预测编码C. 变换编码D. 行程编码
参考答案:B
◆ 考点:预测编码基本思想:利用相邻离散数据的强相关性,用前面(邻近)像素/样本的值预测当前值,只对实际值与预测值的差值编码(讲义P105)。
◆ 判定:“每个像素根据临近前几个像素预测”=预测编码 → B。熵编码按概率、变换编码换域、行程按游程。
⚠ 易错提示:用前几个值预测当前值、对差值编码=预测编码;这是它区别于熵编码/变换编码的根本。
讲义原页对照 第107页 · 预测编码原理
点击图片可弹层放大查看讲义原页
231分预测编码原理讲义第108页
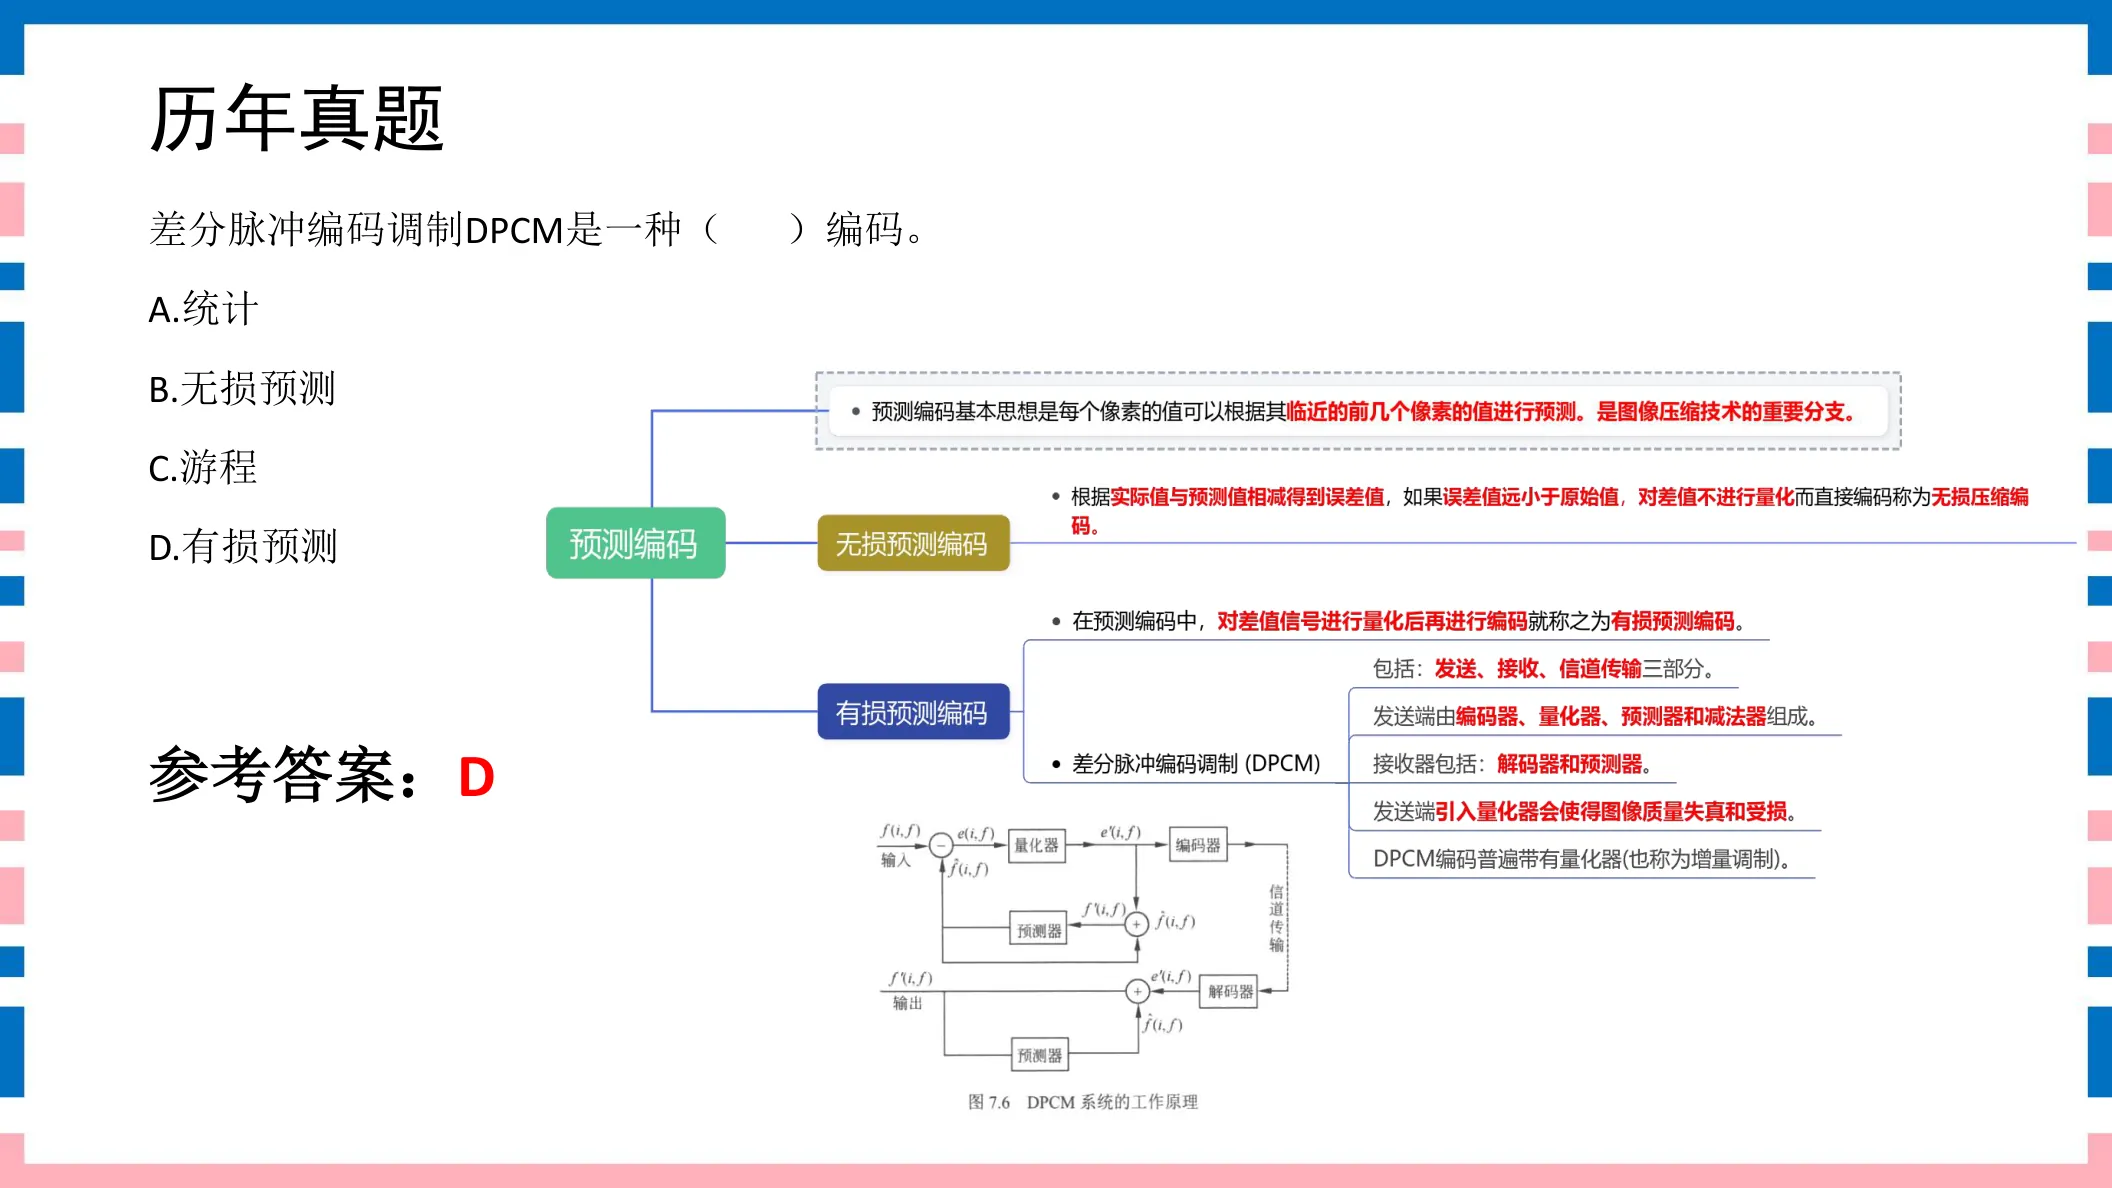
差分脉冲编码调制DPCM是一种( )编码。A. 统计B. 无损预测C. 游程D. 有损预测
参考答案:D
◆ 考点:DPCM(差分脉冲编码调制)因在发端加入量化器,量化误差不可逆,故是一种有损预测编码(讲义P105)。
◆ 判定:DPCM=有损预测编码 → D。统计/游程是统计编码大类,无损预测是不含量化器的情形。
⚠ 易错提示:带量化器=有损预测(DPCM);去掉量化器=无损预测。见到DPCM默认它是“有损预测”。
讲义原页对照 第108页 · 预测编码原理
点击图片可弹层放大查看讲义原页
241分预测编码原理讲义第112页
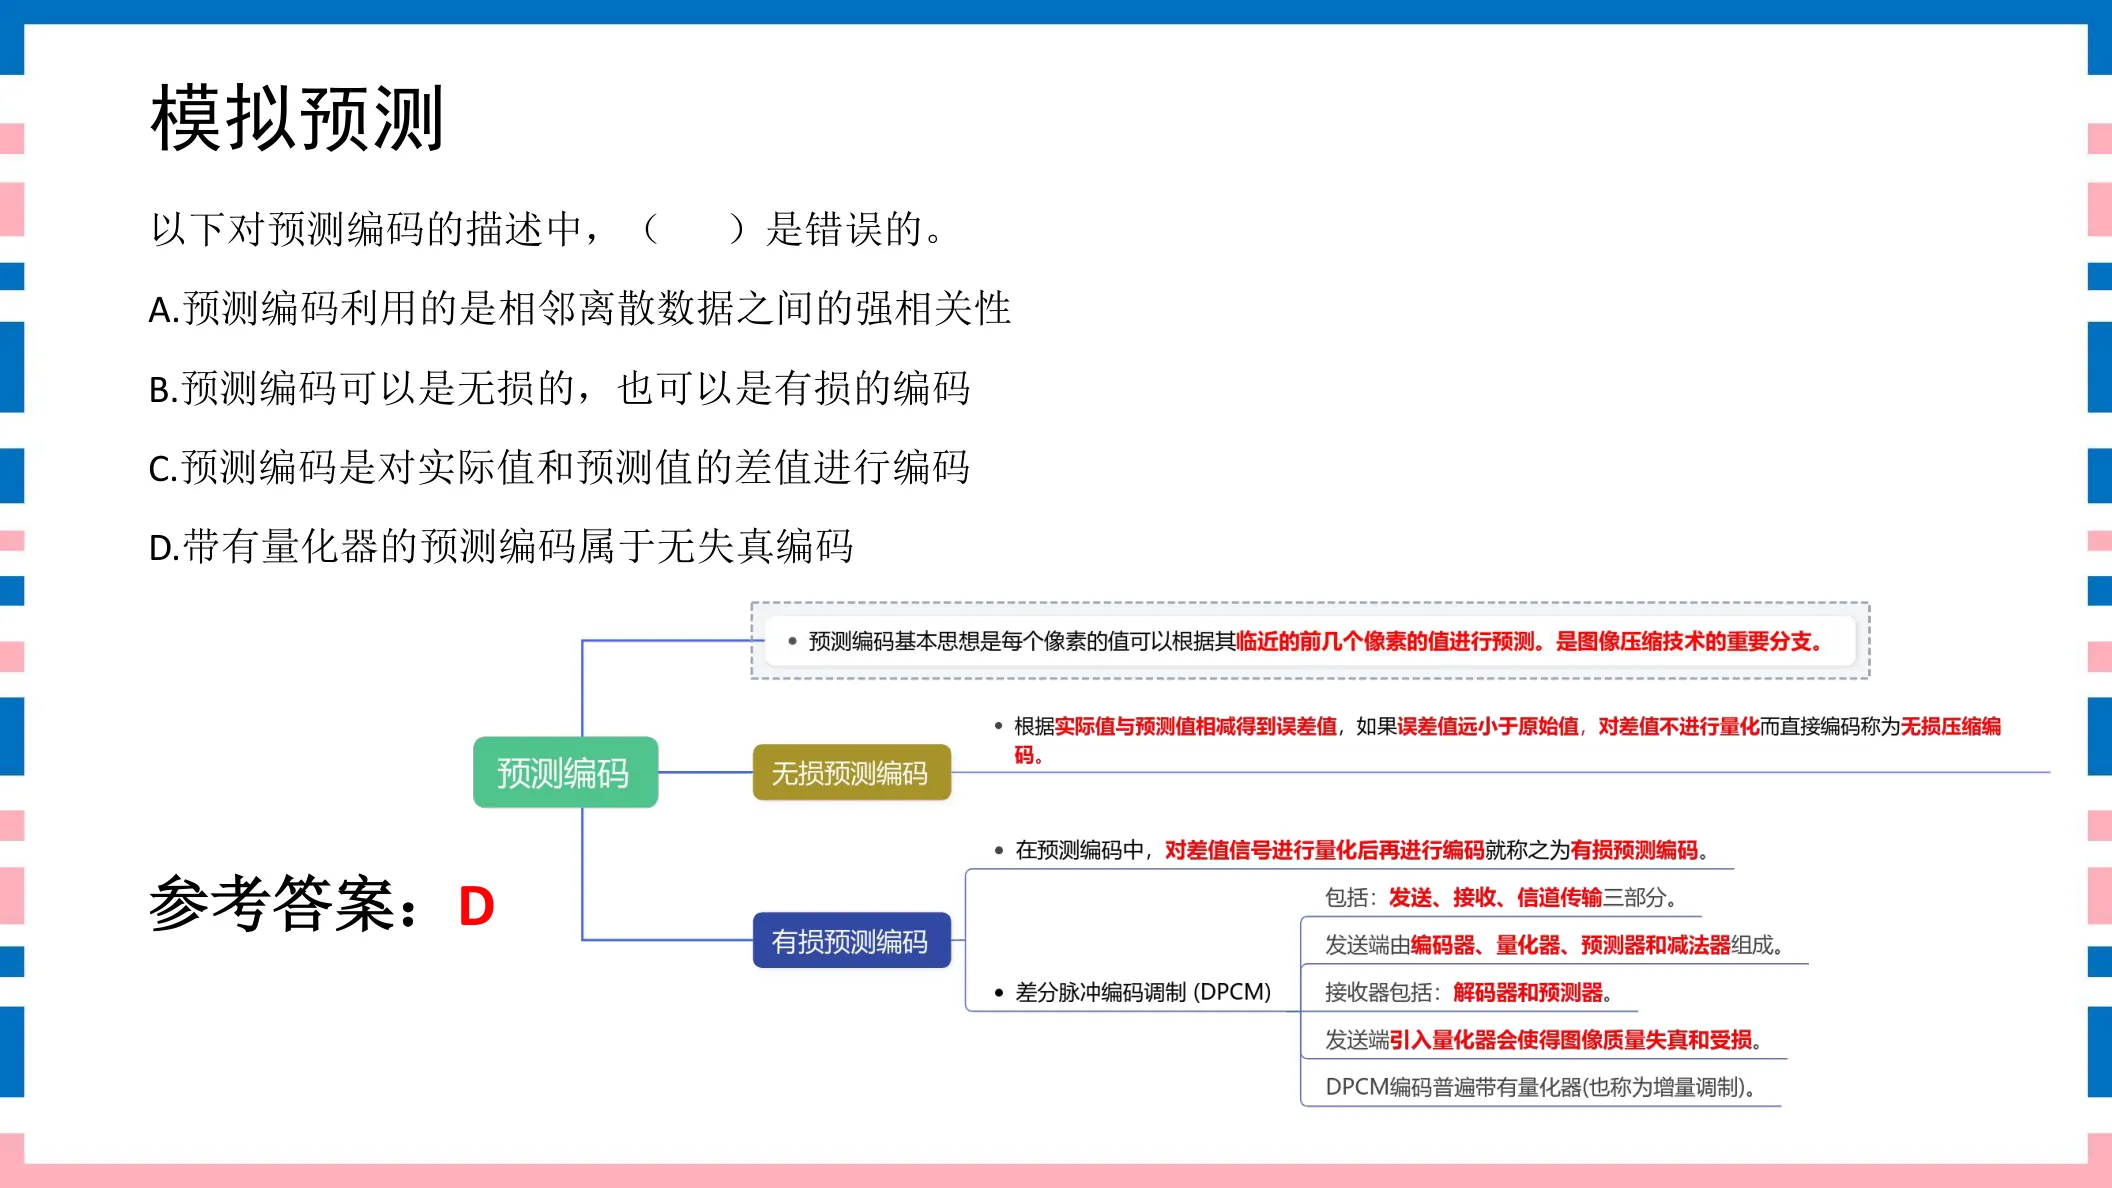
以下对预测编码的描述中,( )是错误的。A. 预测编码利用的是相邻离散数据之间的强相关性B. 预测编码可以是无损的,也可以是有损的编码C. 预测编码是对实际值和预测值的差值进行编码D. 带有量化器的预测编码属于无失真编码
参考答案:D
◆ 考点:预测编码利用相邻数据强相关性、对实际值与预测值之差编码,可无损也可有损;带量化器才是有损(失真),不带量化器为无失真(讲义P105)。
◆ 判定:D“带有量化器的预测编码属于无失真编码”错误——带量化器恰恰是有损 → D。
⚠ 易错提示:有量化器=有损;无量化器=无损。把“带量化”说成“无失真”是说反了,必错。
讲义原页对照 第112页 · 预测编码原理
点击图片可弹层放大查看讲义原页
251分预测编码原理讲义第113页
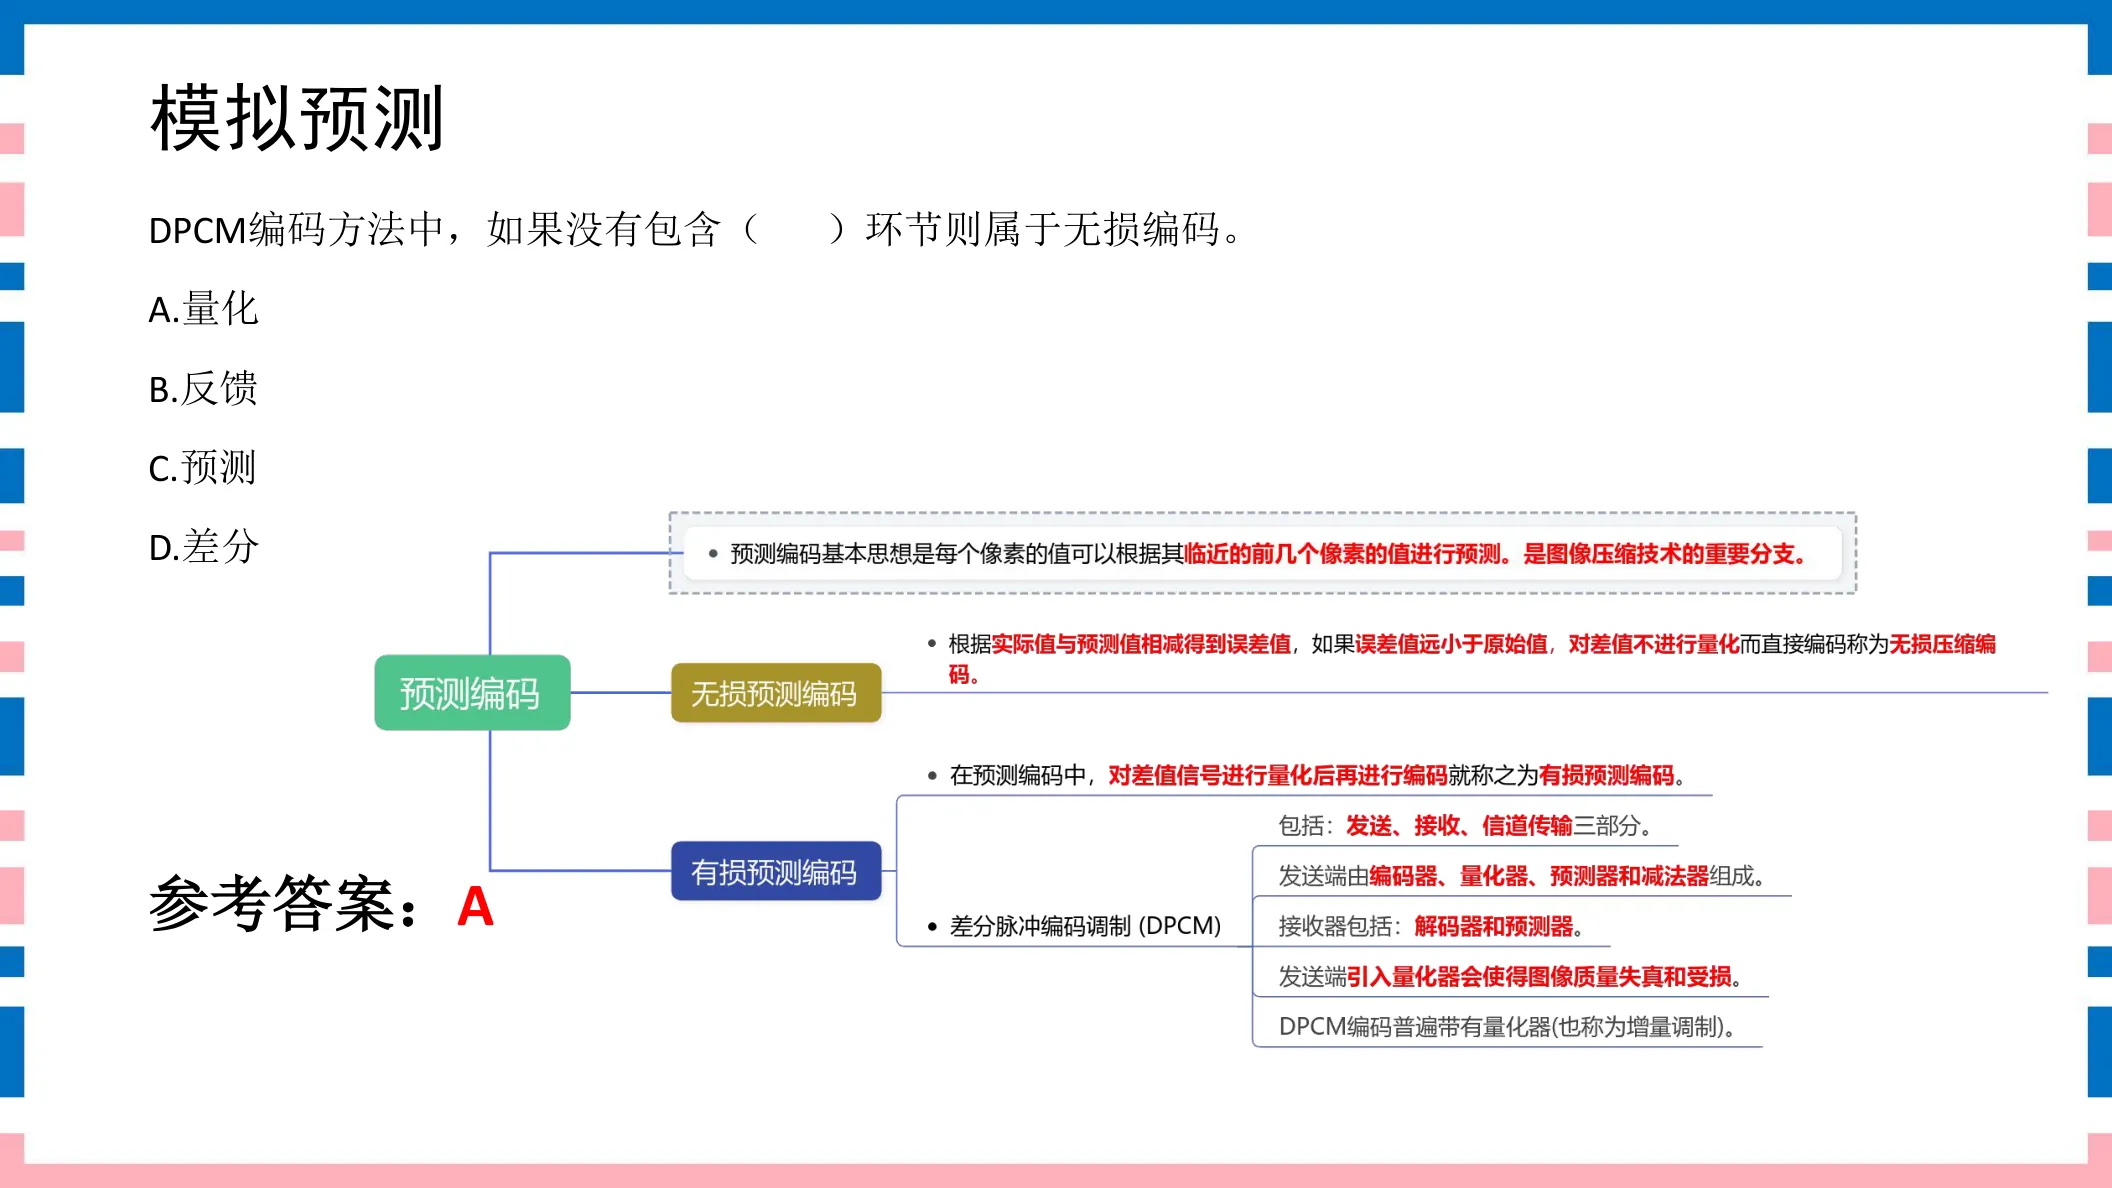
DPCM编码方法中,如果没有包含( )环节则属于无损编码。A. 量化B. 反馈C. 预测D. 差分
参考答案:A
◆ 考点:DPCM之所以有损,全因发端有量化器引入不可逆误差;若不含量化环节,只做预测与差分,则为无损编码(讲义P105)。
◆ 判定:没有包含量化环节即无损 → A。预测、差分是预测编码本身需要的环节,反馈不是关键。
⚠ 易错提示:去掉量化器=无损预测;量化是“有损”的唯一来源。问“哪个环节去掉就无损”,答量化。
讲义原页对照 第113页 · 预测编码原理
点击图片可弹层放大查看讲义原页
261分预测编码原理讲义第114页
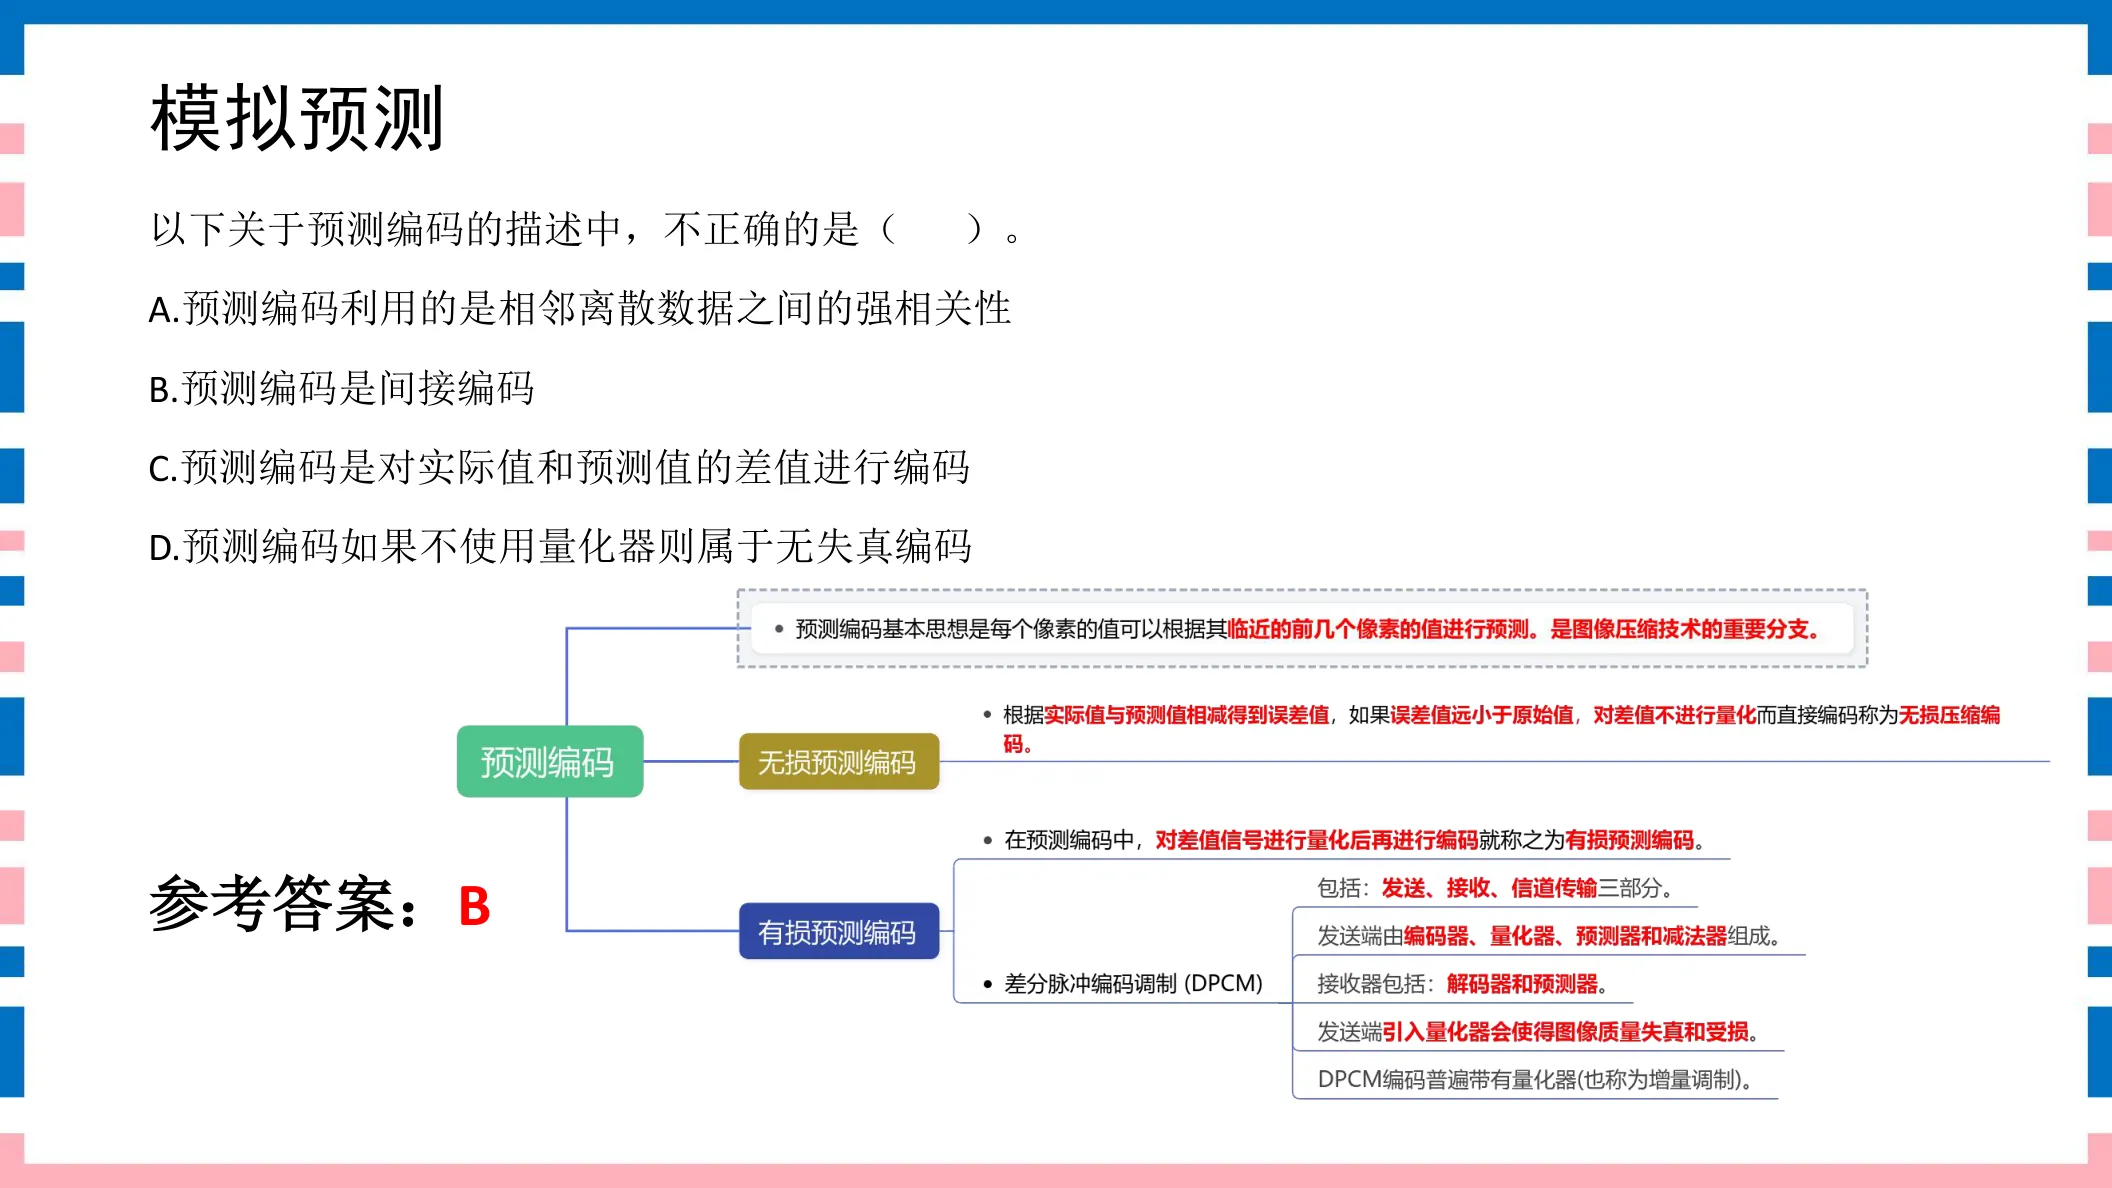
以下关于预测编码的描述中,不正确的是( )。A. 预测编码利用的是相邻离散数据之间的强相关性B. 预测编码是间接编码C. 预测编码是对实际值和预测值的差值进行编码D. 预测编码如果不使用量化器则属于无失真编码
参考答案:B
◆ 考点:预测编码利用相邻相关性、对实际值与预测值差值编码,不用量化器即为无失真;它是直接对(预测)差值编码,不是“间接编码”那种说法(讲义P105)。
◆ 判定:B“预测编码是间接编码”不正确 → B。A/C/D均与讲义一致。
⚠ 易错提示:预测编码是对差值(预测残差)编码;注意“间接编码”这种似是而非的说法是错项。
讲义原页对照 第114页 · 预测编码原理
点击图片可弹层放大查看讲义原页
271分预测编码原理讲义第119页
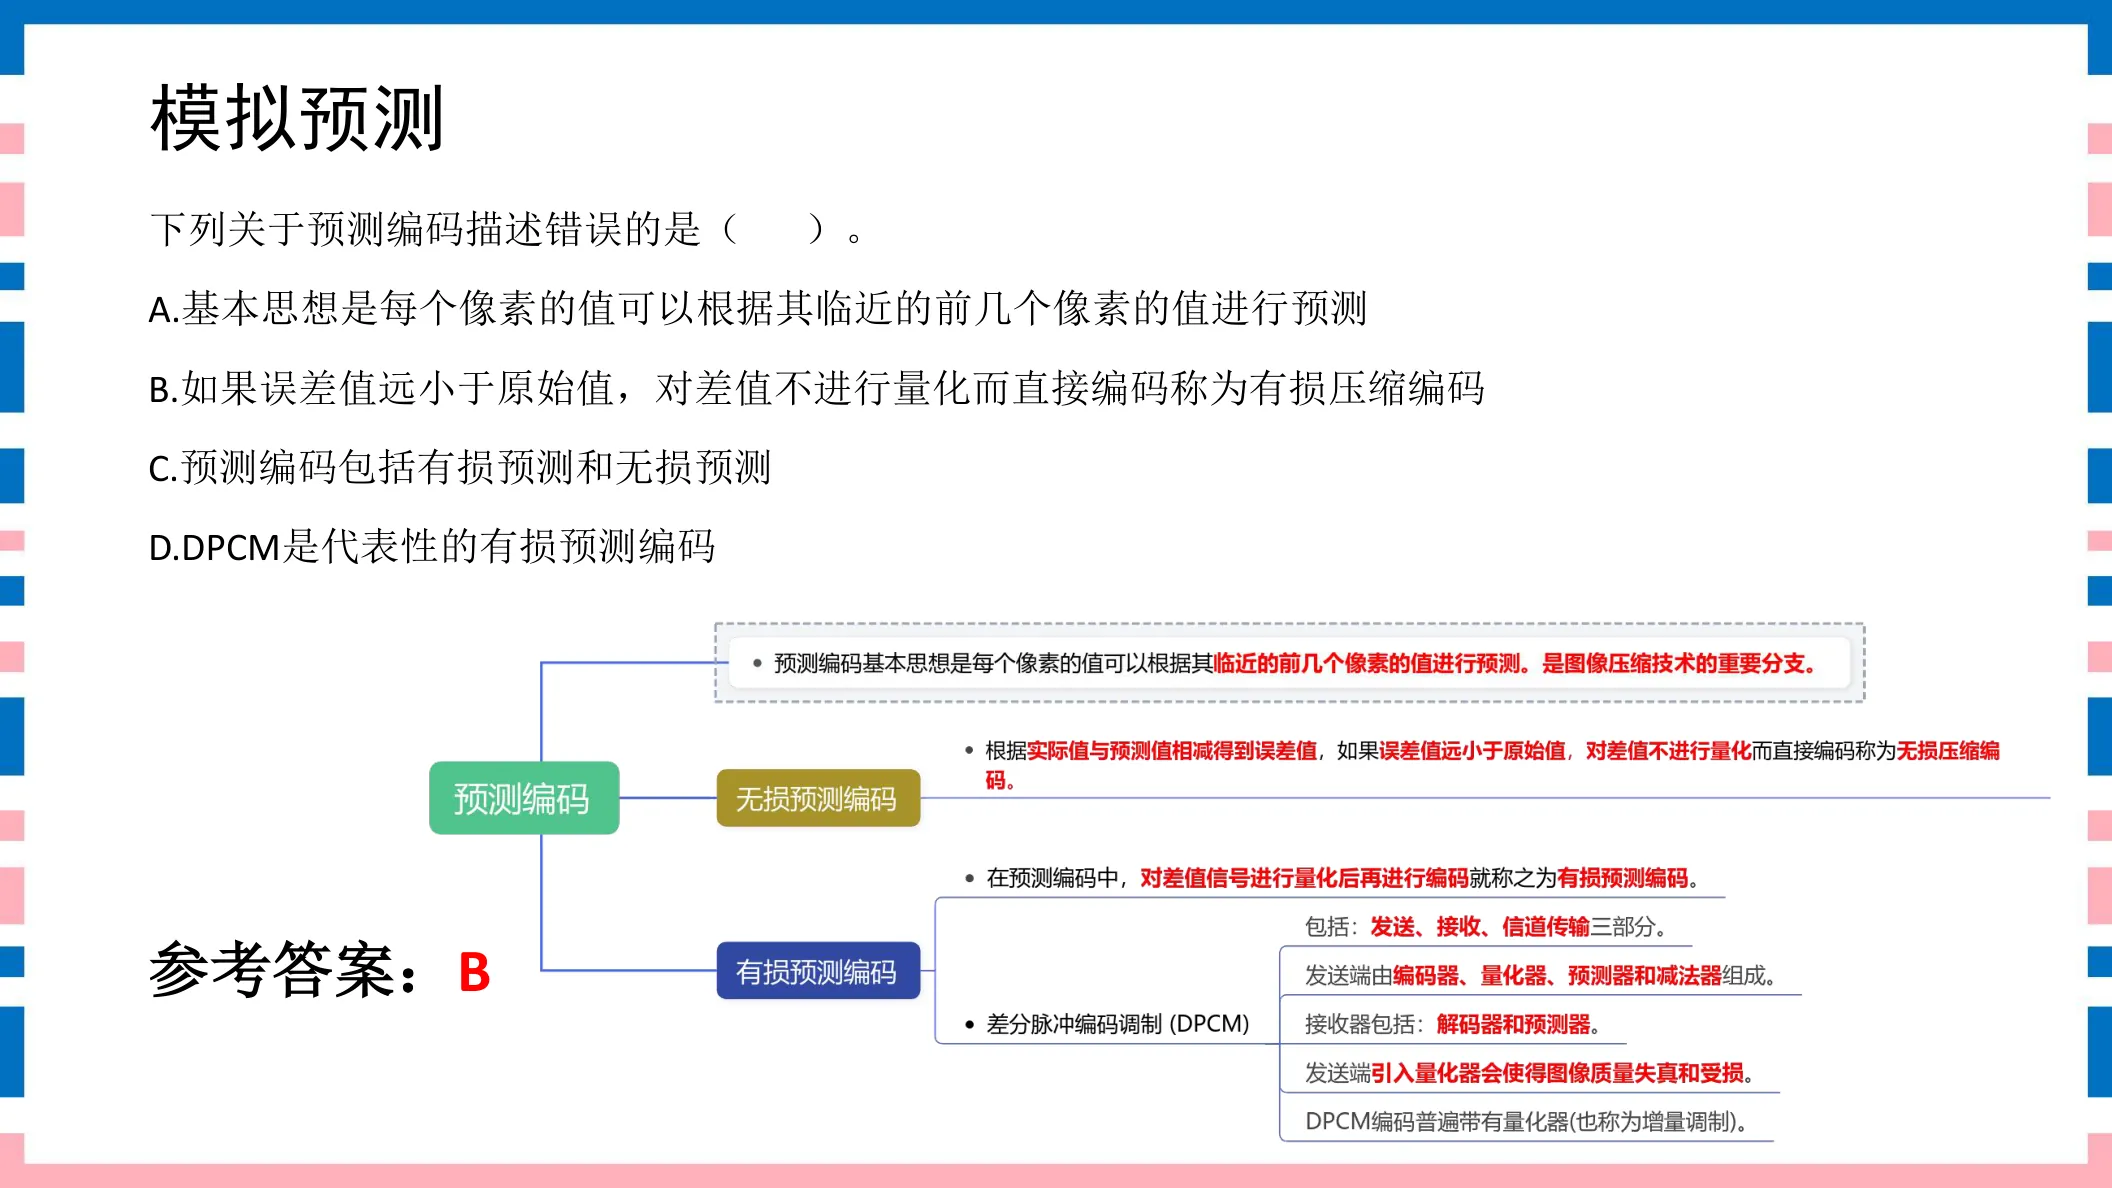
下列关于预测编码描述错误的是( )。A. 基本思想是每个像素的值可以根据其临近的前几个像素的值进行预测B. 如果误差值远小于原始值,对差值不进行量化而直接编码称为有损压缩编码C. 预测编码包括有损预测和无损预测D. DPCM是代表性的有损预测编码
参考答案:B
◆ 考点:预测编码按邻近像素预测当前值、分有损/无损预测两类,DPCM是代表性有损预测编码;对差值“不量化而直接编码”属于无损压缩,不是有损(讲义P105)。
◆ 判定:B“不量化而直接编码称为有损压缩”说反了——那不量化是无损 → B为错误项。
⚠ 易错提示:再记一次:不量化=无损,量化=有损。B把因果颠倒,是典型反向干扰。
讲义原页对照 第119页 · 预测编码原理
点击图片可弹层放大查看讲义原页
增量调制题 28–29 · 2 题
281分增量调制讲义第110页
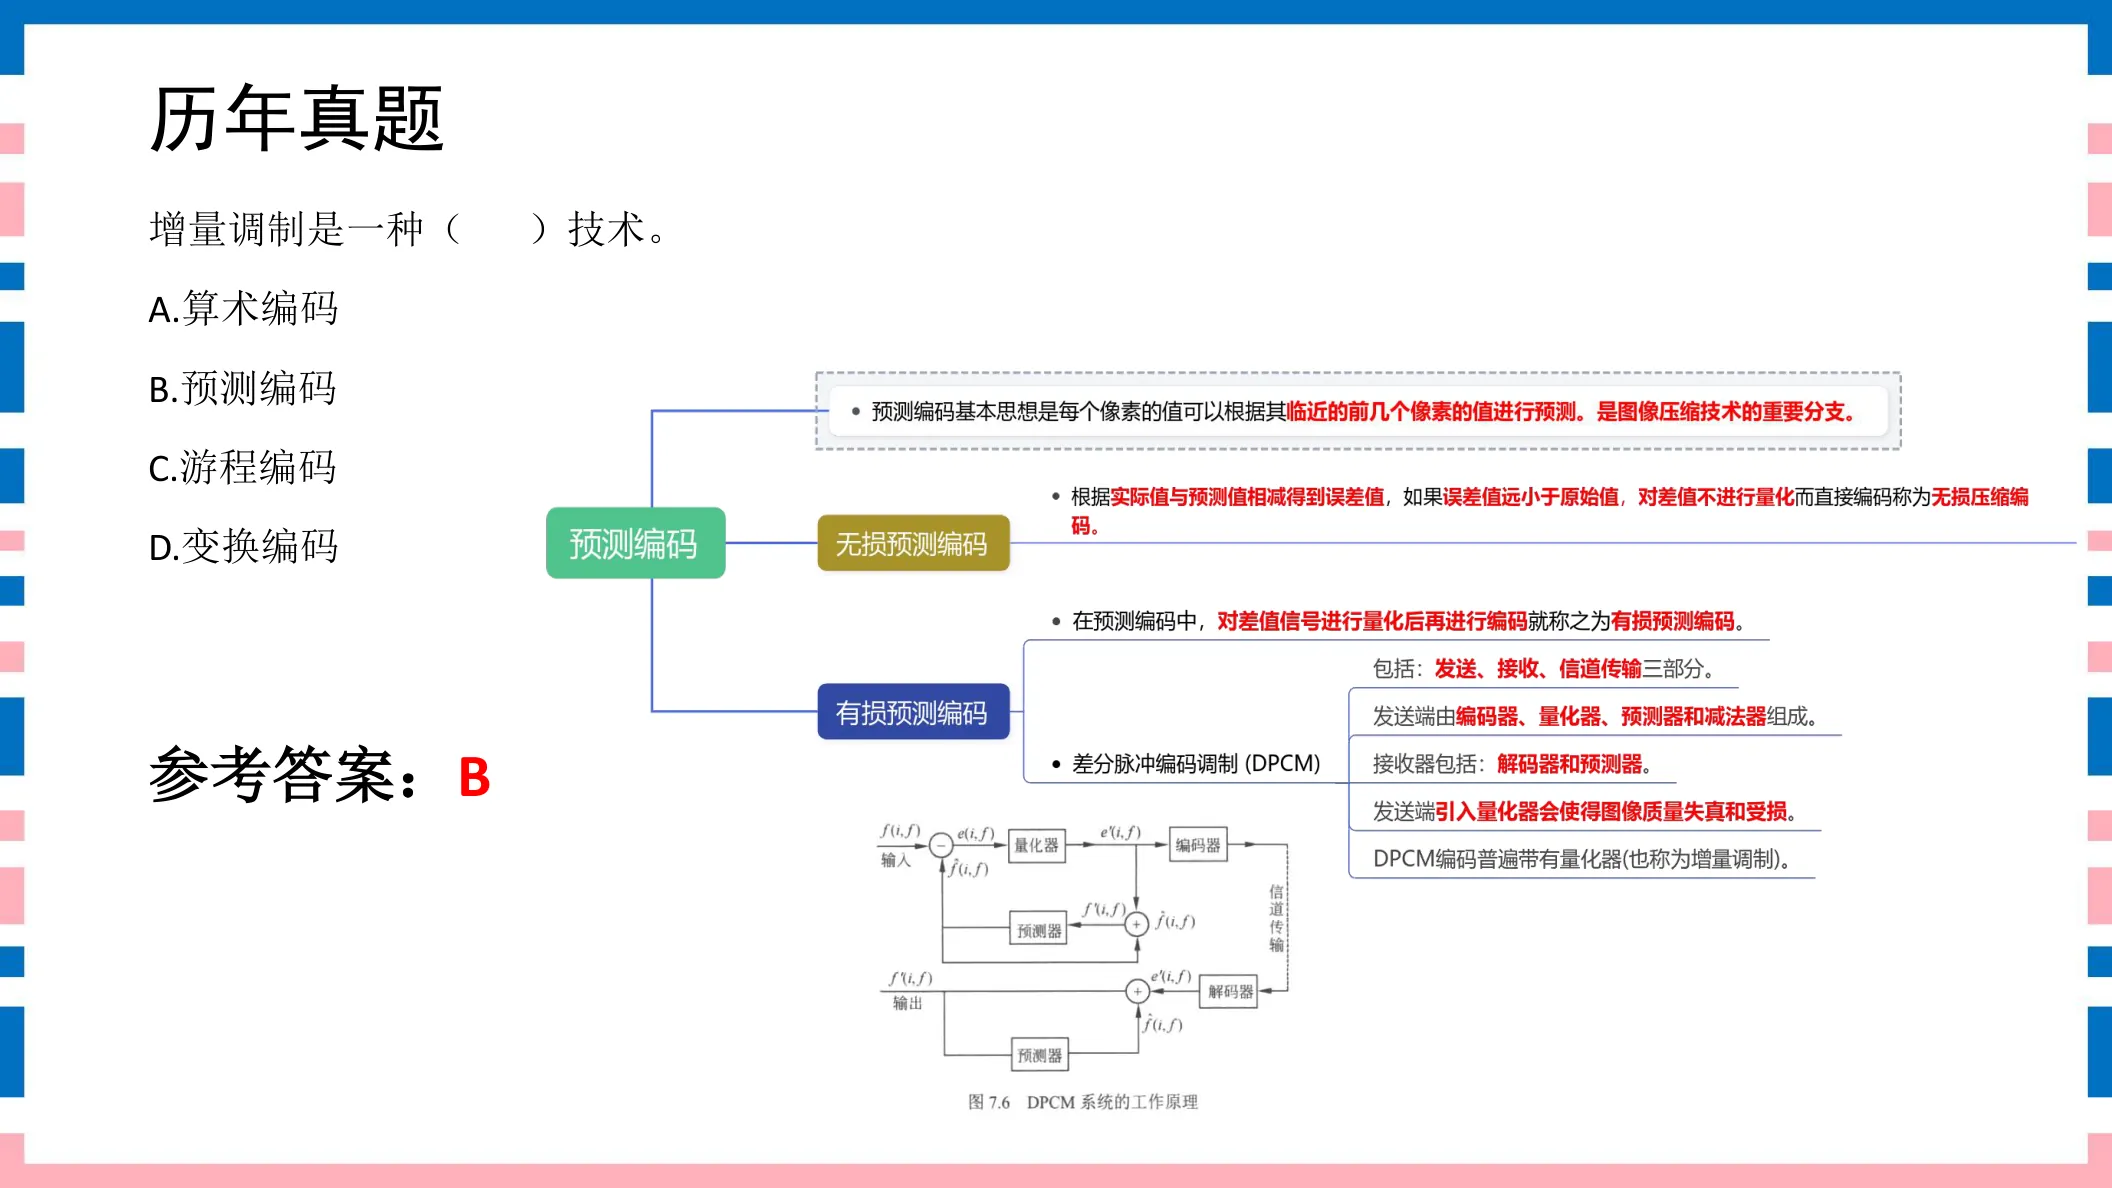
增量调制是一种( )技术。A. 算术编码B. 预测编码C. 游程编码D. 变换编码
参考答案:B
◆ 考点:增量调制(ΔM)只用1位表示当前值相对前一抽样值的增减,是预测编码的一种特例(讲义P105)。
◆ 判定:增量调制=预测编码 → B。算术/游程属统计编码,变换编码是另一大类。
⚠ 易错提示:增量调制(ΔM)=预测编码;别被“调制”二字误导成别的大类。
🔗 关联题:第29题(同考点,建议对比记忆)
讲义原页对照 第110页 · 增量调制
点击图片可弹层放大查看讲义原页
291分增量调制讲义第111页
增量调制属于( )技术。A. 预测编码B. 行程编码C. 分形编码D. 算术编码
参考答案:A
◆ 考点:增量调制是最简单的预测编码,只用前后样本之差的正负(1bit)表示(讲义P105)。
◆ 判定:增量调制属于预测编码 → A。行程/分形/算术均非。
⚠ 易错提示:与第23题同考点:增量调制⇄预测编码,两题选项顺序不同但答案方向一致。
🔗 关联题:第28题(同考点,建议对比记忆)
讲义原页对照 第111页 · 增量调制
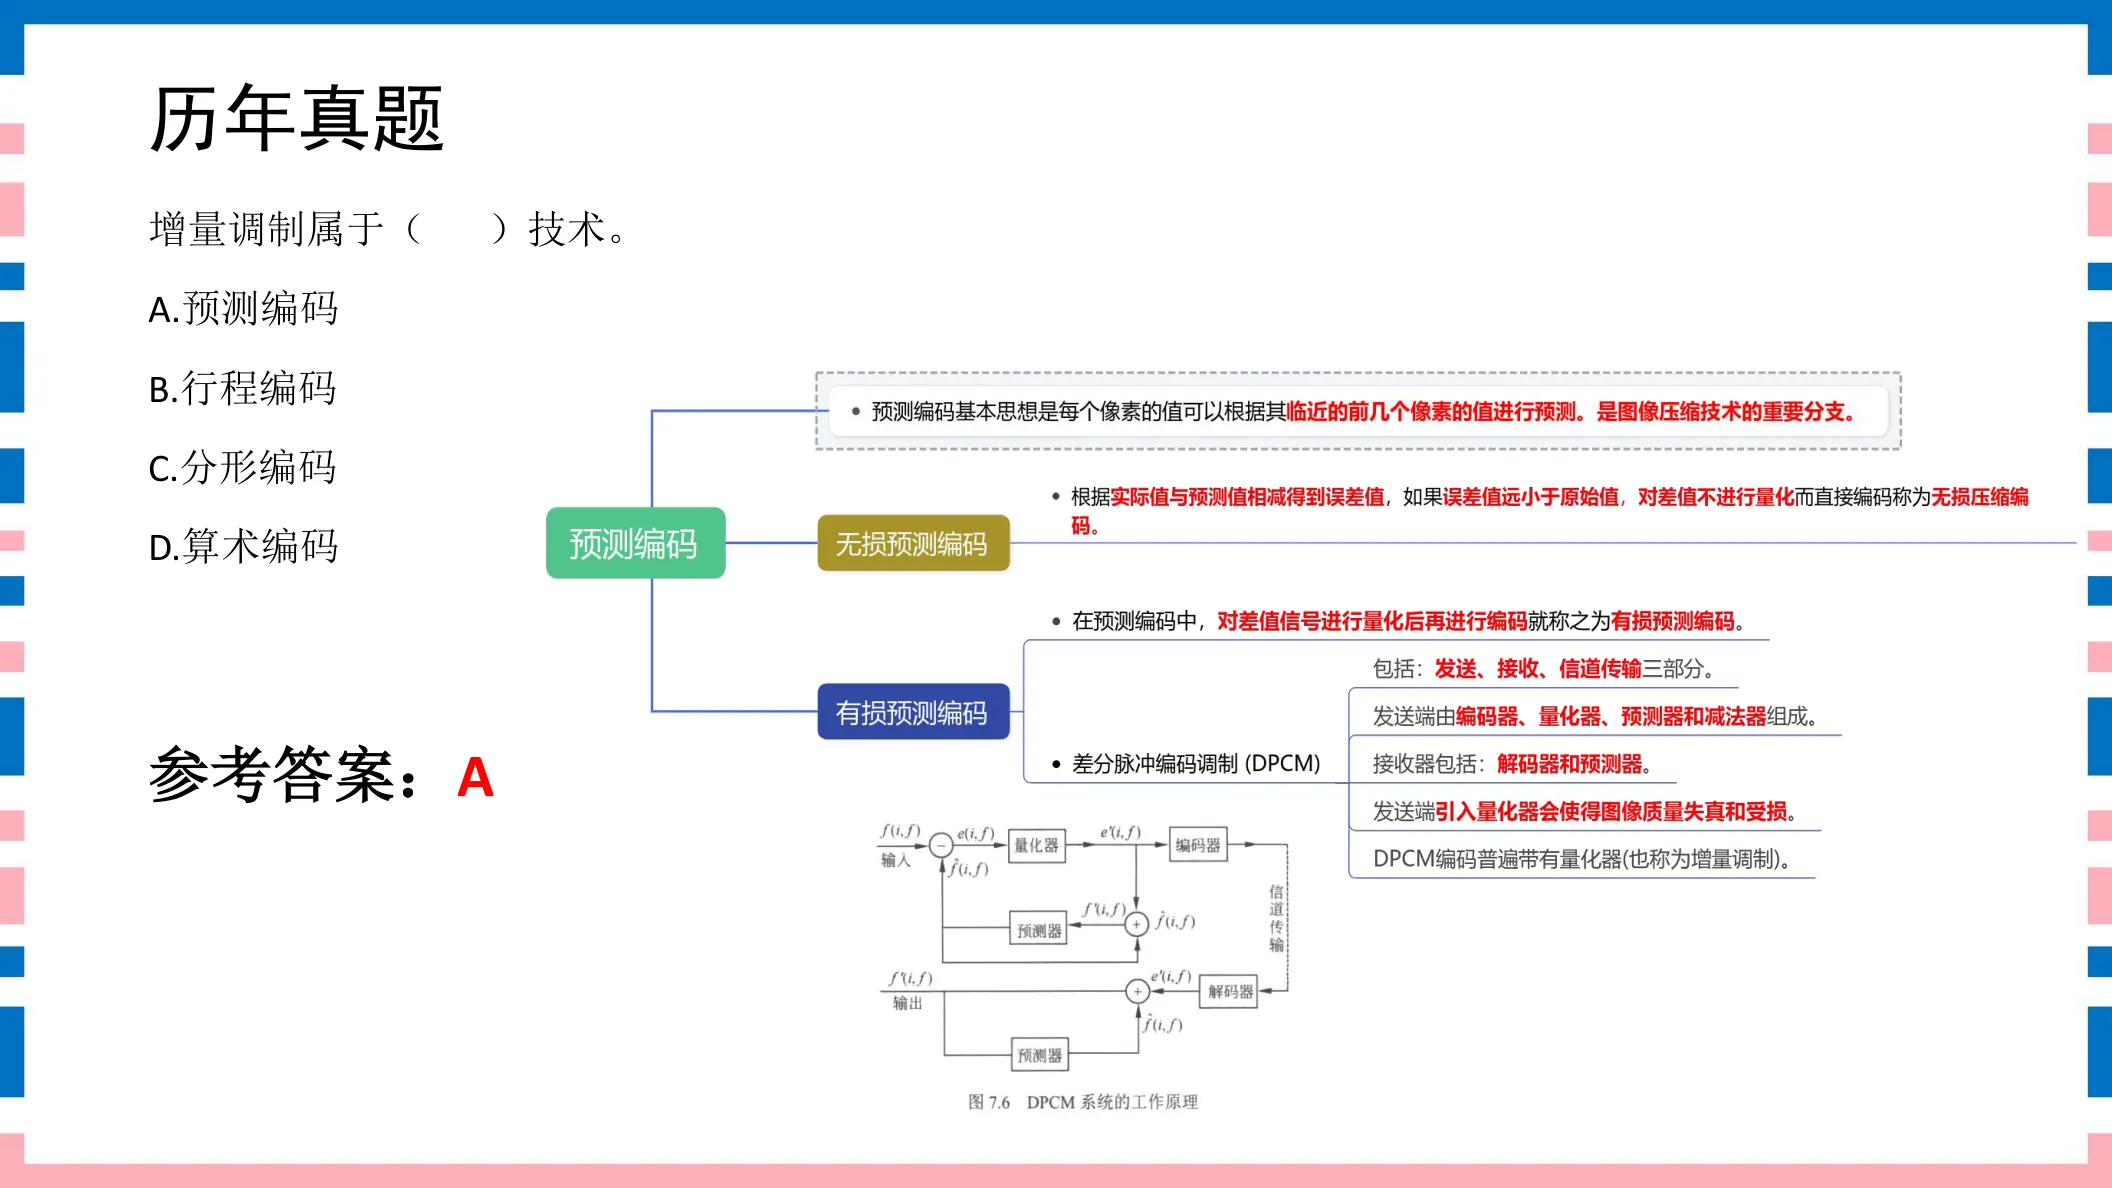
点击图片可弹层放大查看讲义原页
ADPCM题 30–32 · 3 题
301分ADPCM讲义第115页
以下音频编码方法中,( )属于预测编码方法。A. PCM编码B. MP3编码C. 共振峰编码D. ADPCM编码
参考答案:D
◆ 考点:ADPCM(自适应差分脉冲编码调制)在DPCM基础上自适应调整量化步长,是典型的预测类(音频)编码(讲义P105)。
◆ 判定:音频预测编码=ADPCM → D。PCM是未预测的脉冲编码、MP3是变换/感知编码、共振峰是语音参数编码。
⚠ 易错提示:ADPCM=预测编码;PCM只是普通脉冲编码调制,不带“预测/差分”。
讲义原页对照 第115页 · ADPCM
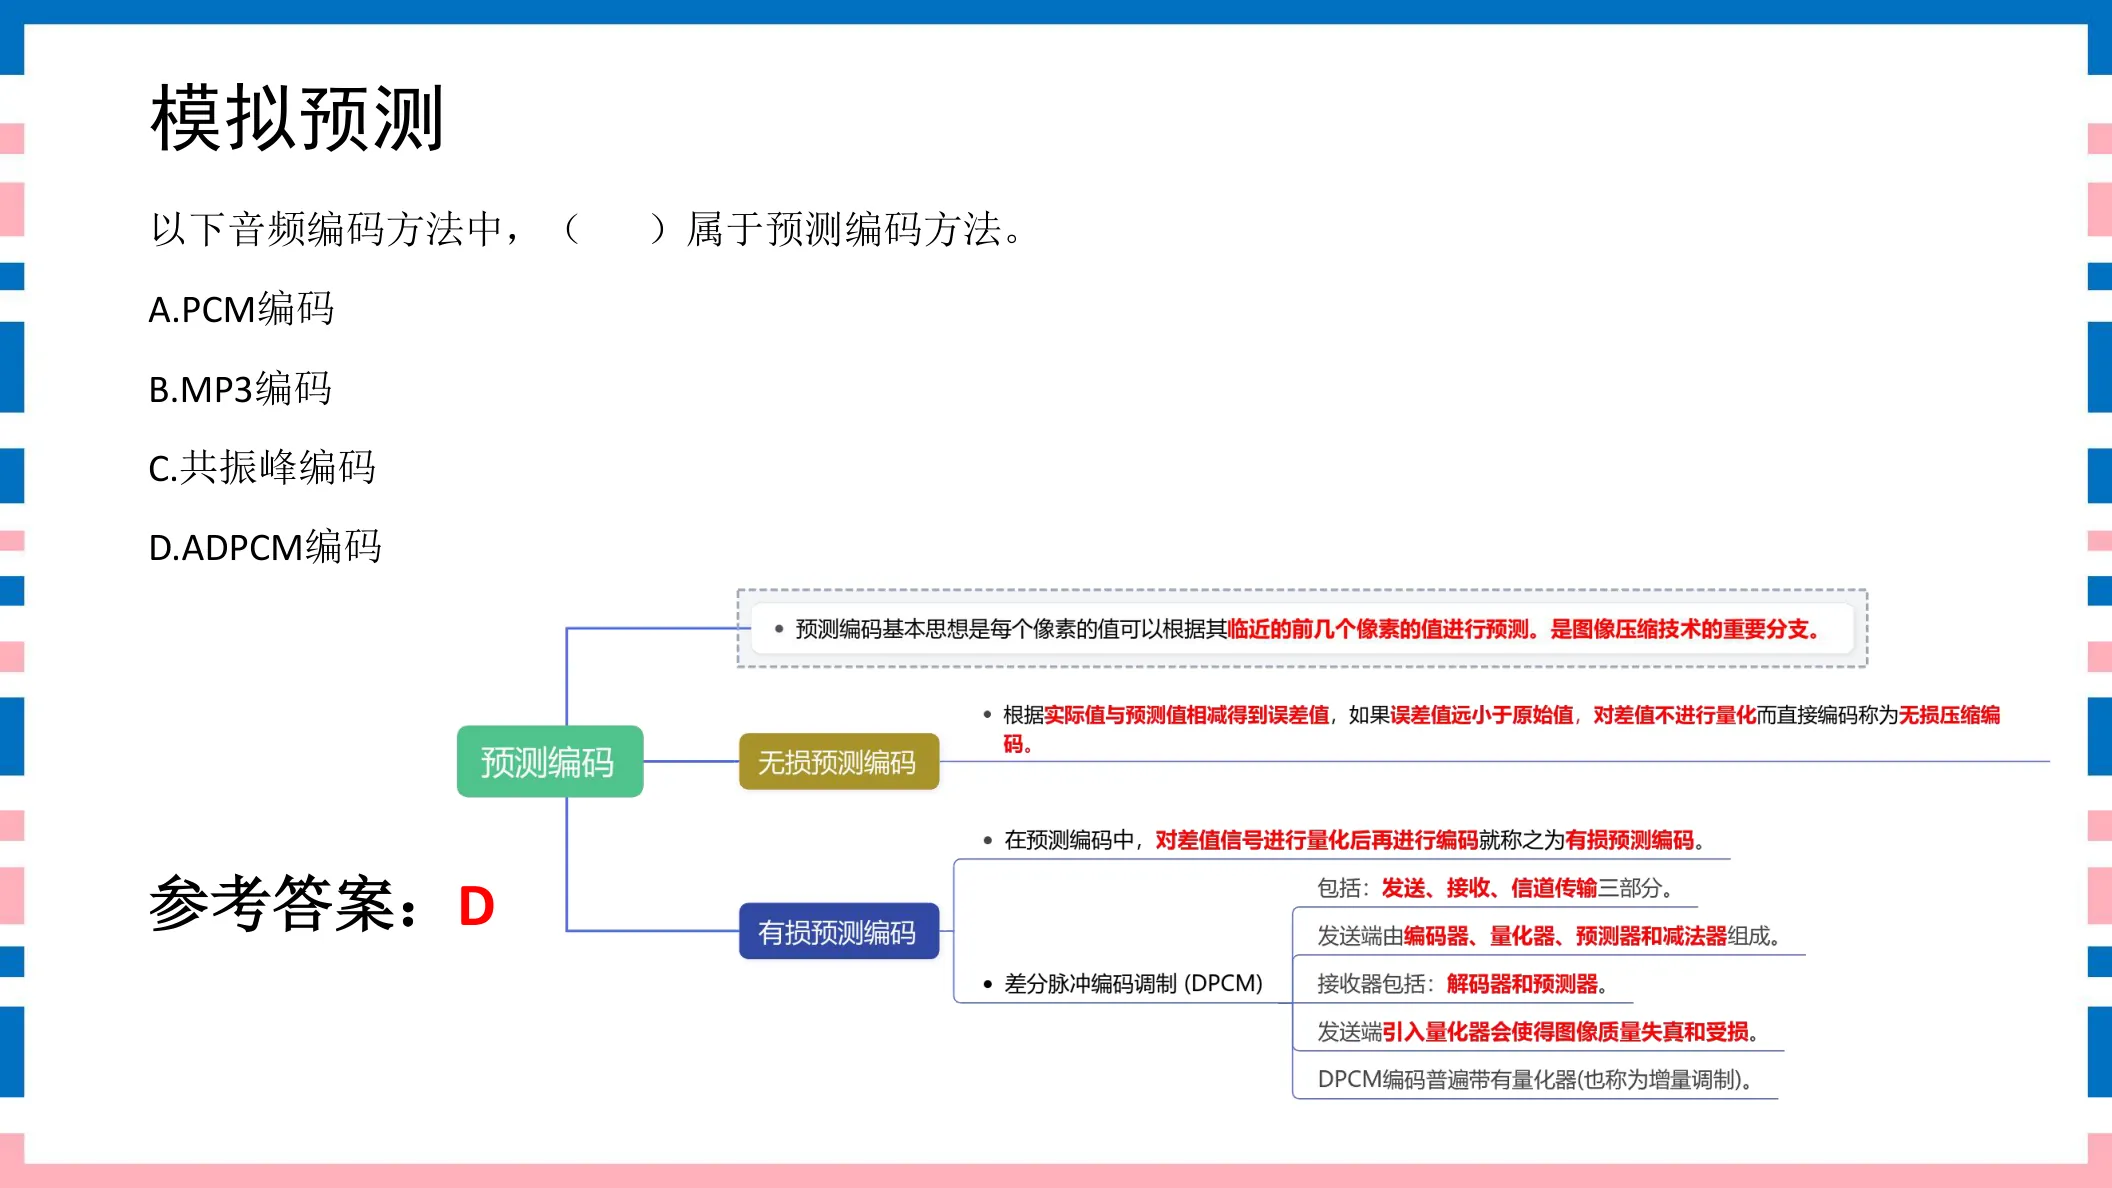
点击图片可弹层放大查看讲义原页
313分ADPCM讲义第116页
ADPCM是一种常用的编码技术,其中“A”指的是(请在A~D选择一个答案) ,“D”指的是(请在E~H选择一个答案),编码的差分特性是指(请在I~L选择一个答案)。A. 量化B. 自适应C. 差分D. 调制E. 量化F. 自适应G. 差分H. 调制I. 对实际信号之间的差值进行量化编码J. 对预测值信号之间的差值进行量化编码K. 对实际信号值与预测值之差进行量化编码L. 对当前信号测量值和下一个信号测量值之差进行量化编码
参考答案:BGK
◆ 考点:ADPCM=Adaptive(自适应)+Differential(差分)+PCM;“差分特性”指对实际信号值与预测值之差进行量化编码(讲义P116)。
◆ 判定:“A”=自适应(B);“D”=差分(G);差分特性=对实际信号值与预测值之差量化编码(K) → BGK。
⚠ 易错提示:三字母逐一对:A=自适应、D=差分;差分特性是“实际值−预测值”,不是“两实测值之差”也不是“预测值之间之差”。
讲义原页对照 第116页 · ADPCM
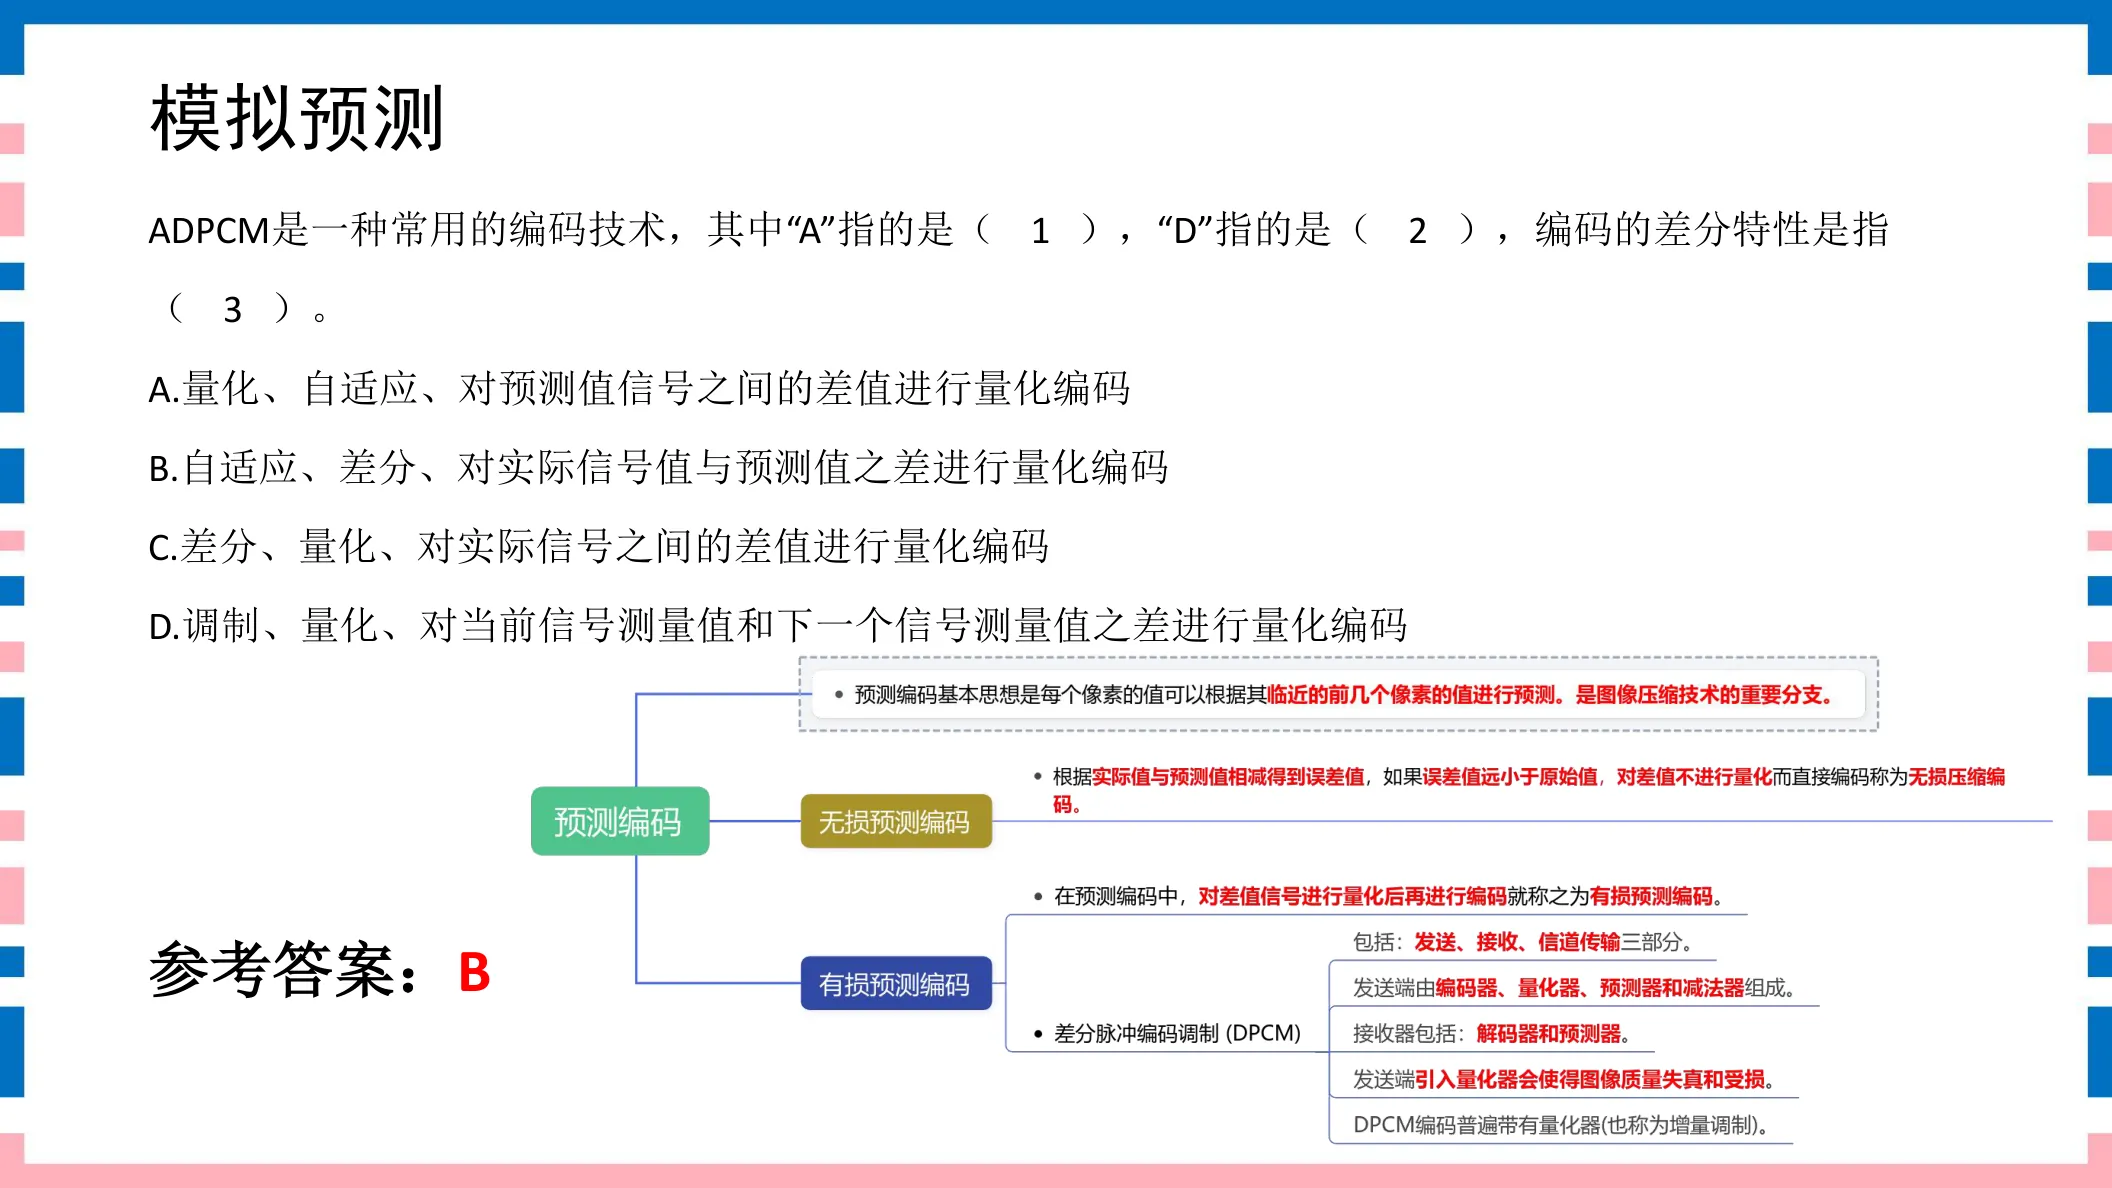
点击图片可弹层放大查看讲义原页
321分ADPCM讲义第117页
在声音数据的数字化过程中,可以采用ADPCM编码的方法,ADPCM编码中的差分特性是指( )。A. 对信号值进行量化编码B. 对预测值进行量化编码C. 对实际信号值和预测值之差进行量化编码D. 对当前信号值和下一个信号量值之差进行量化编码
参考答案:C
◆ 考点:ADPCM的“差分”特性=对实际信号值与预测值之差(预测残差)进行量化编码(讲义P117)。
◆ 判定:C“对实际信号值和预测值之差进行量化编码”正确 → C。只对信号值/只对预测值、以及“当前与下一个测量值之差”均错。
⚠ 易错提示:差分=实际值−预测值;不是“相邻两个实测值相减”,也不是单纯量化信号值或预测值。
讲义原页对照 第117页 · ADPCM
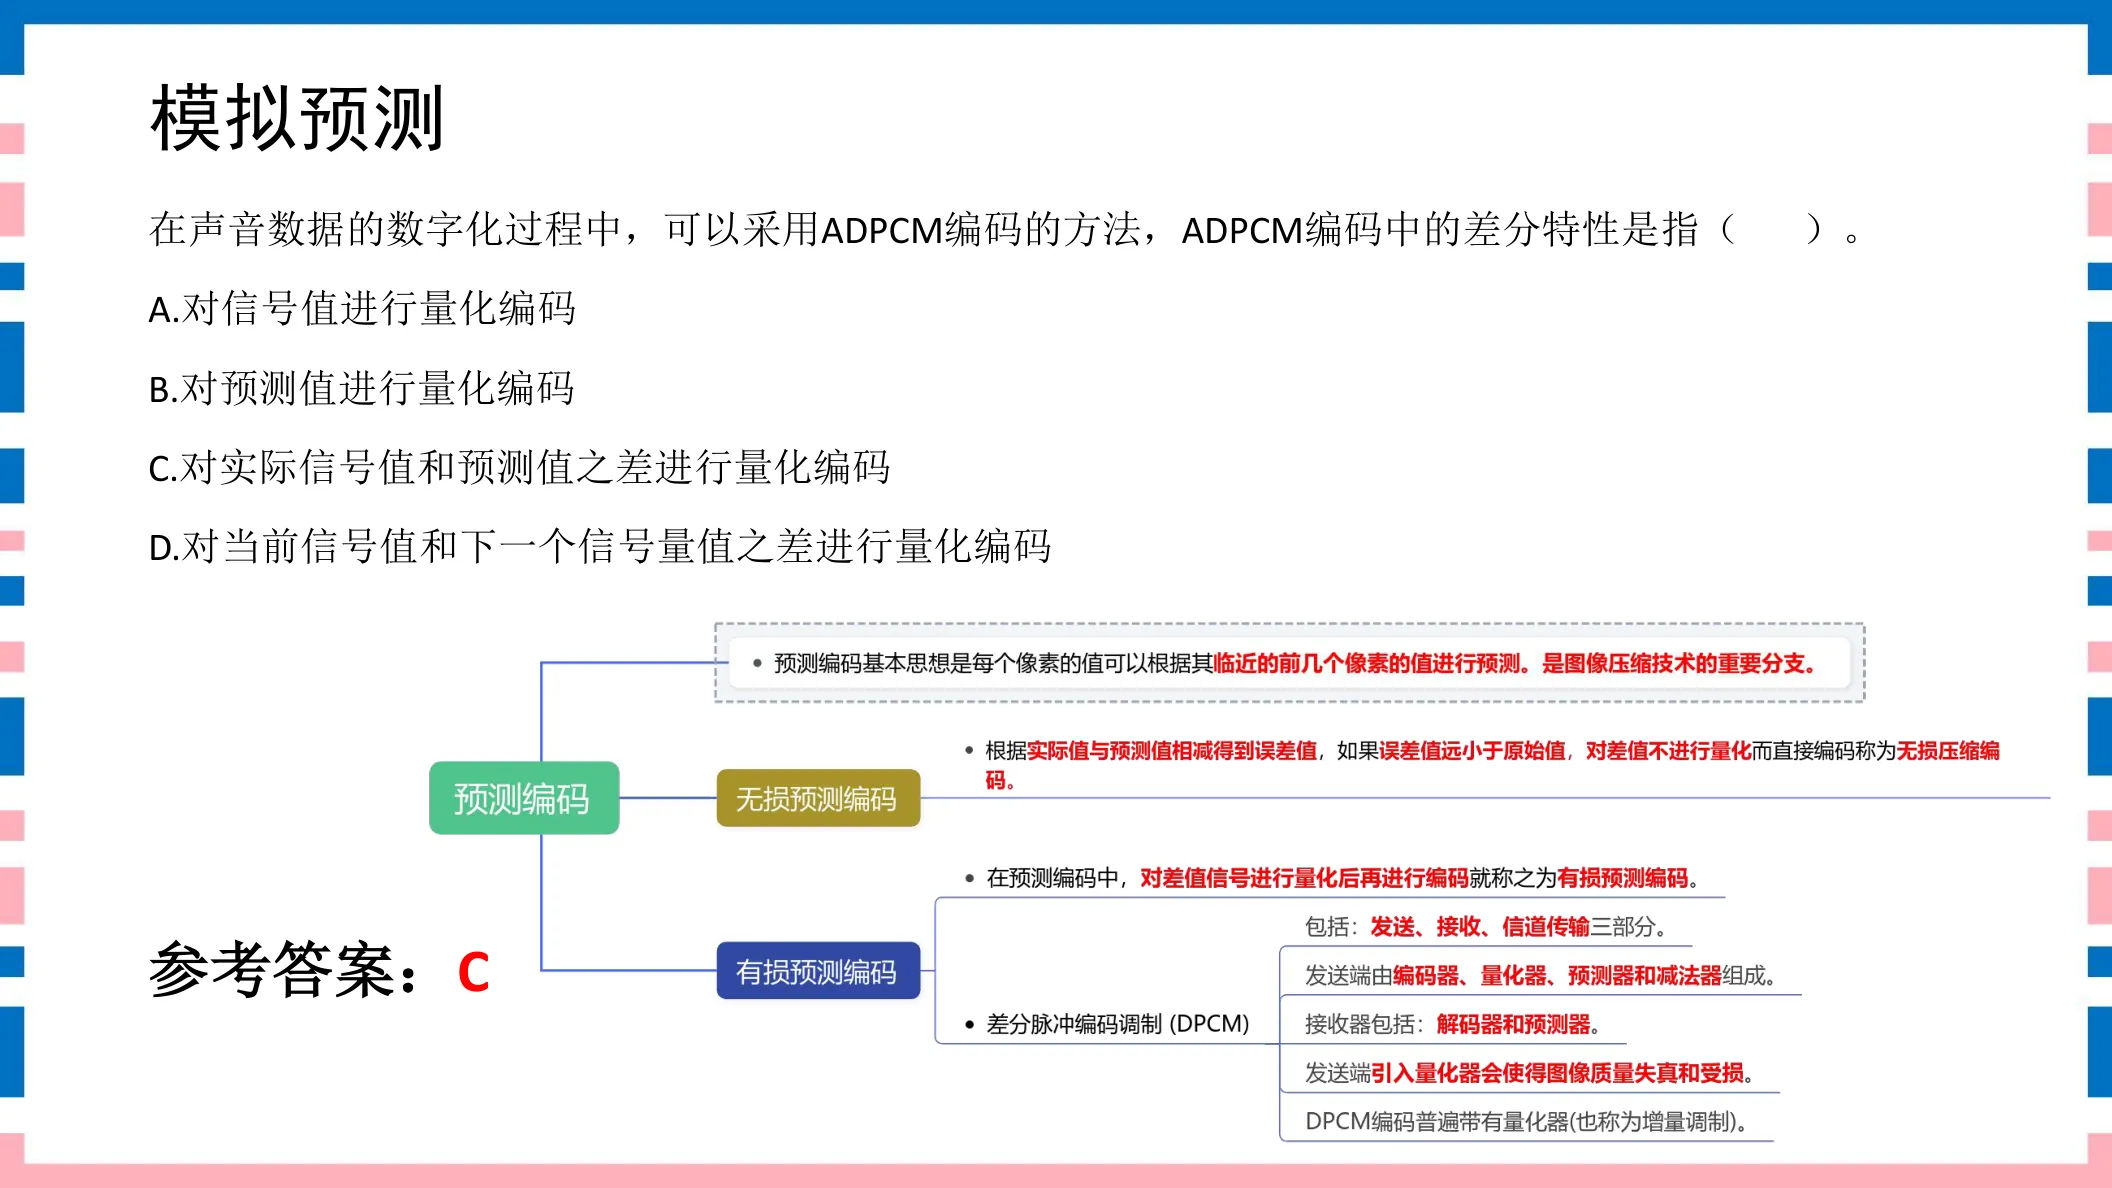
点击图片可弹层放大查看讲义原页
DCT变换题 33–34 · 2 题
331分DCT变换讲义第122页
离散余弦变化DCT进行编码过程中,接收端经过( )后得到重建图像。A. 编码、解码、量化B. 解码、反量化、逆变换C. 变化、量化、解码D. 反量化、变化、解码
参考答案:B
◆ 考点:DCT变换编码流程:发端分块→DCT→量化→熵编码传输;收端经解码→反量化→逆变换(IDCT)得到重建图像(讲义P121)。
◆ 判定:接收端顺序=解码、反量化、逆变换 → B。
⚠ 易错提示:收发镜像相反:发端“变换→量化→编码”,收端“解码→反量化→逆变换”。别把发端步骤顺到收端。
🔗 关联题:第34题(同考点,建议对比记忆)
讲义原页对照 第122页 · DCT变换
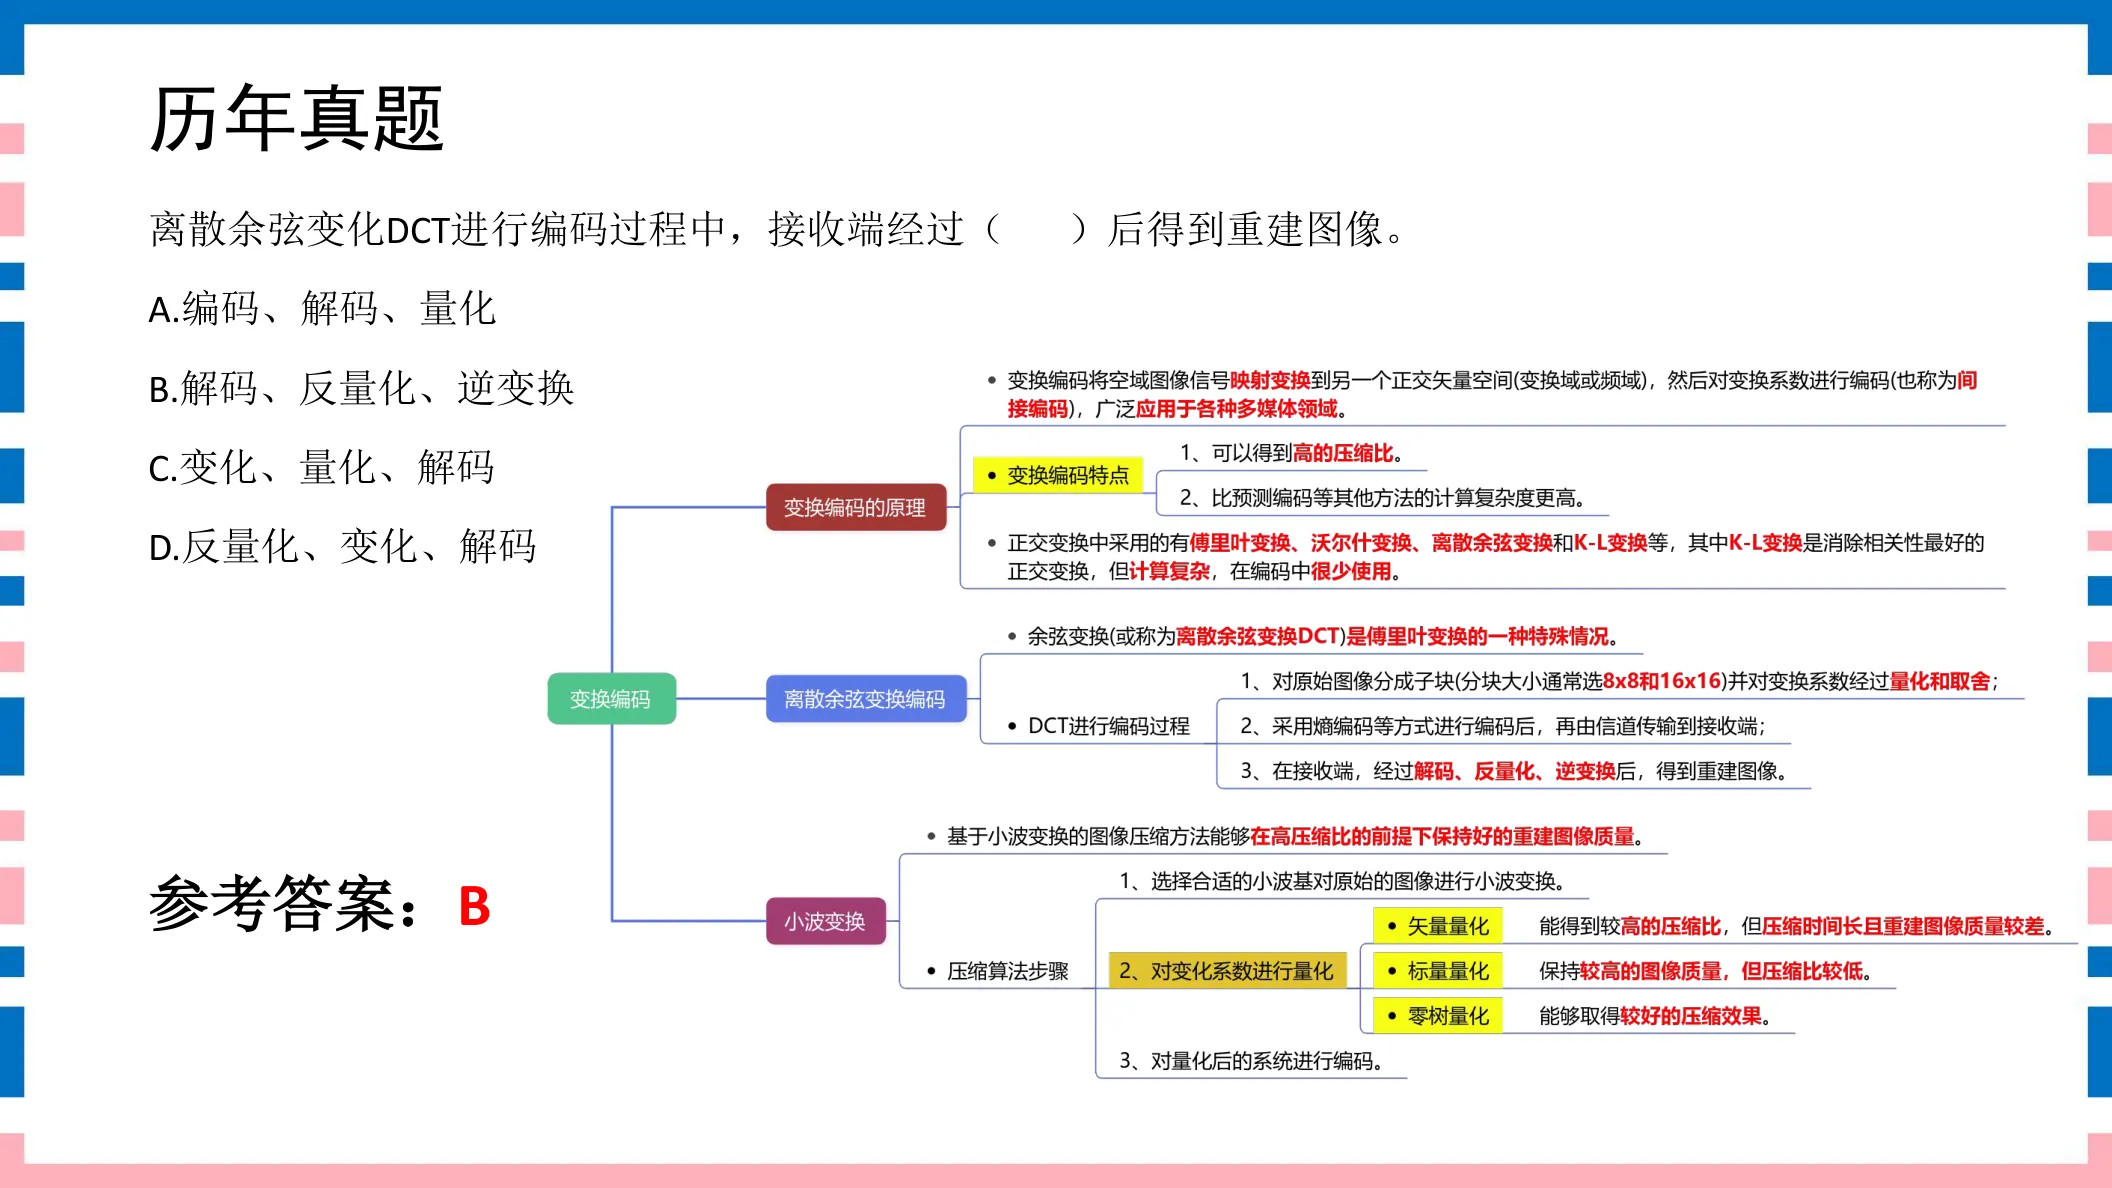
点击图片可弹层放大查看讲义原页
341分DCT变换讲义第128页
关于DCT变换编码描述正确的是( )。A. 对原始图像分块大小通常选4x4和12x12B. 需要对原始图像变换系数进行反量化C. 采用熵编码等方式进行编码再由信道传输到接收端D. 在接收端经过解码、量化、逆变换得到重建图像
参考答案:C
◆ 考点:DCT流程:图像分块→DCT→对变换系数量化→再经熵编码后由信道传输到接收端;接收端经解码、反量化、逆变换重建(讲义P128、P121)。
◆ 判定:C“采用熵编码等方式编码再由信道传输到接收端”正确 → C。分块常用8×8(非4×4/12×12)、反量化在收端,故A/B/D错。
⚠ 易错提示:DCT标准分块是8×8;收端才做反量化,发端做量化。顺序别颠倒。
🔗 关联题:第33题(同考点,建议对比记忆)
讲义原页对照 第128页 · DCT变换
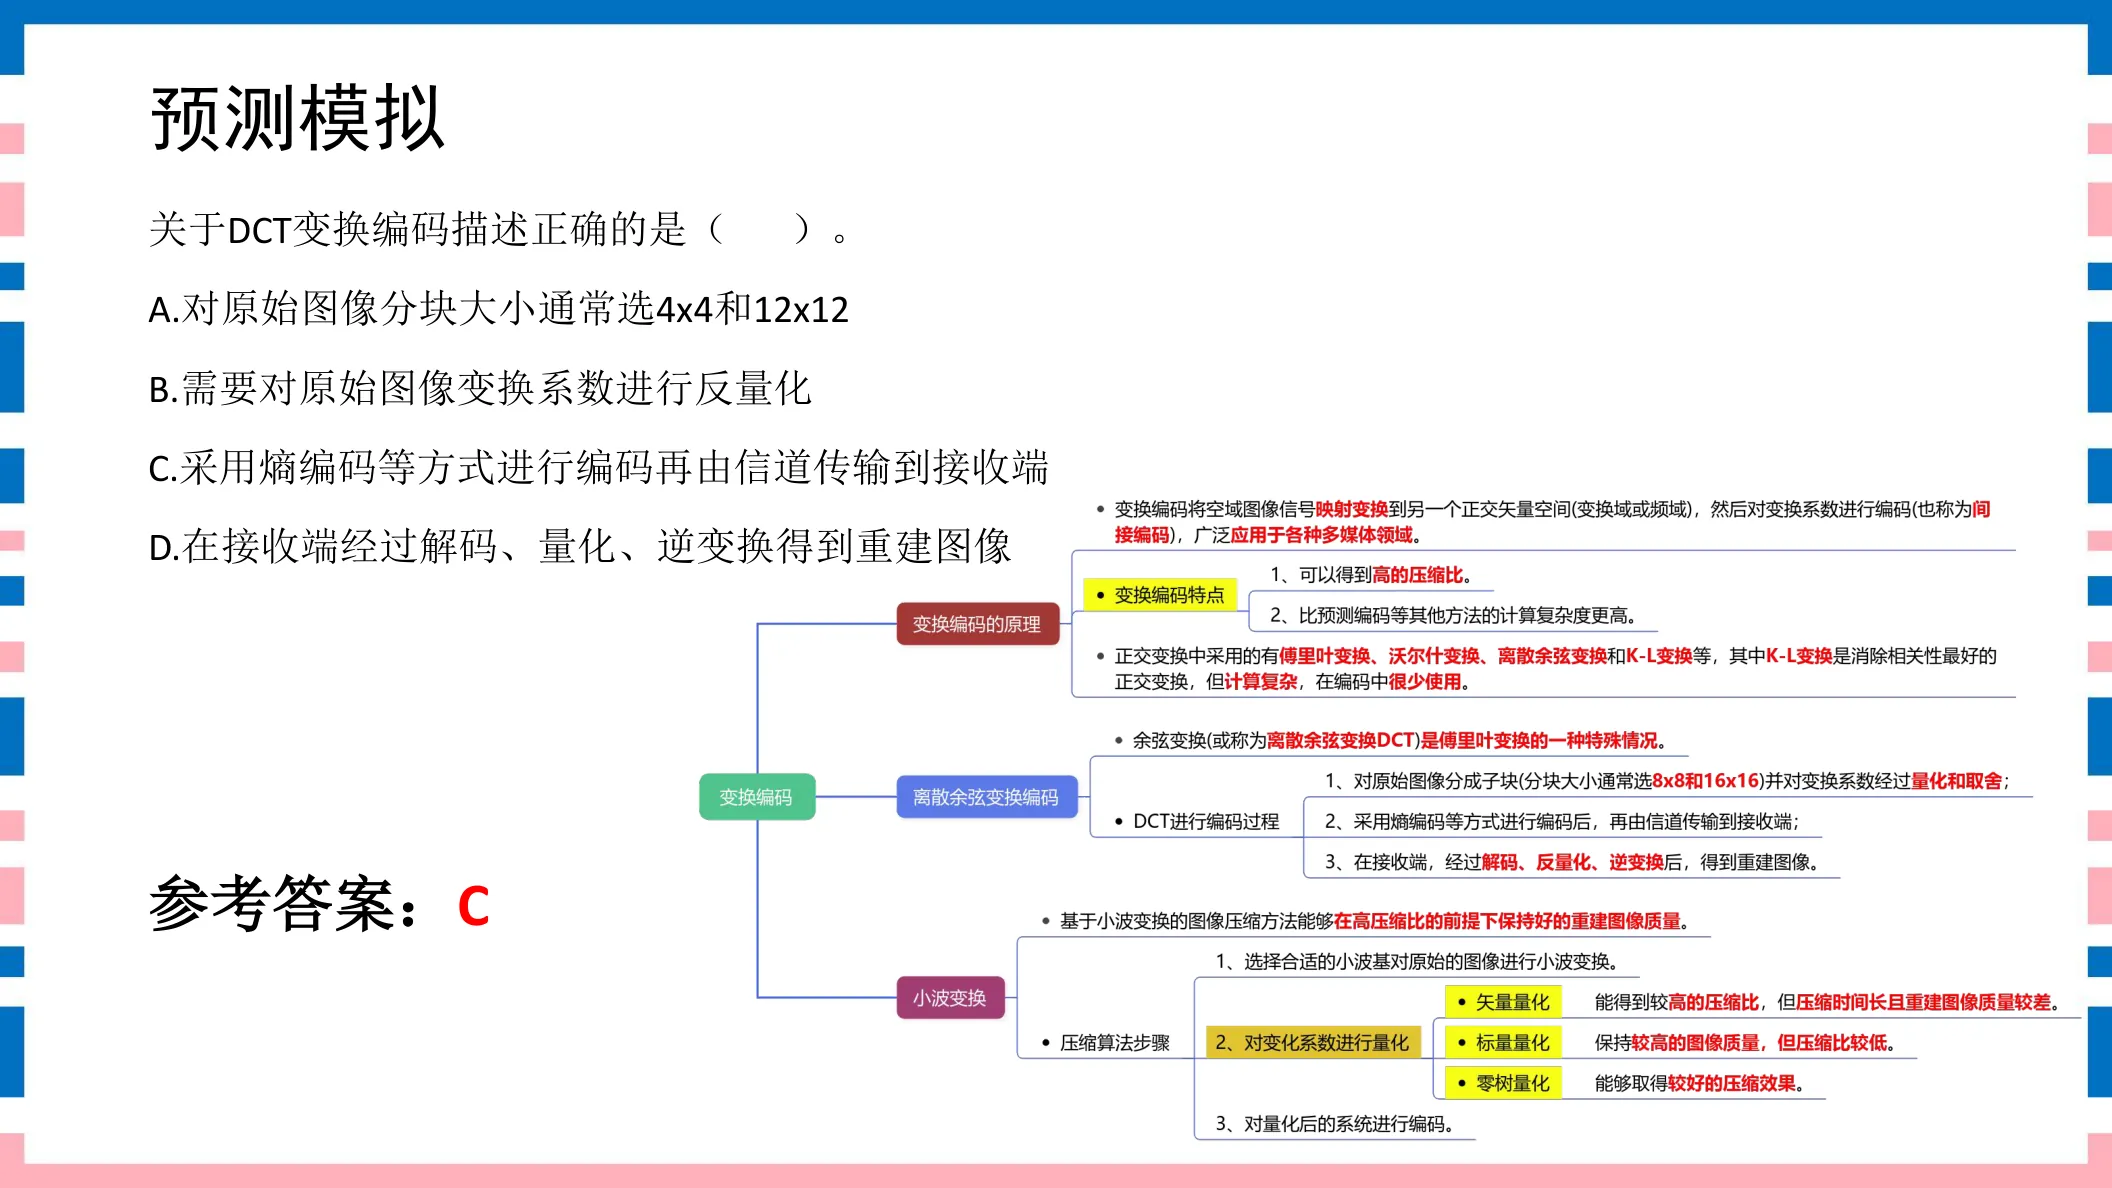
点击图片可弹层放大查看讲义原页
变换编码概念题 35–36 · 2 题
351分变换编码概念讲义第123页
下列选项中,属于变换编码最明显特点之一的是( )。A. 得到的压缩比较低B. 直接对空域图像信号编码C. 比预测编码等其他方法的计算复杂度高D. 因计算简单,正交变换中只采用K-L变换
参考答案:C
◆ 考点:变换编码先把空域信号变换到变换域再编码,计算复杂度比预测编码等方法高;它不直接对空域信号编码(讲义P121)。
◆ 判定:C“比预测编码等其他方法计算复杂度高”是变换编码最明显特点之一 → C。
⚠ 易错提示:变换编码代价=计算复杂度高;它在变换域(非空域)操作。“压缩比低/只采K-L”都是干扰。
🔗 关联题:第36题(同考点,建议对比记忆)
讲义原页对照 第123页 · 变换编码概念
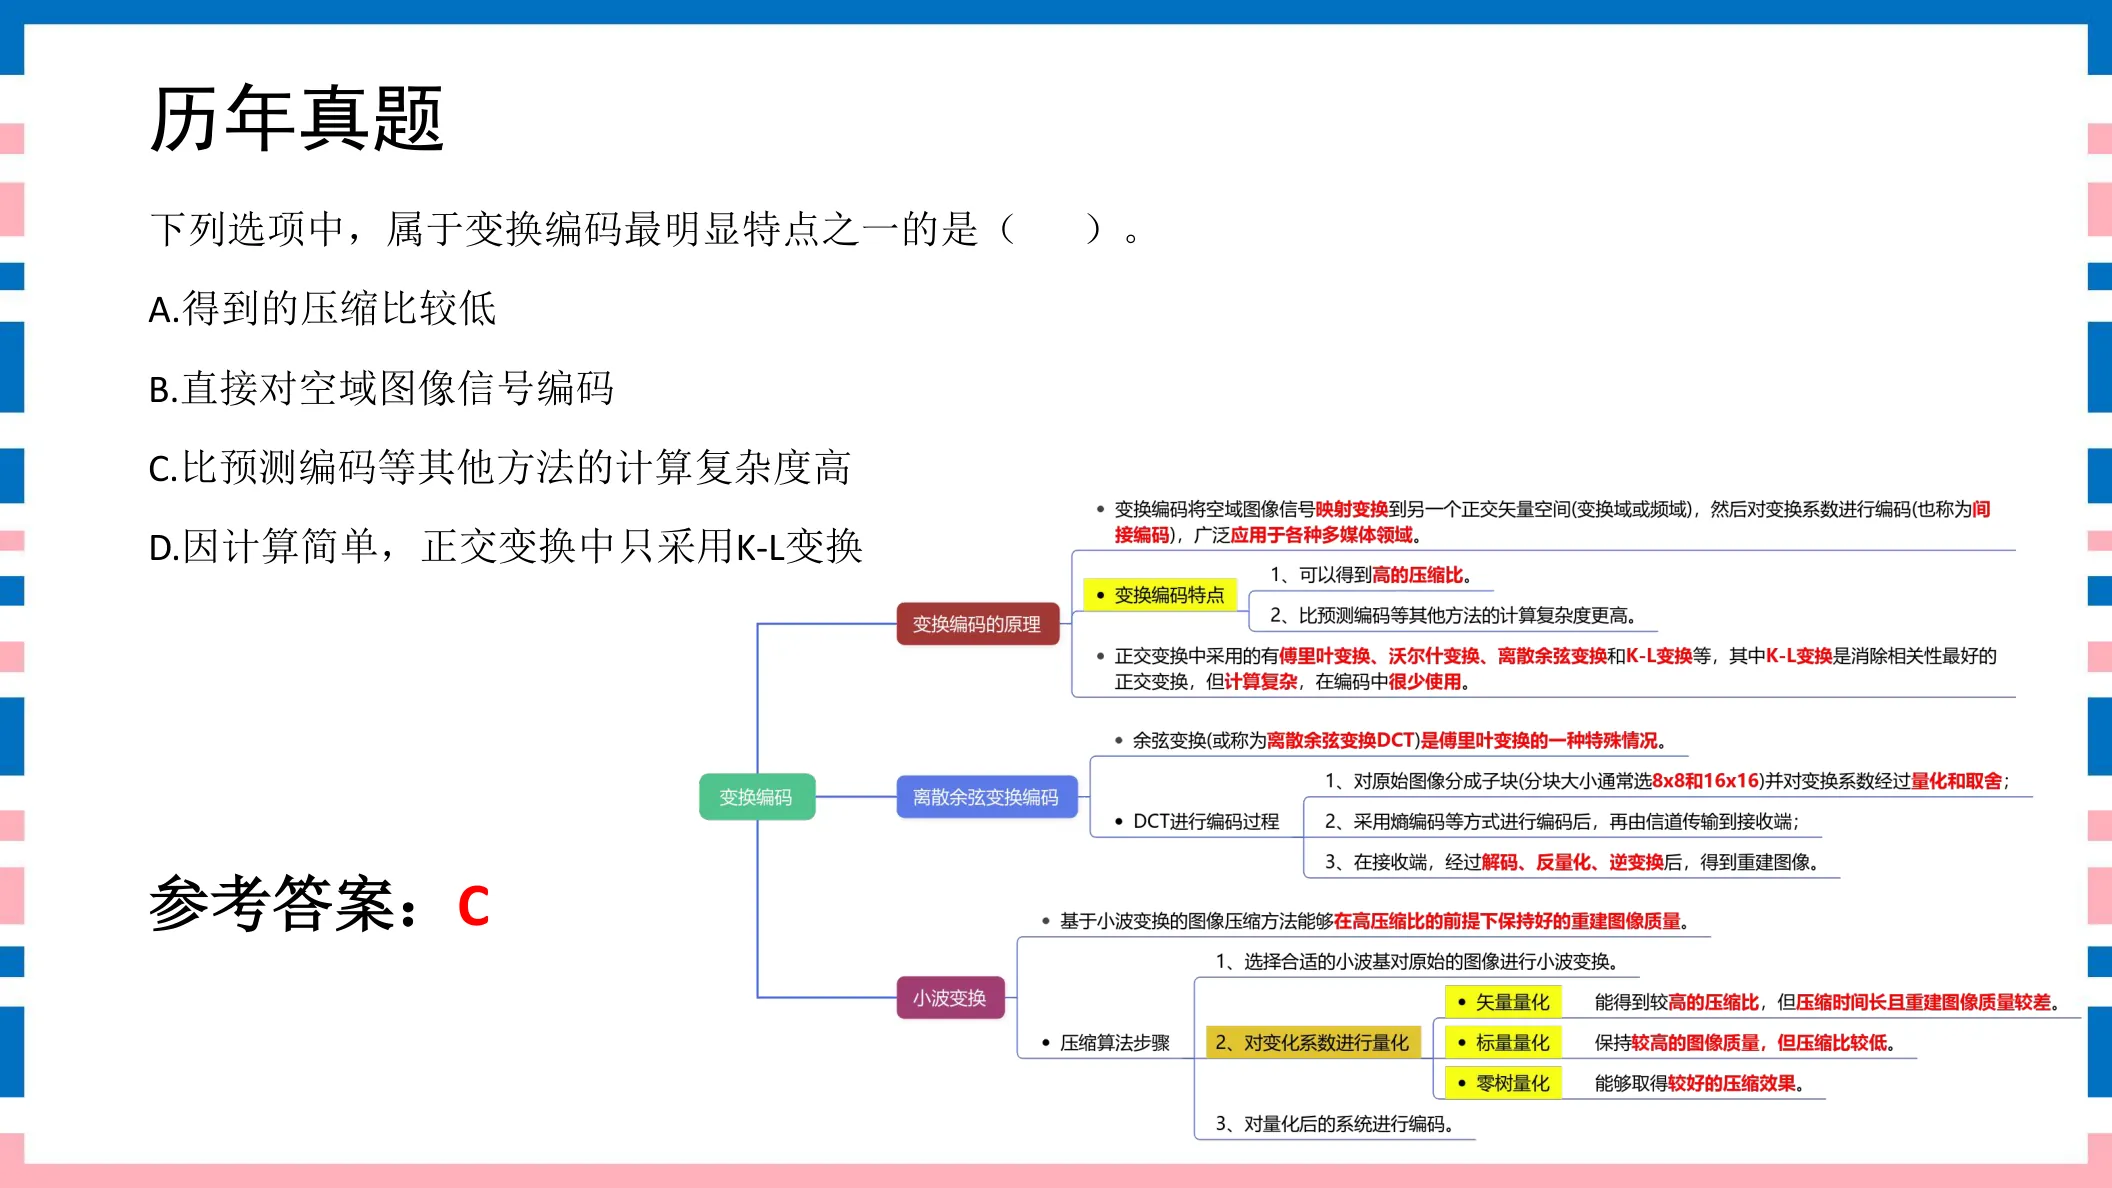
点击图片可弹层放大查看讲义原页
361分变换编码概念讲义第124页
以下关于变换编码的叙述中,正确的是( )。A. 变换编码属于信息熵编码B. 变换编码不能应用于视频信息的压缩编码中C. 变换编码是对相邻数据的差值进行编码D. 带有量化器的变换编码属于有损编码
参考答案:D
◆ 考点:变换编码对变换系数再量化编码,带量化器即属有损编码;它不是熵编码,可用于视频压缩;对相邻差值编码是预测编码(讲义P121)。
◆ 判定:D“带有量化器的变换编码属于有损编码”正确 → D。A(熵编码)、B(不能用于视频)、C(对差值编码=预测)均错。
⚠ 易错提示:和预测编码同一规律:有量化=有损。变换编码≠熵编码,可用于视频。
🔗 关联题:第35题(同考点,建议对比记忆)
讲义原页对照 第124页 · 变换编码概念
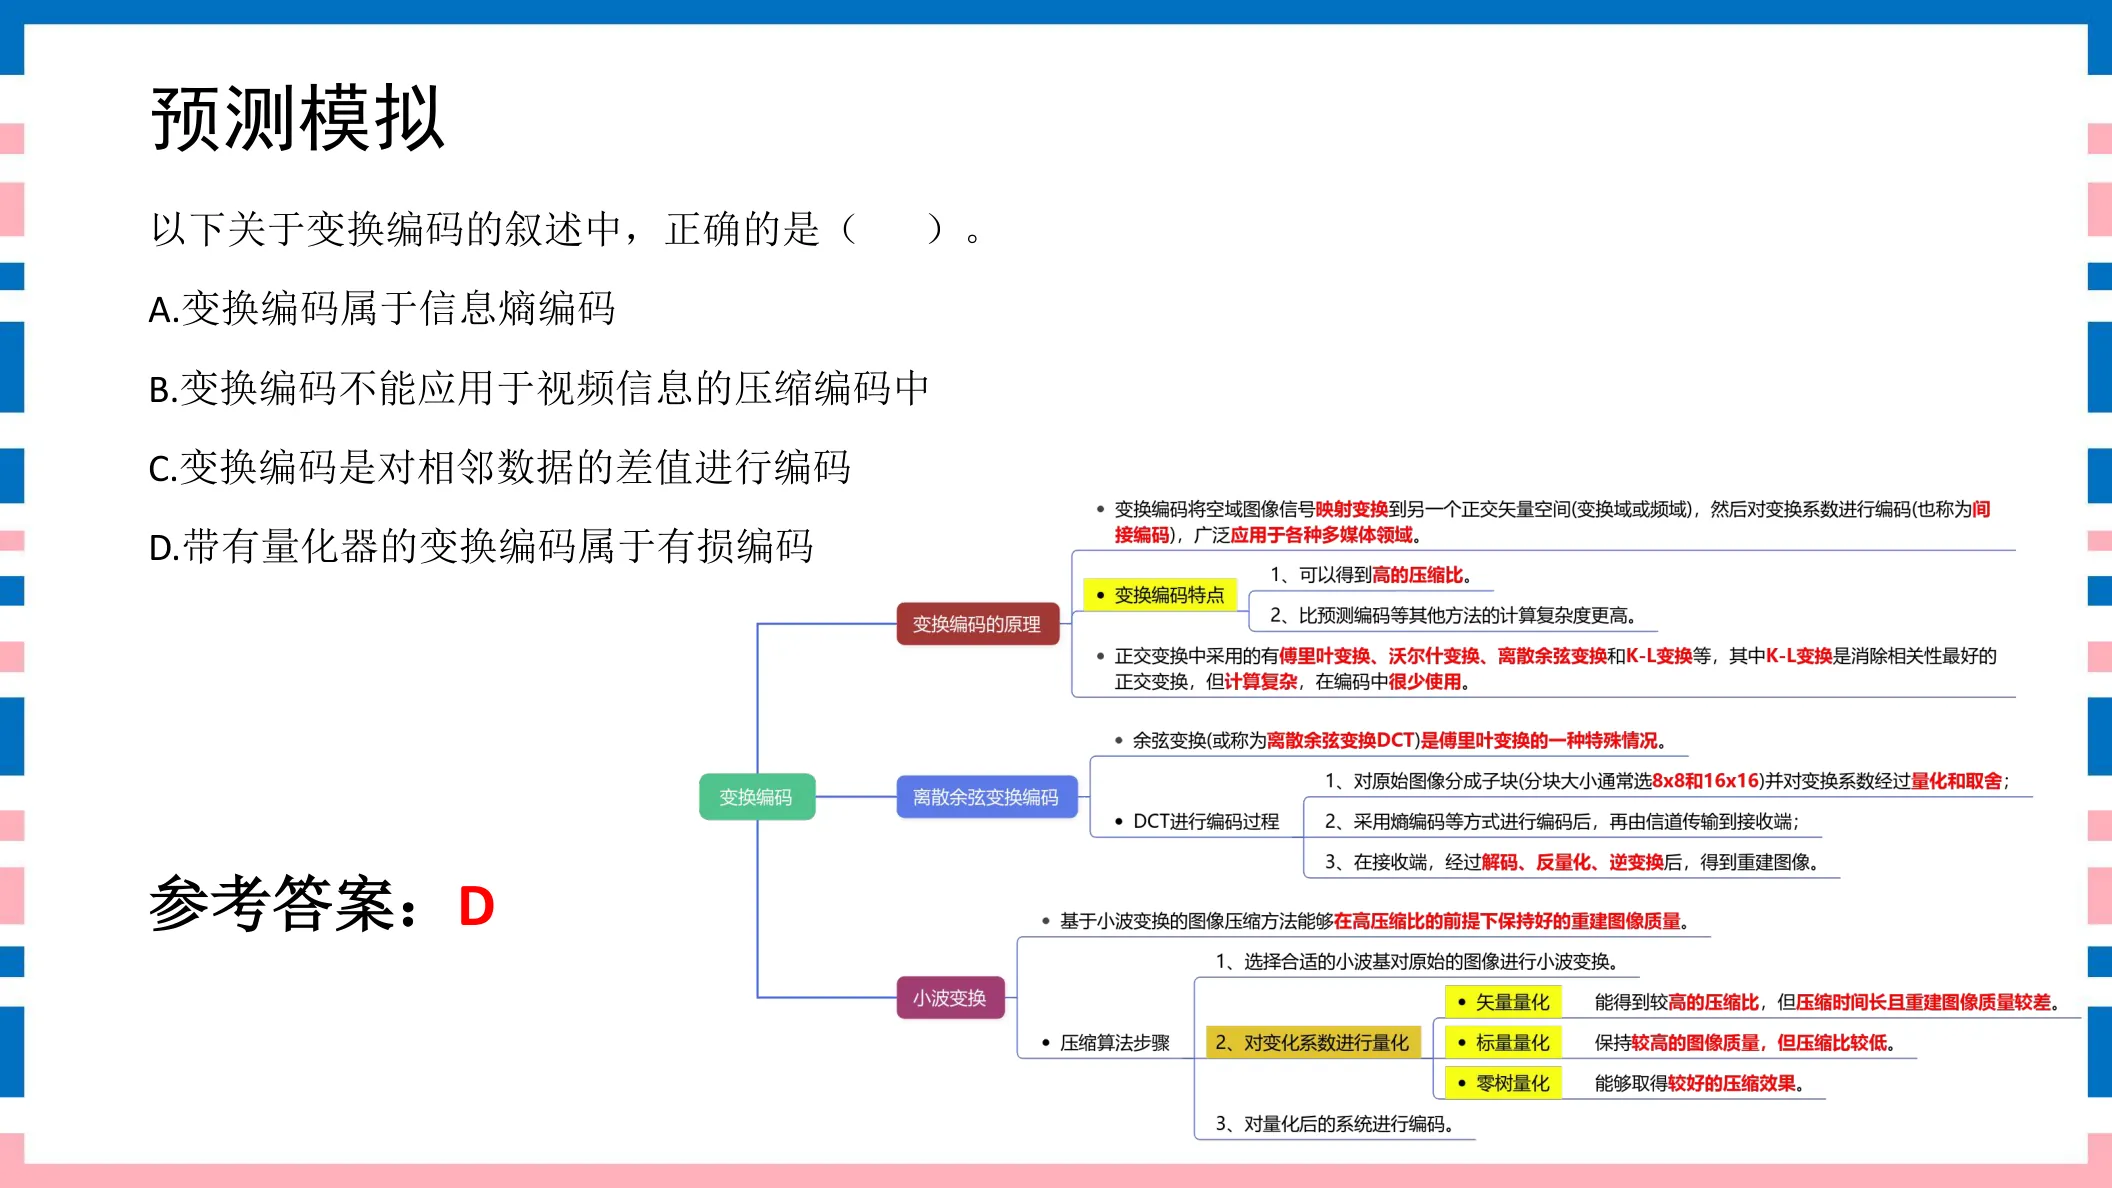
点击图片可弹层放大查看讲义原页
K-L变换题 37–38 · 2 题
371分K-L变换讲义第125页
下列变换编码方法中消除相关性最好的是( )。A. K-L变换B. DST变换C. DCT变换D. DFT变换
参考答案:A
◆ 考点:正交变换中,K-L(Karhunen-Loeve)变换消除相关性最好、是最佳正交变换,但计算复杂;DCT是实用最常用者(讲义P121)。
◆ 判定:消除相关性最好=K-L变换 → A。
⚠ 易错提示:消相关能力最强=K-L(理论最优);最常用=DCT。两者别混:考题问“最好/最有效”选K-L,问“常用”选DCT。
🔗 关联题:第38题(同考点,建议对比记忆)
讲义原页对照 第125页 · K-L变换
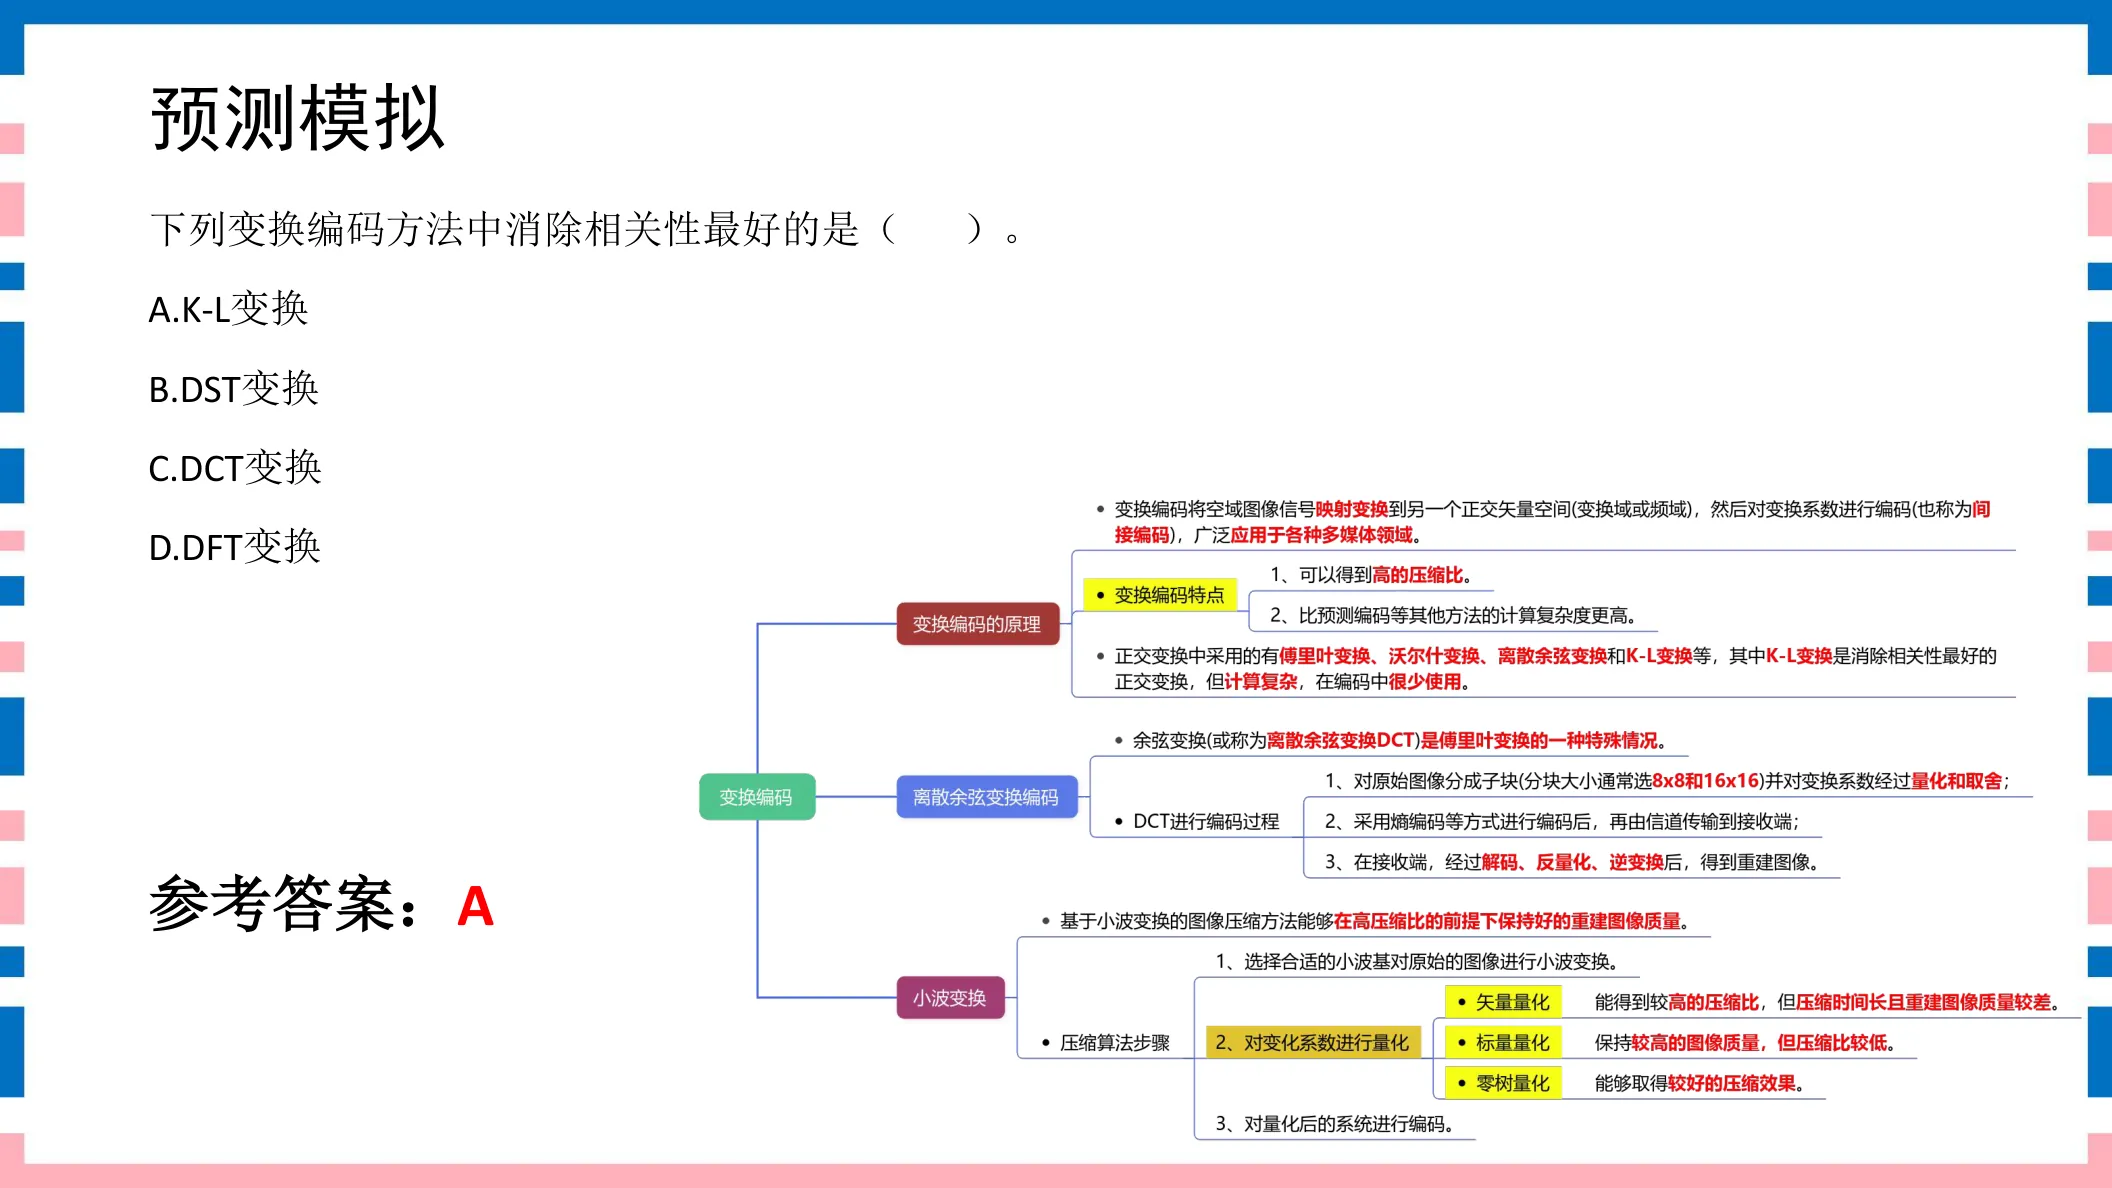
点击图片可弹层放大查看讲义原页
381分K-L变换讲义第126页
正交变换的种类很多,如傅里叶((Fouries)变换、余弦变换、K-L(Karhunen-Loeve)变换、哈尔(Har)变换、沃尔什(Walsh)变换等,其中( )是消除相关性最有效的变换。A. 傅里叶变换B. 余弦变换C. 沃尔什变换D. K-L变换
参考答案:D
◆ 考点:傅里叶、余弦、K-L、哈尔、沃尔什等正交变换中,K-L变换是消除相关性最有效的变换(讲义P126、P121)。
◆ 判定:消除相关性最有效=K-L变换 → D。
⚠ 易错提示:与第36题同考点:K-L=消相关最有效(最优但不实用);傅里叶/余弦/沃尔什都不是“最有效”。
🔗 关联题:第37题(同考点,建议对比记忆)
讲义原页对照 第126页 · K-L变换
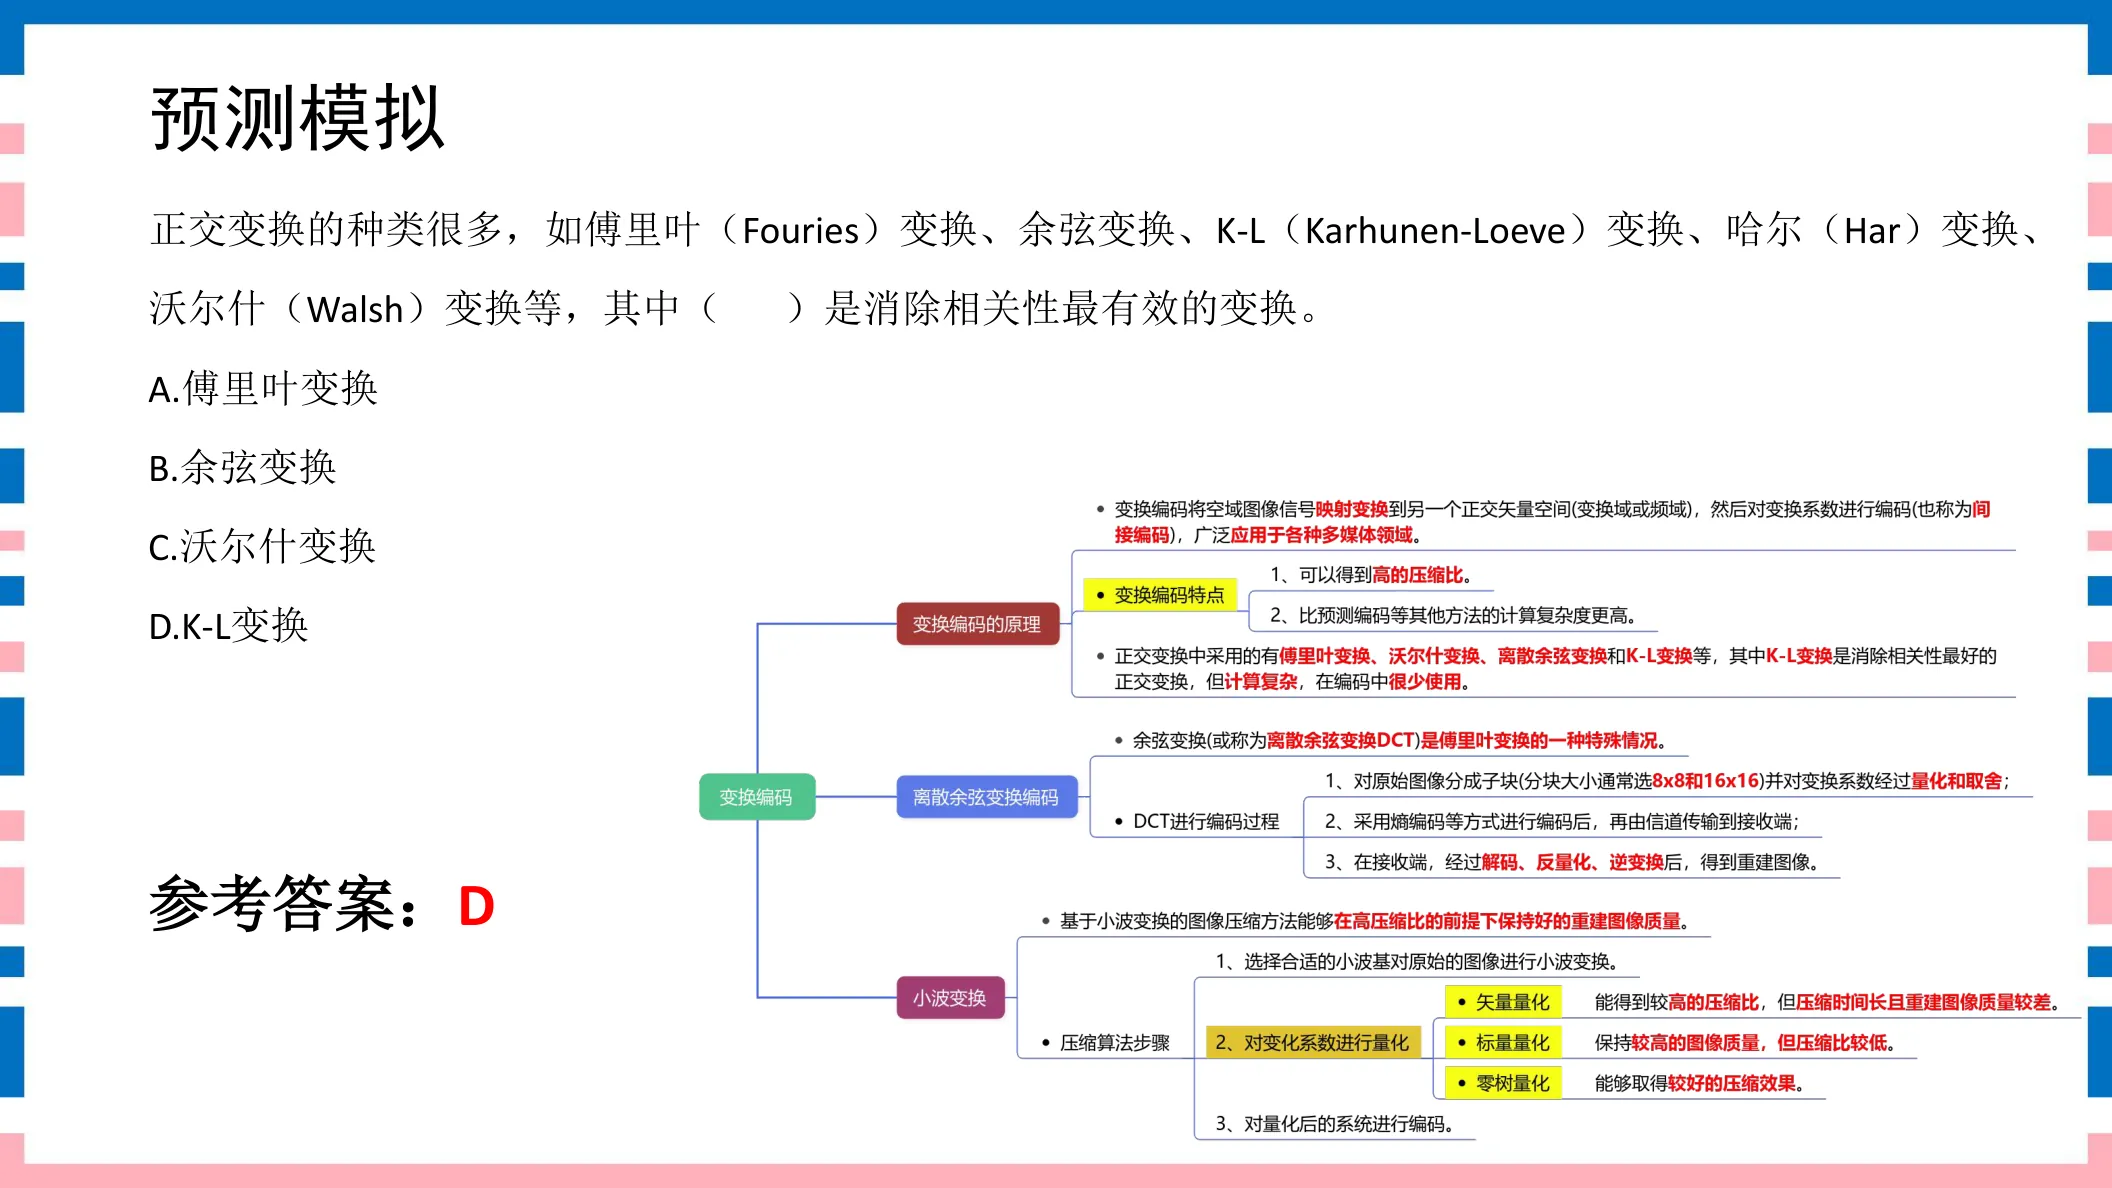
点击图片可弹层放大查看讲义原页
小波变换题 39–40 · 2 题
391分小波变换讲义第127页
下列变换编码方法中,基于( )的图像压缩方法能够在高压缩比的前提下保持好的重建图像质量。A. 傅里叶变换B. 小波变换C. 沃尔什变换D. K-L变换
参考答案:B
◆ 考点:小波变换多分辨率分析,能在高压缩比前提下仍保持较好的重建图像质量(讲义P121)。
◆ 判定:高压缩比下保持好质量=小波变换 → B。
⚠ 易错提示:“高压缩比+重建质量好”是小波变换的招牌;K-L虽最优但不实用,DCT做不到这么好。
🔗 关联题:第40题(同考点,建议对比记忆)
讲义原页对照 第127页 · 小波变换
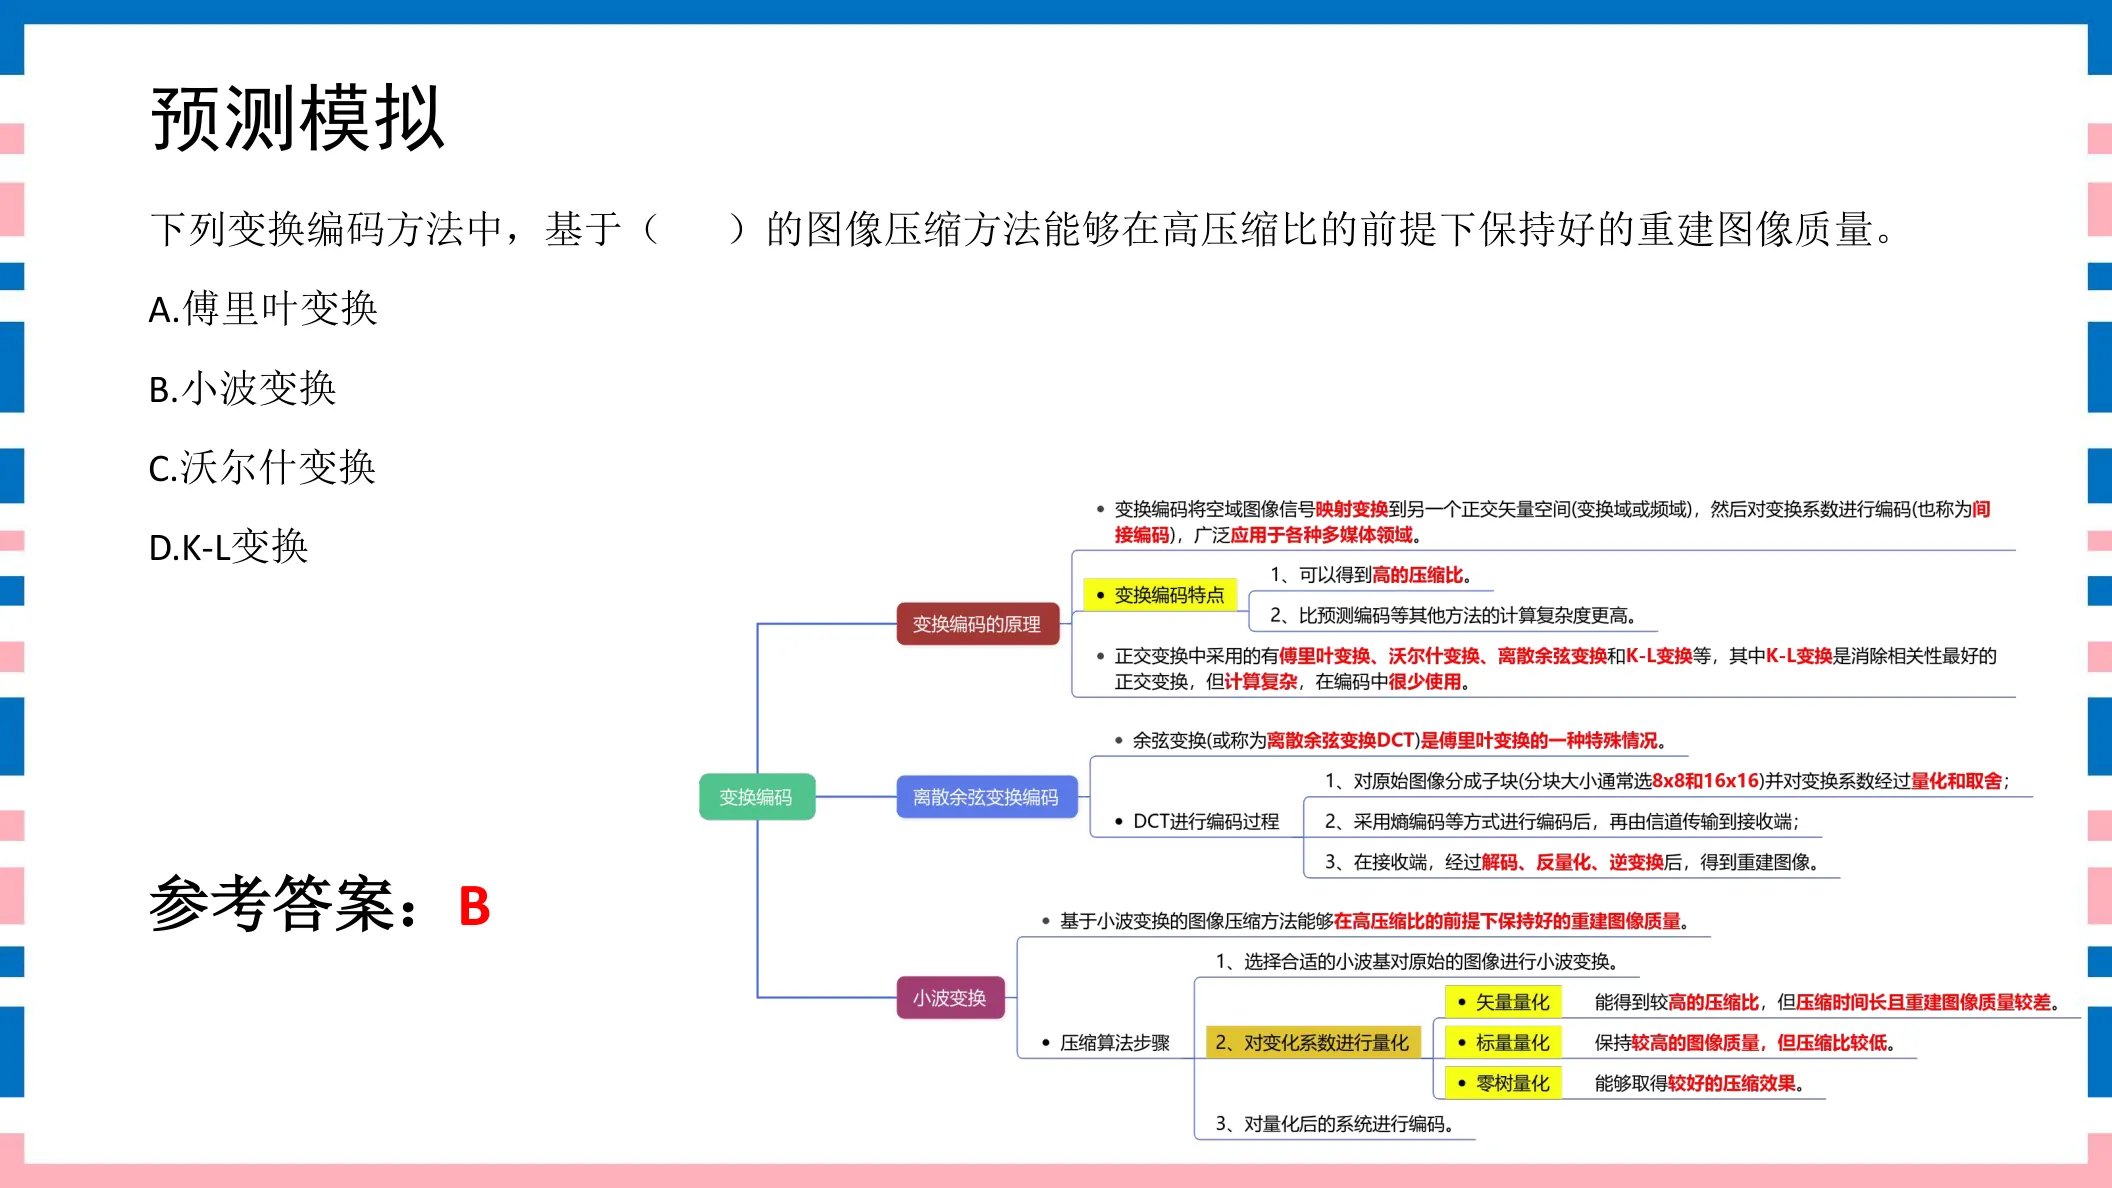
点击图片可弹层放大查看讲义原页
401分小波变换讲义第129页
下列关于小波变换描述正确的是( )。A. 基于小波变换的图像压缩方法不能在高压缩比的前提下重建图像质量B. 对变换系数进行矢量量化能够得到较高压缩比且重建图像质量较好C. 对变换系数进行标量量化能够得到较高的图像质量且压缩比较低D. 对变换系统进行零树量化得到的压缩效果很差
参考答案:C
◆ 考点:小波变换中,对变换系数标量量化可得到较高图像质量但压缩比较低;矢量量化可在较高压缩比下保持较好质量(讲义P129、P121)。
◆ 判定:C“标量量化得到较高图像质量且压缩比较低”与讲义一致 → C。
⚠ 易错提示:标量量化=质量高但压缩比低;矢量量化=压缩比高且质量较好,别把两者效果对调。
🔗 关联题:第39题(同考点,建议对比记忆)
讲义原页对照 第129页 · 小波变换
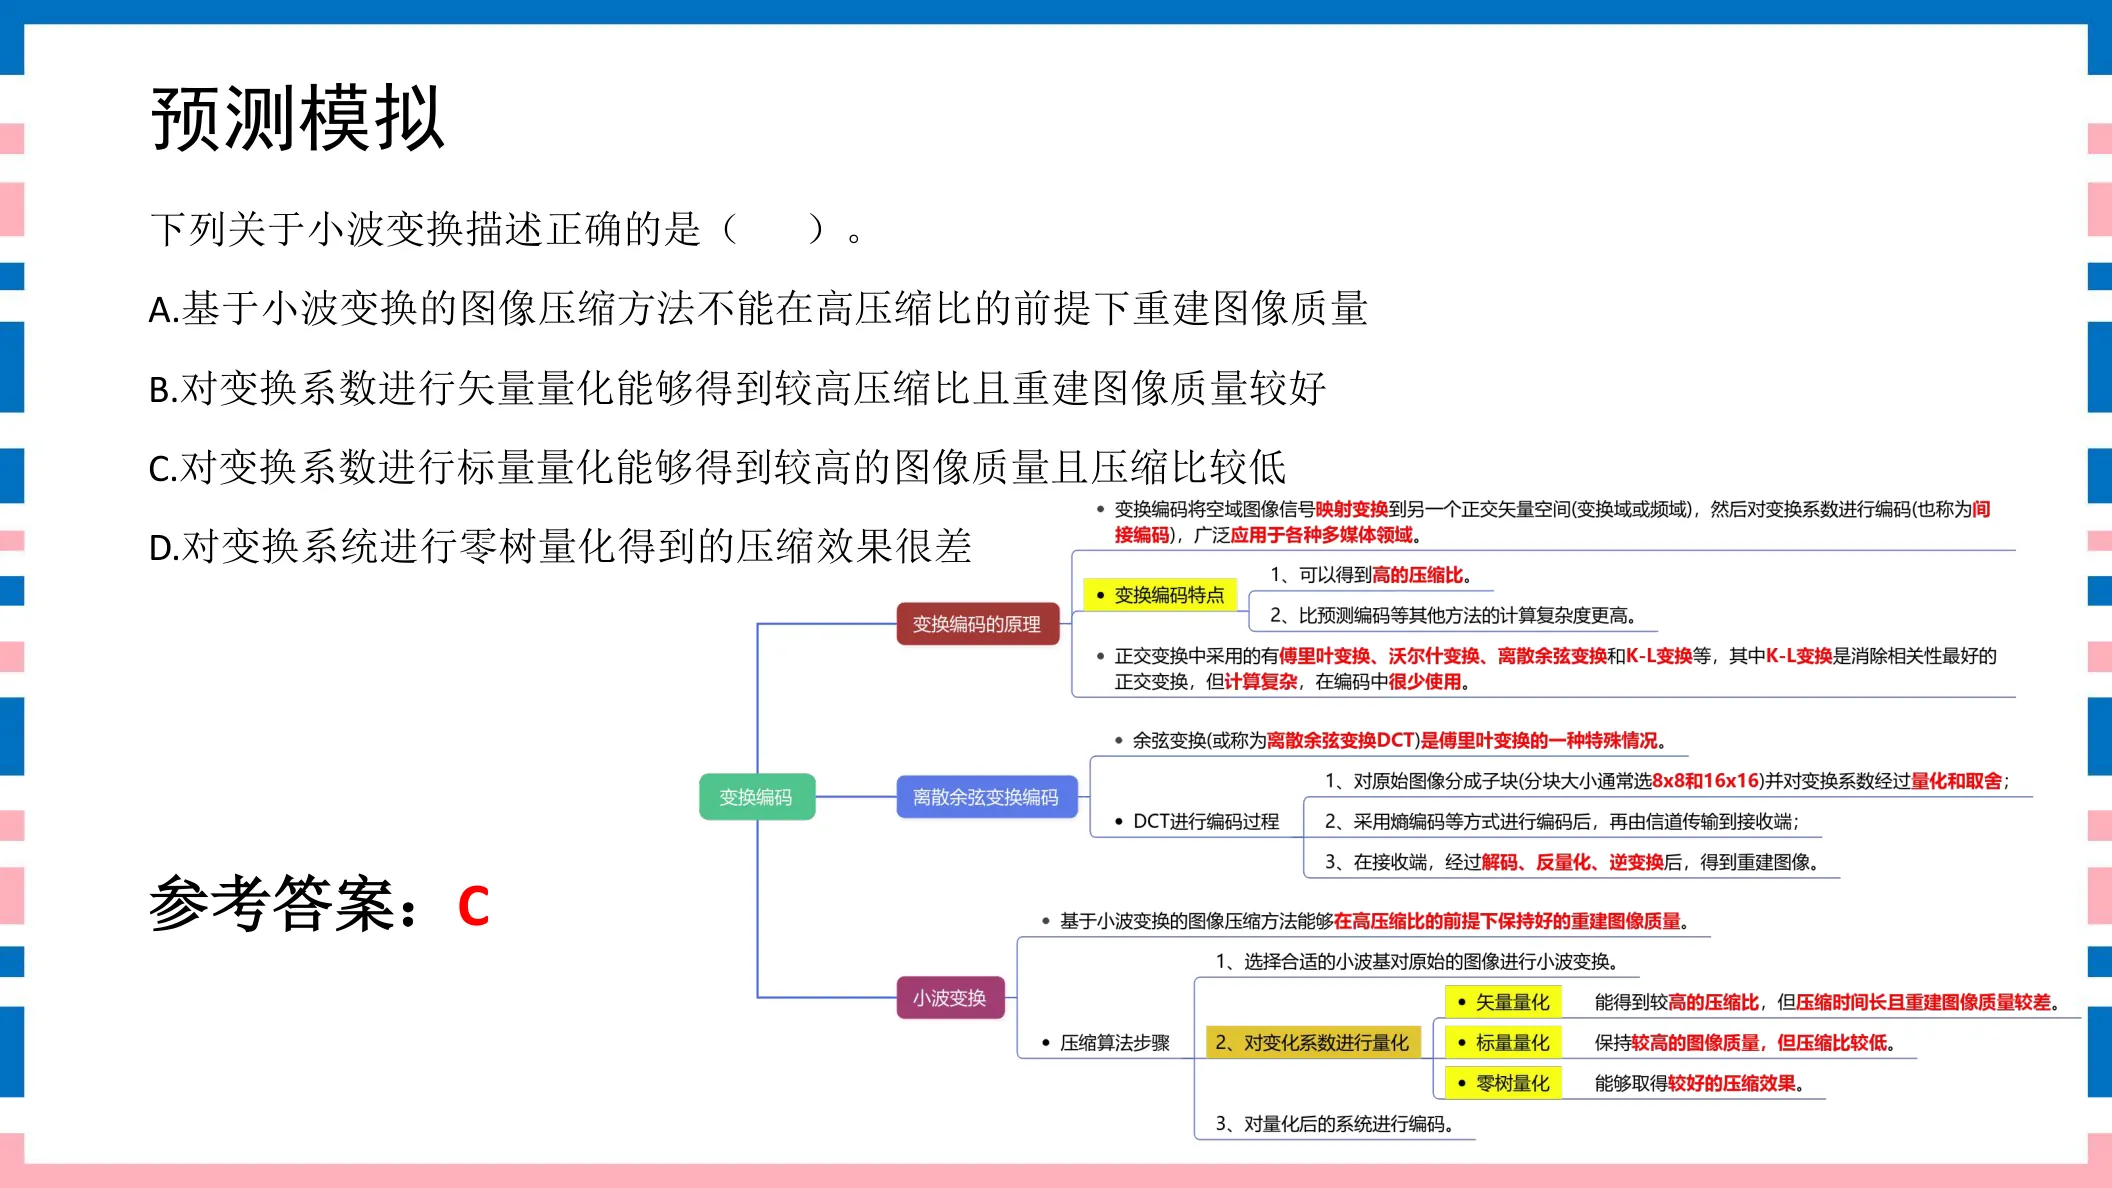
点击图片可弹层放大查看讲义原页
子带编码题 41–42 · 2 题
411分子带编码讲义第132页
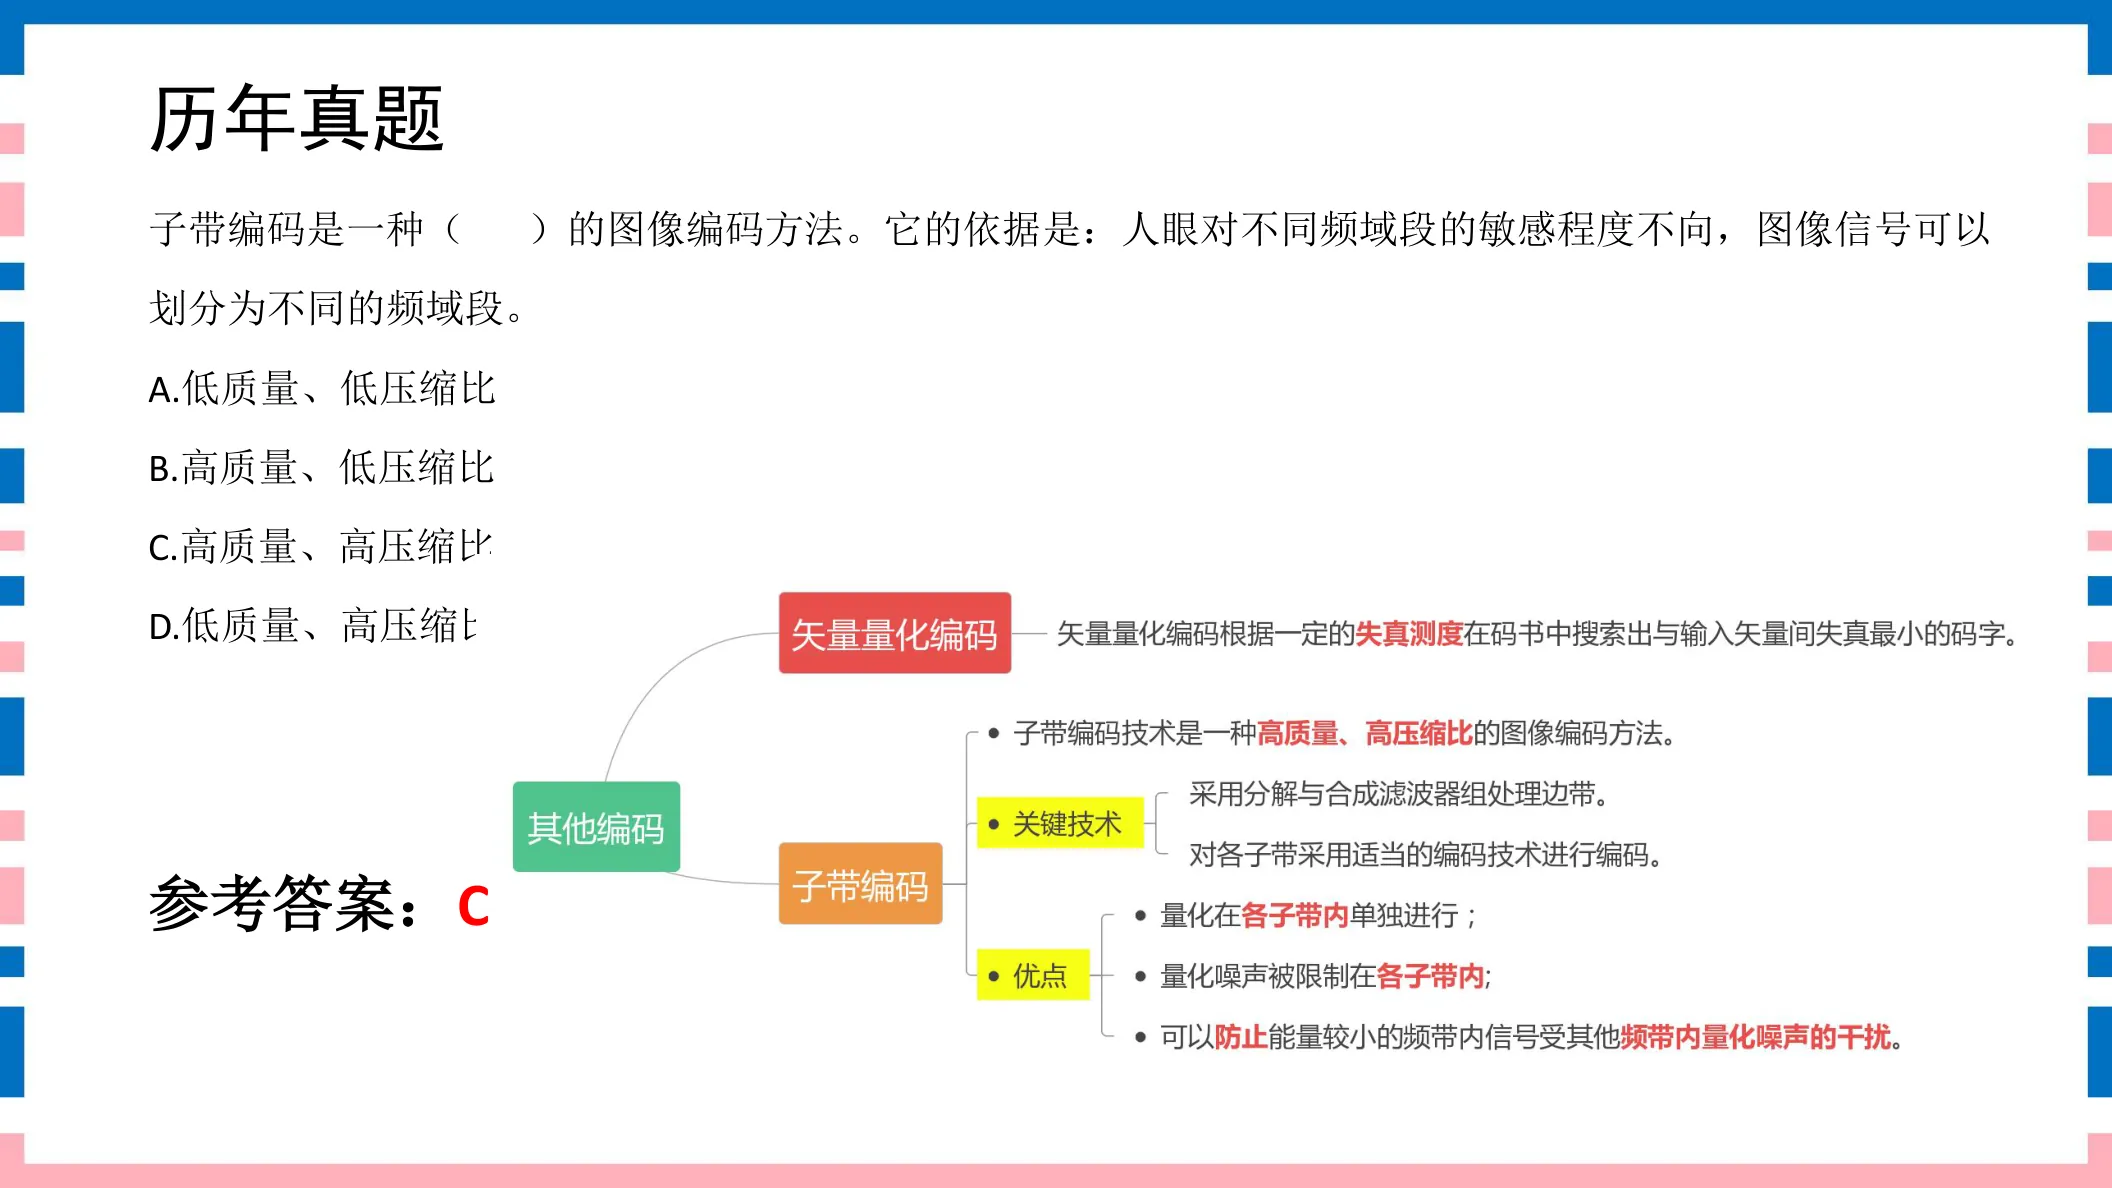
子带编码是一种( )的图像编码方法。它的依据是:人眼对不同频域段的敏感程度不向,图像信号可以划分为不同的频域段。A. 低质量、低压缩比B. 高质量、低压缩比C. 高质量、高压缩比D. 低质量、高压缩比
参考答案:C
◆ 考点:子带编码依据人眼对不同频域段敏感度不同,用滤波器组把图像划分为不同频带子带分别编码,是一种高质量、高压缩比的图像编码方法(讲义P131)。
◆ 判定:高质量、高压缩比 → C。
⚠ 易错提示:子带编码=高质量+高压缩比双高;依据是人眼对不同频段敏感度不同,用分解/合成滤波器组。
🔗 关联题:第42题(同考点,建议对比记忆)
讲义原页对照 第132页 · 子带编码
点击图片可弹层放大查看讲义原页
421分子带编码讲义第133页
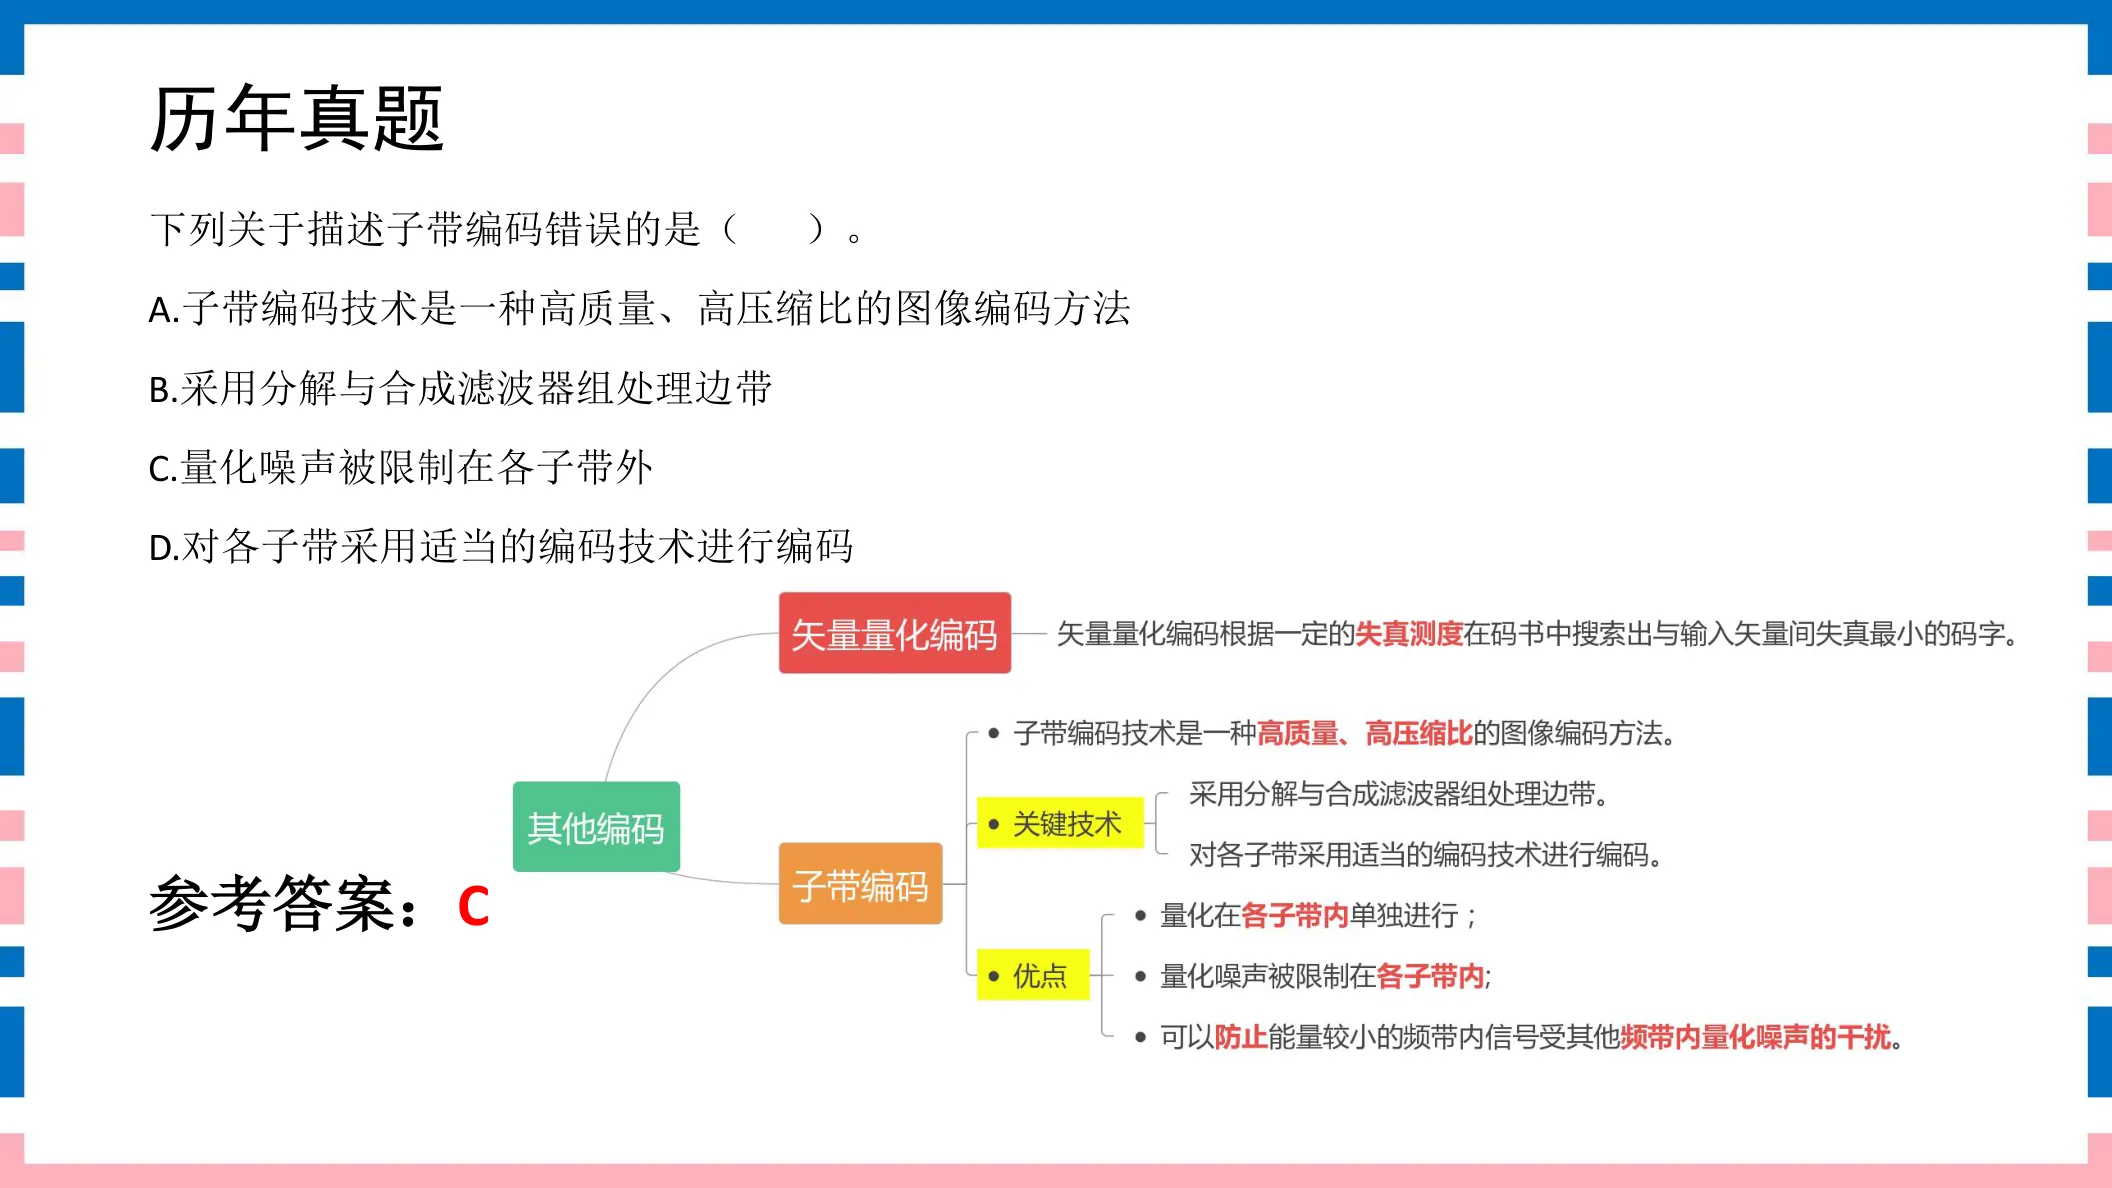
下列关于描述子带编码错误的是( )。A. 子带编码技术是一种高质量、高压缩比的图像编码方法B. 采用分解与合成滤波器组处理边带C. 量化噪声被限制在各子带外D. 对各子带采用适当的编码技术进行编码
参考答案:C
◆ 考点:子带编码用分解与合成滤波器组处理各子带,对各子带分别编码;量化噪声被限制在各自子带“内”(不串到别的子带)(讲义P132、P131)。
◆ 判定:C“量化噪声被限制在各子带外”错——应在各子带内 → C为错误项。A/B/D均正确。
⚠ 易错提示:方向别反:子带编码让量化噪声被限制在各子带“内”,不污染其他子带;说“外”就错。
🔗 关联题:第41题(同考点,建议对比记忆)
讲义原页对照 第133页 · 子带编码
点击图片可弹层放大查看讲义原页